Innhold Vis
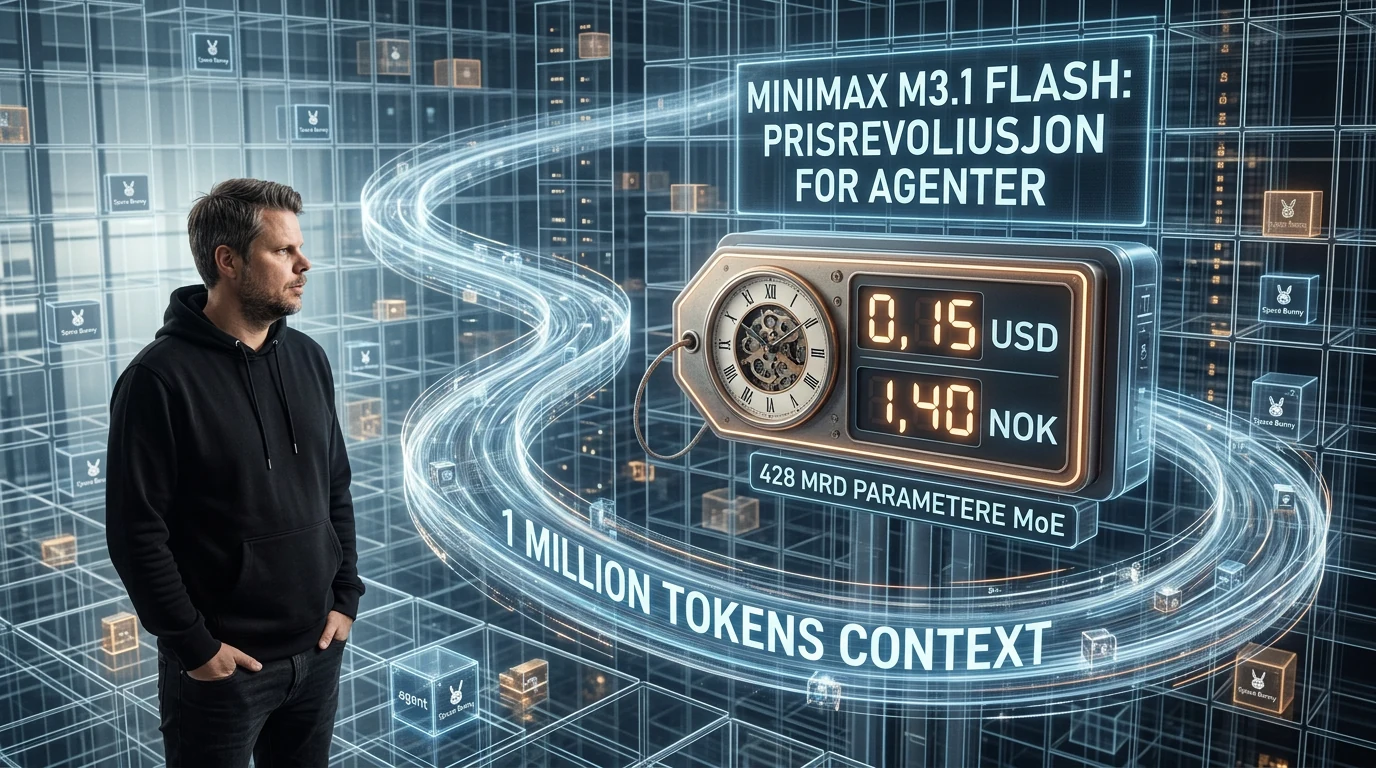
Hvis du bygger AI-agenter med mye kontekst og mange modellkall, er MiniMax M3.1 Flash en prisnyhet det er vanskelig å overse. Én million inputtokens koster 0,15 dollar, eller cirka 1,40 kroner med dollarkursen 20. oktober 2026. Utdata koster rundt 5,70 kroner per million tokens.
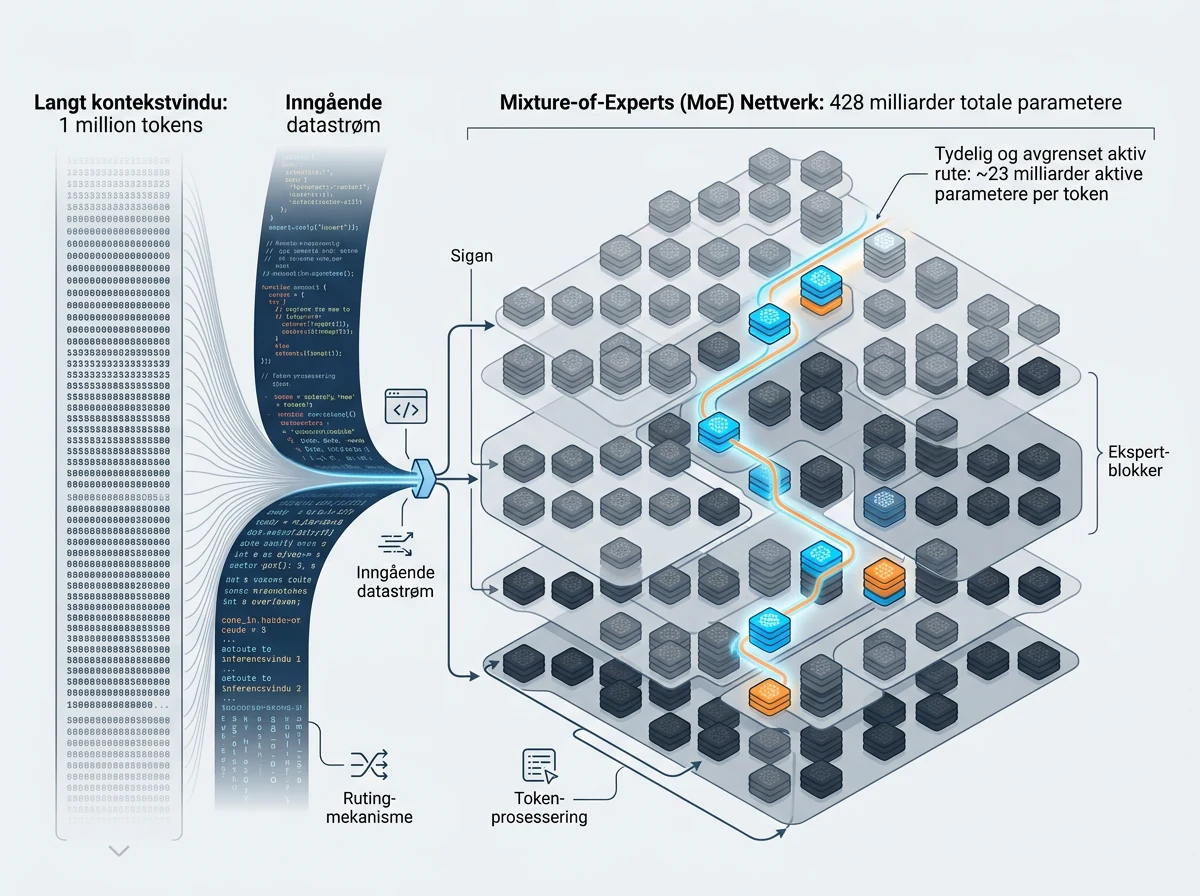
Det er ikke en liten modell MiniMax har priset som en lettvekter. M3.1 Flash har 428 milliarder parametere totalt, aktiverer omtrent 23 milliarder per token og tar inn tekst, bilder og video. Modellen er laget for koding, verktøybruk, kontoroppgaver og lange agentløp – akkurat den typen arbeid der tokenregningen kan vokse fort.
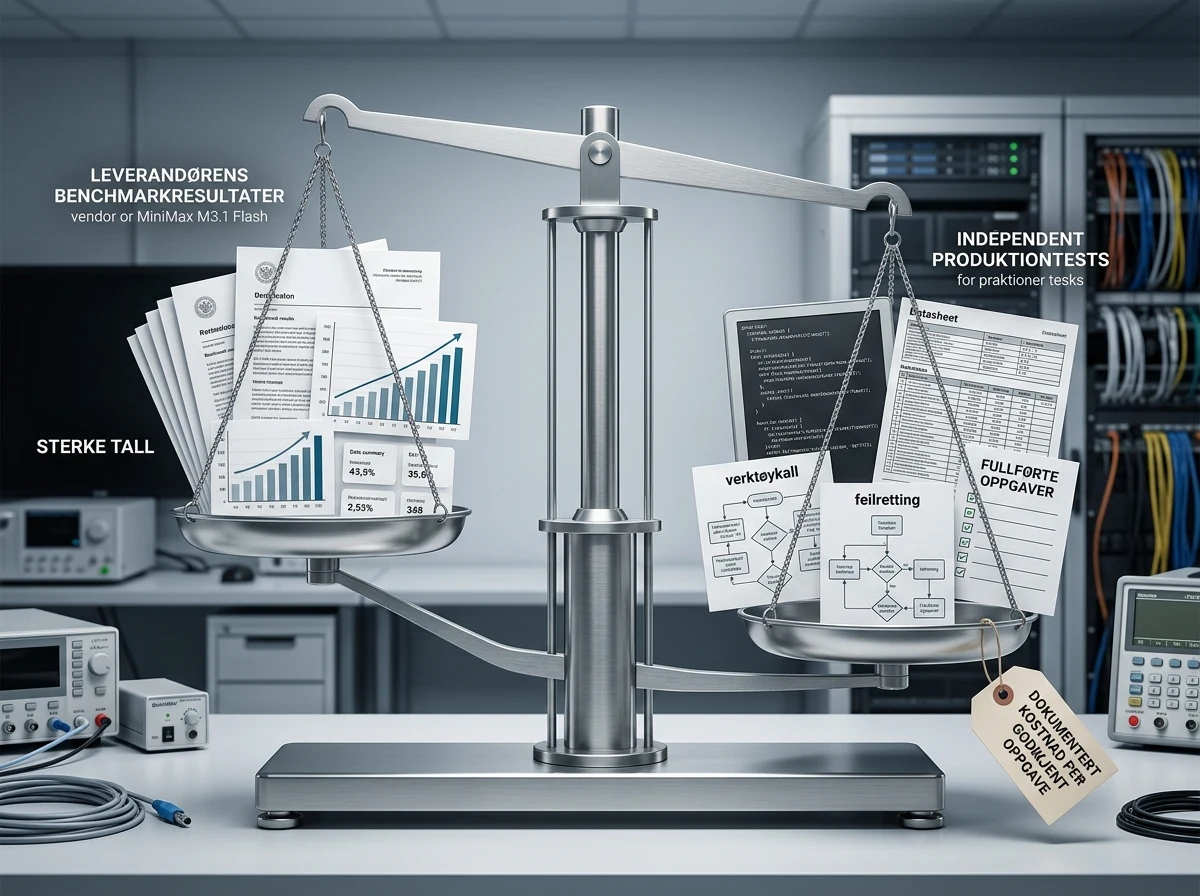
Jeg synes prisen er oppsiktsvekkende. Samtidig kommer ytelsestallene foreløpig fra MiniMax selv, og selskapet har ikke publisert en teknisk rapport som forklarer alle endringene fra M3. Billig er dokumentert. Hvor god modellen er i din arbeidsflyt, må fortsatt måles.
Hva er MiniMax M3.1 Flash?
MiniMax M3.1 Flash er en multimodal Mixture-of-Experts-modell for AI-agenter, koding og computer use. MiniMax oppgir 428 milliarder parametere totalt, rundt 23 milliarder aktive parametere og én million tokens kontekst. Den kan motta tekst, bilder og video, men leverer tekst som utdata.
Mixture-of-Experts betyr at modellen ikke bruker alle de 428 milliardene for hvert eneste token. Bare en mindre del av nettverket aktiveres om gangen. Det er en viktig del av forklaringen på hvordan en så stor modell kan levere høy fart og lavere kostnad enn om alle parameterne jobbet samtidig.
M3.1 Flash bygger videre på MiniMax M3 med lang kontekst og åpne vekter, men Flash-utgaven er optimalisert mer aggressivt for effektiv inferens. MiniMax sier at hastigheten i vanlig bruk kan passere 200 tokens i sekundet, med en median over 170 tokens i sekundet. Det er leverandørens egne tall, og faktisk fart vil avhenge av belastning, kontekstlengde og valgt resonneringsnivå.
Hvor billig er API-et?
MiniMax tar 0,15 dollar per million vanlige inputtokens, 0,60 dollar per million outputtokens og 0,015 dollar per million bufrede inputtokens. Prislisten i lanseringsmeldingen tilsvarer cirka 1,40 kroner for input, 5,70 kroner for utdata og 14 øre for bufret input med en kurs på omtrent 9,43 kroner per dollar.
Et enkelt regneeksempel gjør prisnivået lettere å forstå. En agentjobb som bruker 100 000 inputtokens og produserer 10 000 outputtokens, koster 0,021 dollar før eventuell caching. Det er omtrent 20 øre. Gjør du den samme jobben 1 000 ganger, blir modellkostnaden rundt 200 kroner.
Den virkelige regningen avhenger likevel av mer enn én forespørsel. Agenter kan lese store filer flere ganger, kalle verktøy, prøve på nytt og sende stadig lengre historikk tilbake til modellen. En billig tokenpris hjelper mye, men en agent som går i ring er fortsatt dyrere enn en dyrere modell som løser oppgaven på første forsøk.
Det er derfor jeg heller vil se kostnad per fullført oppgave enn pris per million tokens. MiniMax sier at den samlede brukskostnaden for agentoppgaver er redusert med 70 prosent fra forgjengeren. Påstanden er interessant, men må testes med samme oppgave, samme verktøy og samme krav til kvalitet før den får avgjøre et modellbytte.
Hva kan modellen gjøre i praksis?
M3.1 Flash er først og fremst laget for flertrinnsoppgaver der modellen må forstå et mål, bruke verktøy og holde orden på resultatene underveis. MiniMax trekker fram arbeidsflyter på tvers av salgsverktøy, markedsføring, drift, kundeservice, økonomi og HR. Modellen er også rettet mot programvareutvikling, bruk av grafiske grensesnitt og sikkerhetsarbeid.
Den lange konteksten er nyttig når en agent skal arbeide med en stor kodebase, mange dokumenter eller en lang samtalehistorikk. Én million tokens er likevel en kapasitet, ikke et løfte om at modellen finner den riktige detaljen like pålitelig over hele vinduet. Mer kontekst kan dessuten gi mer støy og en større regning dersom du sender inn alt bare fordi du kan.
Bildene og videoene brukes som input til analyse. M3.1 Flash er altså ikke en modell som lager bilder eller video. Den kan for eksempel lese et skjermbilde, sammenligne visuelle elementer eller tolke innhold fra en video som del av en større arbeidsflyt, og så svare med tekst eller bruke et tilgjengelig verktøy.
MiniMax har allerede latt en tidlig utgave arbeide under navnet Space Bunny. Ifølge selskapet behandlet den anonyme modellen mer enn 200 billioner tokens. Det viser at modellen har vært brukt i stor skala før navnet ble offentlig, men volumet sier ikke i seg selv hvor mange oppgaver som ble løst riktig.
Hva viser benchmarkene – og hva viser de ikke?
MiniMax rapporterer 76,2 poeng på BankerToolBench, 73,7 prosent på DeepSWE v1.1 og 61,7 poeng på OSWorld V2. Selskapet oppgir også 82 prosent på CyberGym. MarkTechPost peker samtidig på at M3.1 Flash gjør det svært sterkt på kontorautomatisering, men mer blandet på krevende terminaloppgaver.
Det er en nyttig korreksjon til den vanlige lanseringsglansen. En agentmodell kan være god til å holde orden på regneark, dokumenter og SaaS-verktøy uten å være best til alt som foregår i en terminal. «Agentisk» er ikke én evne. Det er en samling av planlegging, verktøybruk, feilretting, hukommelse og vurderinger over mange steg.
Alle de sentrale resultatene er dessuten rapportert av MiniMax. Det finnes foreløpig ingen bred, uavhengig gjentakelse av testene for den ferdige M3.1 Flash-utgaven. Jeg bruker derfor tallene til å forstå hva modellen er laget for, ikke til å erklære den som vinner.
Det samme gjaldt da MiniMax M2.5 presset prisene på AI-koding. Lave priser betyr noe, men de blir først virkelig verdifulle når modellen fullfører arbeidet med få nok feil, omveier og menneskelige rettelser.
Hva må utviklere endre fra MiniMax M3?
Resonnering er alltid aktivert i M3.1 Flash. Utviklere kan velge nivåene Low, Medium, High, Xhigh og Max, og MiniMax anbefaler Max som standard. Det gir mer kontroll over hvor mye arbeid modellen skal legge i en oppgave, men det påvirker også svartid og tokenbruk.
Dette er ikke bare et nytt modellnavn i en eksisterende integrasjon. Kall som sender thinking.type=disabled eller effort=none, vil gi feil. Resonneringsinnholdet kommer i det separate feltet reasoning_content, og feltet kan mangle. Integrasjoner som leter etter <think>-tagger i vanlig svartekst, må derfor oppdateres.
Du bør også sette av nok plass til både resonnering og det endelige svaret. Et stort kontekstvindu betyr ikke at hele tokenbudsjettet er tilgjengelig for lange sluttresultater uten planlegging. Test parsing, verktøykall og feilbehandling før du lar modellen overta en eksisterende M3-arbeidsflyt.
Når kommer de åpne vektene?
MiniMax M3.1 Flash er tilgjengelig nå gjennom MiniMax API, M Plan og MiniMax Code. Det finnes også en ratebegrenset gratisvariant på OpenRouter, som gjør det enkelt å prøve modellen i en avgrenset arbeidsflyt. MarkTechPost oppgir at modellvektene skal slippes 23. oktober 2026, mens den offisielle nettsaken bare sier at de kommer senere. Inntil filene faktisk er publisert med lisens og dokumentasjon, bør 23. oktober behandles som en varslet dato – ikke som en ferdig lokal utgave.
Åpne vekter er ekstra interessante for en modell med 428 milliarder parametere, men de betyr ikke at dette blir en enkel modell å kjøre hjemme. MiniMax har foreløpig ikke oppgitt konkrete maskinvarekrav for egen drift av M3.1 Flash. Rundt 23 milliarder aktive parametere reduserer beregningsarbeidet per token, men hele modellen må fortsatt lagres og fordeles på egnet maskinvare.
Det store spørsmålet blir derfor ikke bare om filene kan lastes ned. Lisensen, kvantiseringene, minnekravene og ytelsen hos uavhengige leverandører vil avgjøre hvor praktisk den åpne utgaven blir. API-et er klart nå. Lokal drift er fortsatt et løfte som må få faktiske filer rundt seg.
Bør du bytte modell nå?
Ikke bytt en produksjonsagent bare fordi 0,15 dollar ser pent ut i en pristabell. Velg én avgrenset arbeidsflyt, logg antall modellkall og mål hvor mange oppgaver som faktisk blir godkjent uten manuell reparasjon. Sammenlign så total tokenbruk, svartid og kostnad mot modellen du allerede bruker.
For oppgaver med store dokumentmengder, multimodalt input eller mange agentrunder er M3.1 Flash absolutt verdt en kontrollert prøve. Den kan bli spesielt interessant for små bedrifter og utviklere som har latt være å automatisere lange arbeidsflyter fordi modellkostnaden ble for høy. Konkurransen mellom raske og billige kodemodeller har allerede vist hvor fort regnestykket kan endre seg.
Min foreløpige dom er enkel: MiniMax har levert en reell prisbombe, ikke et bevis på at M3.1 Flash er best. Hvis uavhengige tester bekrefter at modellen løser lange agentoppgaver med få omveier, blir kombinasjonen av én million tokens kontekst og priser målt i småkroner vanskelig for konkurrentene å ignorere.
Ofte stilte spørsmål
Hva koster MiniMax M3.1 Flash per million tokens?
MiniMax tar 0,15 dollar for én million inputtokens, 0,60 dollar for én million outputtokens og 0,015 dollar for bufret input. Med dollarkursen 20. oktober 2026 er det cirka 1,40 kroner, 5,70 kroner og 14 øre.
Kan MiniMax M3.1 Flash kjøre lokalt?
Ikke ennå. API-et er tilgjengelig, og modellvektene er varslet til 23. oktober 2026. Maskinvarekrav, lisens og praktiske kvantiseringer er foreløpig ikke dokumentert godt nok til å si hva som kreves for lokal drift.
Kan M3.1 Flash lage bilder og video?
Nei. Modellen kan ta imot tekst, bilder og video som input, men leverer tekst. Den kan analysere visuelt materiale og bruke resultatet i en agentarbeidsflyt, men den er ikke en bilde- eller videogenerator.
Er MiniMax M3.1 Flash bedre enn de største konkurrentene?
Det er for tidlig å fastslå. MiniMax viser sterke resultater på flere agenttester, men tallene kommer hovedsakelig fra selskapet selv. Uavhengige tester på reelle arbeidsflyter må bekrefte kvalitet, fart og kostnad per fullført oppgave.