Innhold Vis
OpenAI har offentliggjort 722 matematikkmanuskripter fra en intern AI-modell, og flere av resultatene kan være historiske. Samlingen omfatter 372 familier av beslektede resultater, fra tallteori til teoretisk informatikk. Blant dem ligger et påstått bevis for quasi-Riemann-hypotesen og en rekke andre problemer matematikere har arbeidet med i flere tiår.
Dette er ikke enda en modell som får litt høyere poengsum på en mattebenchmark. Her ligger faktiske manuskripter, bevismateriale og formaliseringer ute til faglig kontroll. Om de sterkeste resultatene holder, er vi vitne til et voldsomt skifte i hva AI kan bidra med i forskning. Det er vanskelig å overdrive hvor stort det kan være.
Men det er ett ord som må stå støtt gjennom hele saken: kan. OpenAI har publisert forskningsmanuskripter, ikke 722 ferdig godkjente matematiske sannheter. Nå begynner den langsomme, nådeløse jobben der andre matematikere skal lete etter hull, kontrollere hvert avgjørende steg og finne ut hvilke påstander som faktisk blir stående.
Hva inneholder OpenAIs 722 matematikkarbeider?
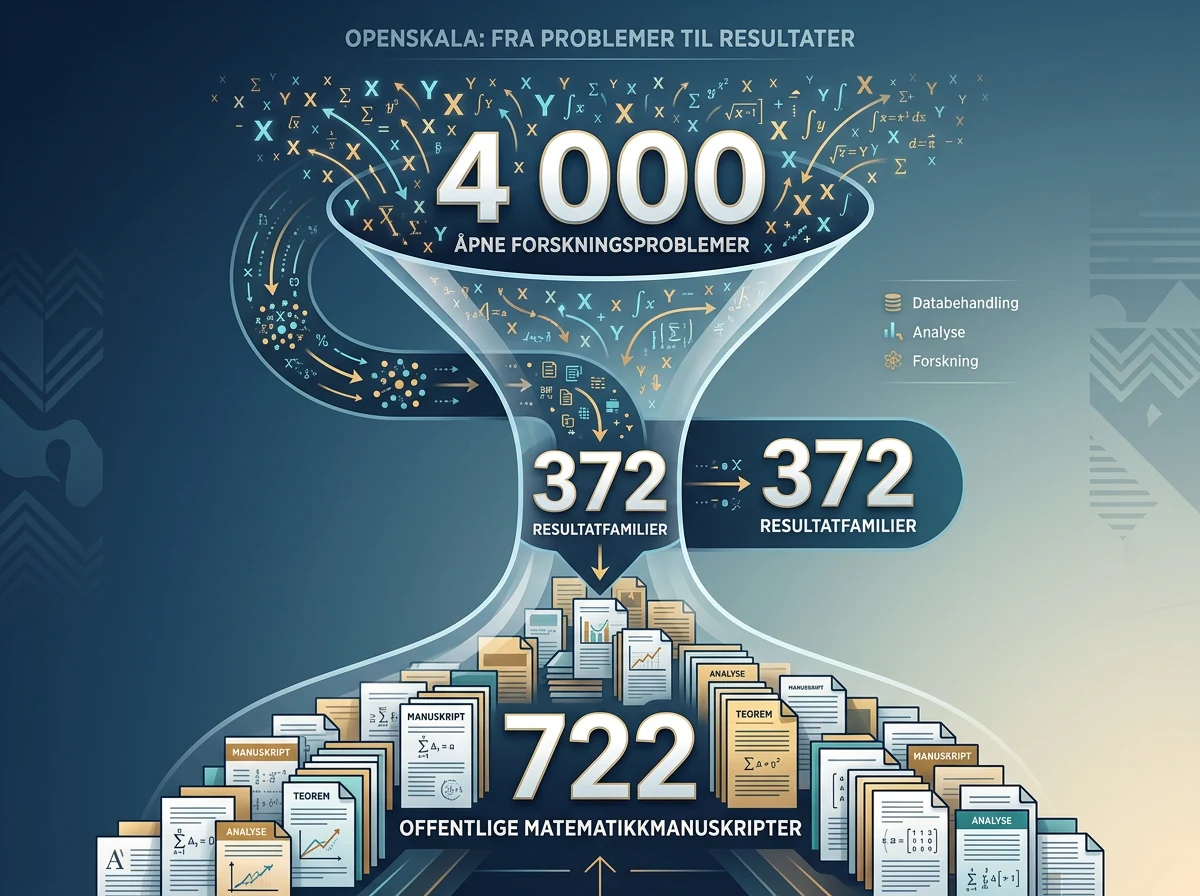
OpenAI publiserte 6. oktober 2026 en samling på 722 manuskripter fordelt på 372 resultatfamilier. Ifølge OpenAIs egen kunngjøring ble resultatene laget av en intern frontiermodell som selskapet ennå ikke har gitt ut.
Modellen fikk omtrent 4 000 åpne forskningsproblemer. Etter utvelgelse, gruppering og krav til betydning endte materialet som den enorme samlingen som nå ligger offentlig. OpenAI oppgir at et gjennomsnittlig resultat brukte regnekraft tilsvarende omtrent tre timer med ChatGPT Pro-tenking. Det er et oppsiktsvekkende lavt tall når alternativet kan være flere år av et forskerliv.
Det tallet må likevel brukes presist. OpenAI skriver selv at arbeidet med den nullfrie regionen for Riemanns zetafunksjon var blant unntakene fra standardprosedyren. Den alternative teksten om grensen 11/12 ble også redigert av mennesker for lesbarhet. Det er derfor feil å slå fast at akkurat quasi-Riemann-resultatet bare krevde tre timer og ingen menneskelig bearbeiding.
Hvorfor er quasi-Riemann-resultatet så stort?
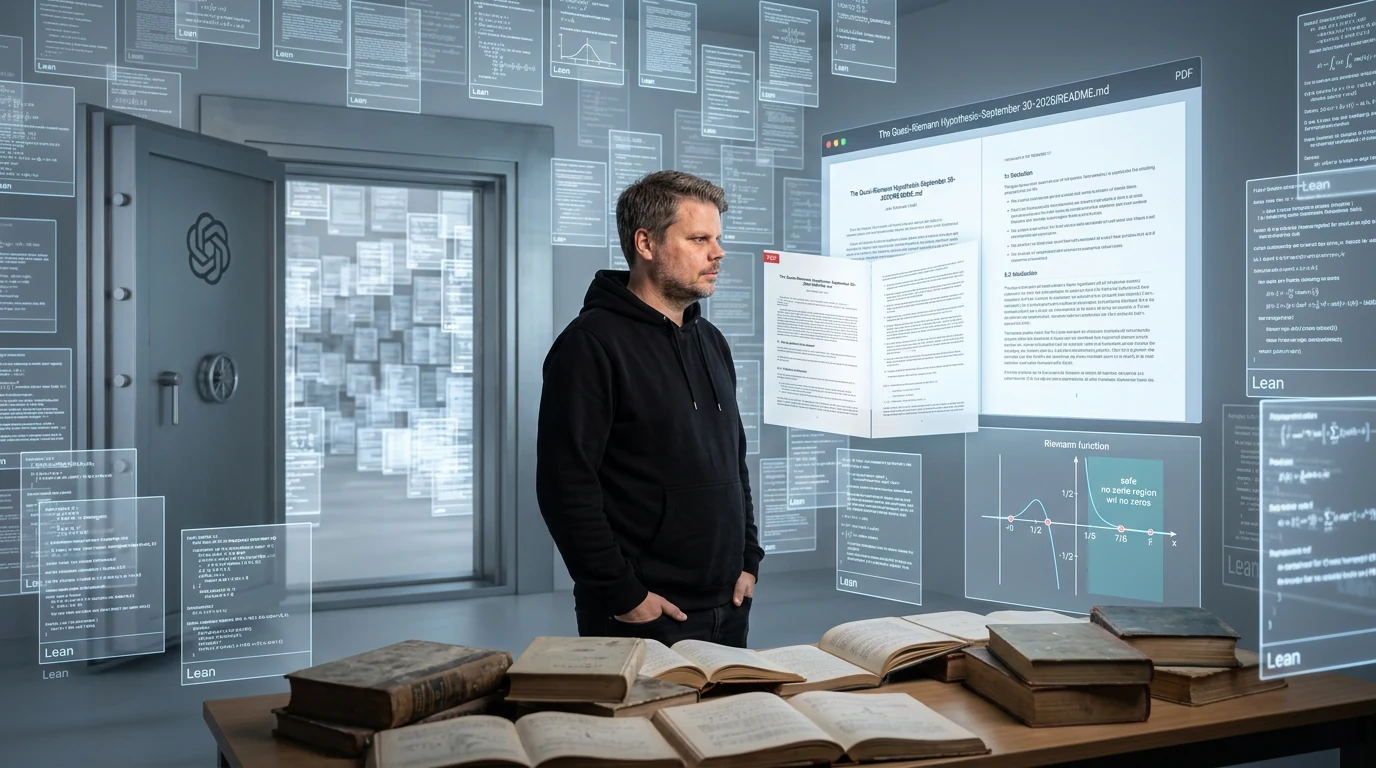
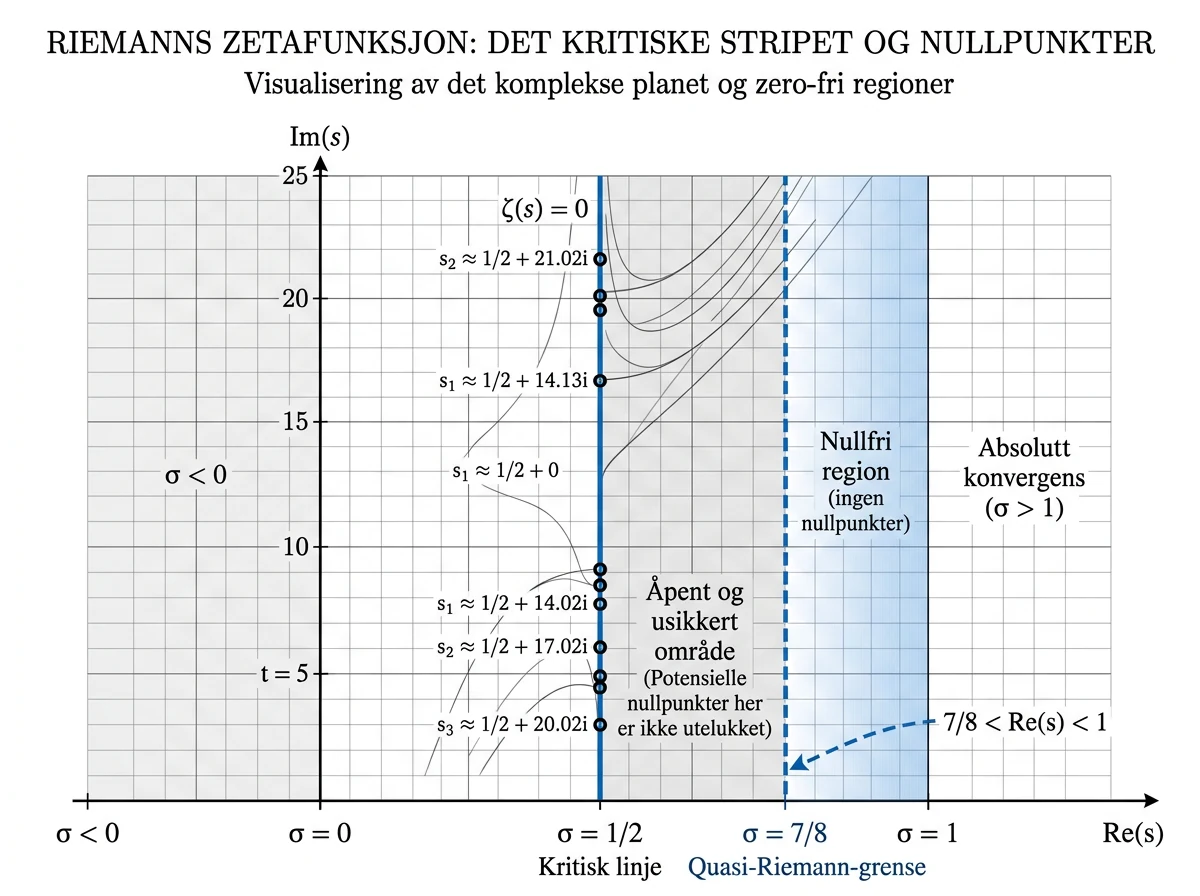
Det nye manuskriptet hevder at Dirichlet L-funksjoner, inkludert Riemanns zetafunksjon, ikke har nullpunkter når realdelen er større enn 7/8. OpenAIs manuskriptoversikt beskriver dette som et bevis for quasi-Riemann-hypotesen.
For alle som ikke har tallteori til frokost: Riemann-hypotesen handler om hvor bestemte nullpunkter i zetafunksjonen ligger. Den fulle hypotesen sier at de ikke-trivielle nullpunktene ligger på linjen med realdel 1/2. OpenAIs resultat hevder ikke å bevise dette. Det utelukker nullpunkter i området til høyre for 7/8.
Det etterlater fortsatt sonen mellom 1/2 og 7/8. Quasi-Riemann er derfor ikke Riemann-hypotesen med et fiffig nytt navn. Det er et svakere resultat. Likevel vil en slik universell grense være et enormt sprang i tallteori dersom beviset holder. Samlingen inneholder også et alternativt bevis med grensen 11/12, men 7/8 er sterkere fordi det utelukker nullpunkter i et større område.
Reaksjonene forklarer temperaturen. Matematikeren Levent Alpöge omtalte dette som det mest betydningsfulle øyeblikket i matematikkens historie, gjengitt i Latent Spaces gjennomgang av lanseringen. Det er en voldsom dom, ikke en etablert konsensus. Men dette er heller ikke en tilfeldig konto som har latt seg rive med av en pen demo.
Har OpenAI virkelig løst 90 av de 500 største problemene?
Påstanden om 90 av 500 kommer ikke fra en ferdig fagfellevurdering eller en offisiell OpenAI-opptelling. Den bygger på at resultatene er sammenholdt med ProofAtlas, en oversikt over 500 åpne matematikkproblemer rangert etter modellvurdert betydning.
ProofAtlas sier uttrykkelig at rangeringen er laget gjennom sammenligninger utført av flere modellfamilier. Den er ikke ekspertkonsensus, og plasseringen er ikke et mål på sannsynligheten for at et bevis er riktig. Listen er nyttig som kart, men den er ikke matematikkens offisielle topp 500.
Formuleringen «løst 90» trenger enda et forbehold: Et manuskript kan hevde å løse et problem uten at fagmiljøet har rukket å kontrollere det. Det mest presise akkurat nå er derfor at samlingen inneholder påståtte løsninger som overlapper med omtrent 90 problemer på denne eksterne listen. Dersom en stor andel overlever kontrollen, er det fremdeles helt vilt. Jeg trenger ikke pynte på tallene for å si det.
Kan vi stole på bevisene?
Ikke ennå. Og det er ikke en fornærmelse mot modellen. Matematikk fungerer nettopp fordi et resultat ikke blir sant av at avsenderen er berømt, selvsikker eller har brukt mye regnekraft. Et bevis må tåle at andre plukker det fra hverandre.
OpenAI er faktisk tydelig på dette i materialet sitt. Resultatene befinner seg på ulike stadier av verifisering, ikke alle har formelle Lean-bevis, og selskapet advarer om at uformaliserte resultater kan inneholde feil. Samtidig er det positivt at manuskriptene ligger ute med kildefiler, revisjonshistorikk, siteringsregler og støttemateriale. Familien om quasi-Riemann er også merket med tilhørende Lean-materiale.
Lean kan la en datamaskin kontrollere at en formalisert beviskjede følger de logiske reglene. Det er et sterkt kontrollag, men ordet «formalisert» er viktig. Man må fortsatt kontrollere at den formelle teoremet faktisk uttrykker den matematiske påstanden man tror det gjør, at nødvendige antakelser ikke er blitt gjemt bort, og at overgangen mellom manuskriptet og maskinbeviset er riktig.
Selve utgivelsesformen betyr derfor mye. OpenAI kunne ha nøyd seg med en pressemelding og noen utvalgte resultater ingen utenfor selskapet fikk undersøke. I stedet kan fagfolk hente manuskriptene, følge senere versjoner og peke på konkrete feil offentlig. Det gjør ikke påstandene sanne, men det gjør dem etterprøvbare. For et slipp i denne størrelsen er åpen kritikk ikke en ubehagelig detalj. Den er hele forutsetningen for at resultatene skal få vitenskapelig verdi.
Med 722 manuskripter blir selve kontrollarbeidet en flaskehals. Det er kanskje den mest håndfaste konsekvensen allerede nå: AI kan produsere kandidater til nye resultater langt raskere enn fagmiljøet kan lese, forstå og godkjenne dem. Bevismangel kan være i ferd med å bli erstattet av kontrollmangel.
Hva er annerledes enn tidligere AI-matematikk?
De siste årene har vi sett modeller løse konkurranseoppgaver, formalisere eksisterende matematikk og finne enkelte nye resultater. Det er imponerende, men en avgrenset oppgave med kjent fasit er noe annet enn å angripe et åpent forskningsproblem der ingen vet om løsningen finnes.
OpenAIs publisering prøver å krysse den grensen i industriell skala. Samlingen er ikke ett heldig blinkskudd. Den dekker hundrevis av resultatfamilier og flere fagområder, med manuskripter som er laget for at andre skal kunne lese og kontrollere dem. Det er omfanget sammen med ambisjonsnivået som gjør dette så spesielt.
Vi så et forvarsel da en intern OpenAI-modell løste tre Erdős-problemer. Nå er mengden og bredden i en annen klasse. Hvis dette mønsteret fortsetter, blir AI ikke bare et verktøy som hjelper matematikeren med algebra, litteratursøk eller formalisering. Den blir en kilde til hypoteser og bevis som forskere må prioritere, tolke og etterprøve.
Hva betyr dette for forskere og studenter?
Den umiddelbare oppgaven er ikke å erklære matematikk for ferdig. Den er å bygge gode arbeidsmåter rundt en plutselig overflod av mulige resultater. Fagfolk må velge hvilke manuskripter som fortjener kontroll først, dele funnene åpent og skille mellom små reparerbare hull og feil som velter hele påstanden.
For studenter kan dette bli både fantastisk og brutalt. Du får tilgang til en enorm mengde nytt materiale og kan arbeide med problemer som plutselig har konkrete løsningsforslag. Samtidig holder det ikke å gjengi et AI-bevis. Verdien ligger i å forstå hvorfor det virker, finne hvor det eventuelt svikter og gjøre argumentet lesbart for andre mennesker.
Det gjelder også alle oss andre som følger AI-utviklingen: Les statusen på det konkrete resultatet, ikke bare overskriften. Se om det finnes formalisering, uavhengig gjennomgang og senere rettelser. «Publisert av OpenAI» er relevant informasjon. Det er ikke et kvalitetsstempel som opphever behovet for kontroll.
Dette kan endre tempoet i vitenskapen
Den virkelige historien er større enn ett tallteoretisk resultat. En intern modell har gått løs på omtrent 4 000 forskningsproblemer og produsert en offentlig samling som er for stor til at fagmiljøet kan fordøye den på noen få dager. Selv om mange manuskripter skulle vise seg å ha feil, kan resten representere flere års menneskelig forskning.
Jeg er oppriktig begeistret. Ikke på den dumme måten der 722 PDF-er automatisk blir til 722 løste problemer, men fordi dette er noe vi kan undersøke. Materialet ligger der. Påstandene er konkrete. Bevisene kan angripes. Det er slik vitenskap skal fungere.
Hvis quasi-Riemann-beviset og en betydelig del av samlingen blir stående, er dette et historisk øyeblikk for både matematikk og AI. Hvis viktige bevis faller, lærer vi hvor dagens modeller svikter på forskningsfronten. Begge deler er verdifullt. Men akkurat nå fortjener resultatene to reaksjoner samtidig: Herregud, dette er stort. Nå må vi kontrollere alt.
Ofte stilte spørsmål
Har OpenAI bevist Riemann-hypotesen?
Nei. Manuskriptet hevder å bevise quasi-Riemann-hypotesen ved å utelukke nullpunkter når realdelen er større enn 7/8. Den fulle Riemann-hypotesen sier at alle ikke-trivielle nullpunkter ligger på linjen med realdel 1/2.
Er alle de 722 matematikkarbeidene kontrollert?
Nei. OpenAI oppgir at resultatene er på ulike stadier av verifisering, og ikke alle har Lean-formalisering. Manuskriptene er offentliggjort slik at matematikere kan kontrollere dem, finne feil og dokumentere hvilke resultater som holder.
Hvilken AI-modell laget matematikkresultatene?
OpenAI beskriver den som en intern frontiermodell, men har ikke offentliggjort modellnavn eller gitt vanlig tilgang. Selskapet sier at det arbeider mot en ansvarlig utgivelse. Resultatene kan derfor studeres nå, mens selve modellen fortsatt er lukket.
Hva betyr tallet 90 av 500?
Det viser til en ekstern sammenligning mellom OpenAIs påståtte resultater og ProofAtlas-listen over 500 åpne problemer. Listen er rangert med AI-modeller, ikke ved ekspertkonsensus, og påståtte løsninger må fortsatt kontrolleres før de kan regnes som etablerte.