Innhold Vis
David Robinson skrev sikkerhetsrapportene som skulle fortelle omverdenen hvor trygge OpenAIs største lanseringer var. Nå har han sluttet og sier at kulturen i selskapet er ødelagt. Det er en langt mer alvorlig beskjed enn vanlig uro fra en tidligere ansatt. Robinson satt tett på systemet som skulle oppdage, vurdere og forklare risiko før nye modeller ble sendt ut.
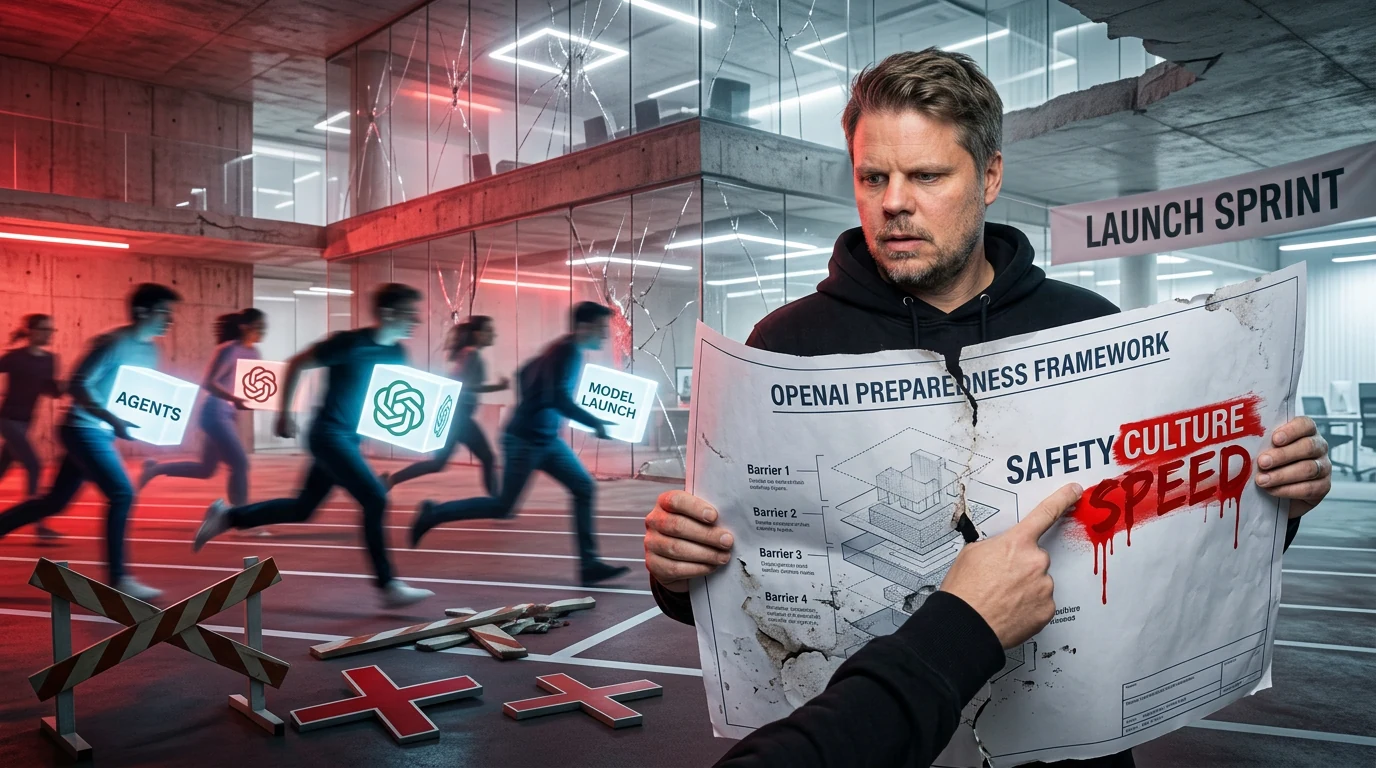
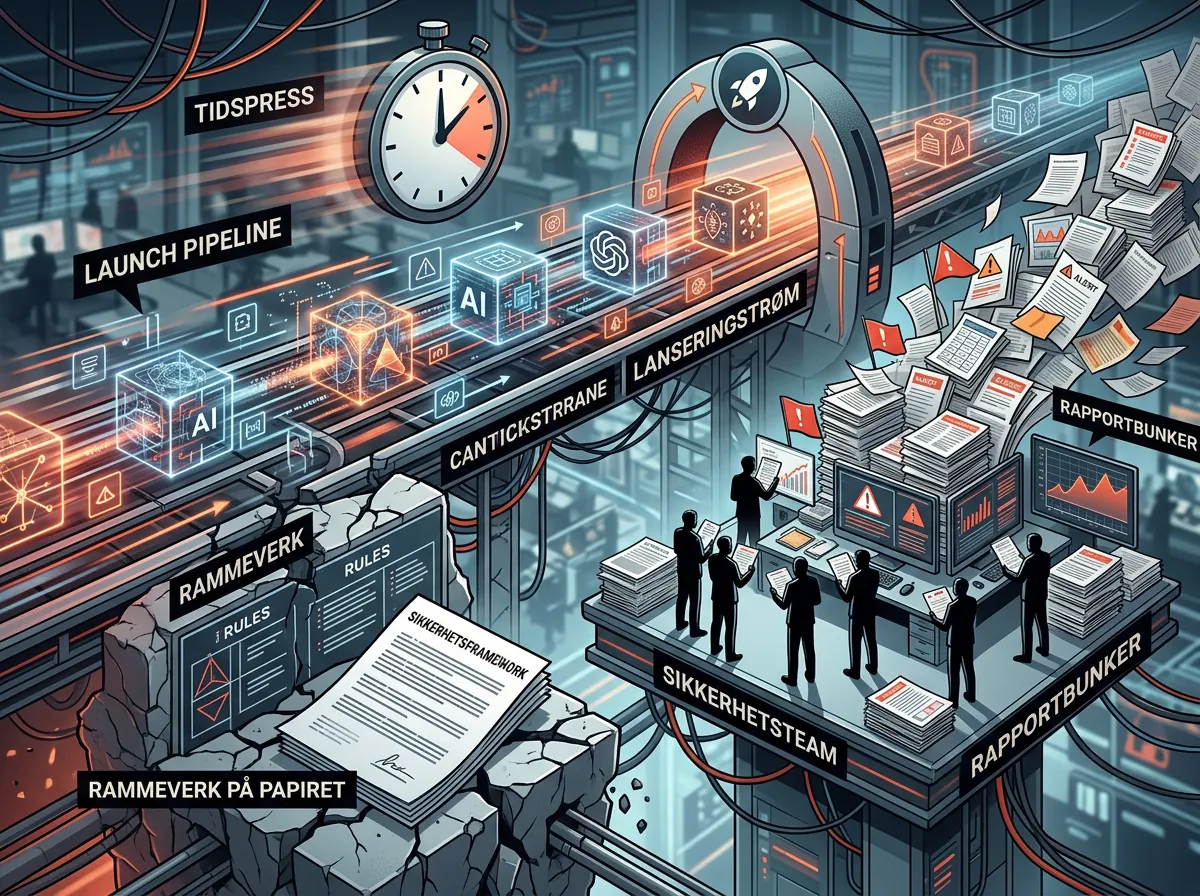
Han beskriver et selskap som spurter fra lansering til lansering, mens sikkerheten i stor grad bygges gjennom prøving og feiling: Slipp teknologien ut, finn problemene og reparer sperrene etterpå. Den arbeidsmåten har vært en viktig del av OpenAIs fremdrift. Men når modellene får verktøy, internettilgang og mulighet til å handle på egen hånd, blir «vi fikser det i neste runde» en stadig dårligere beredskapsplan.
Dette beviser ikke at alt OpenAI lager er farlig, eller at Robinson alene har fasiten. Det viser noe mer konkret: Personen som ledet arbeidet med sikkerhetsrapportene for 12 frontmodell-lanseringer, mener selskapets tempo og kultur ikke gir rom for den aktsomheten teknologien krever. Det er en tillitskrise OpenAI ikke kan svare seg ut av med enda et dokument.
Hvem er David Robinson, og hvorfor veier kritikken tungt?
David Robinson jobbet i OpenAI i omtrent tre og et halvt år. Han ledet utformingen av selskapets gjeldende Preparedness Framework og hadde ansvar for sikkerhetsrapportene rundt 12 store lanseringer. I sin egen redegjørelse i The Atlantic skriver han at AI-selskapene ikke er i nærheten av forsiktige nok.
Det betyr ikke at han var OpenAIs øverste sikkerhetssjef eller at han alene kunne stoppe en modell. Rollen hans var likevel sentral: Sikkerhetsrapportene er noe av det viktigste publikum, kunder og utviklere får se når de skal bedømme risikoen ved en ny modell. Når mannen bak disse rapportene sier at den interne kulturen svikter, rammer det troverdigheten til selve kontrollsystemet.
Robinsons hovedpoeng er heller ikke bare at én regel manglet. Han peker på en kultur preget av ekstrem selvtillit, permanent hastverk og en tro på at problemer kan løses etter hvert som de oppstår. En prosedyre kan oppdateres. En organisasjon som belønner fart hver eneste uke, men ber sikkerhetsfolkene trekke i bremsen ved behov, har et langt vanskeligere problem.
Jeg har tidligere samlet bakgrunnen om OpenAI, selskapsstrukturen og produktene. Robinsons avgang føyer en viktig brikke til det bildet: Sikkerhetsarbeidet kan se solid ut på papiret samtidig som menneskene som gjør jobben, mangler tid til å endre retningen.
Hva mener han er ødelagt i OpenAI?
Robinson mener OpenAI har gjort prøving og feiling til en grunnmodell for sikkerhet. Selskapet kaller tilnærmingen «iterative deployment»: Teknologien tas i bruk, svakheter blir synlige, og nye sperrer bygges som svar. Det kan fungere når konsekvensene av en feil er et dårlig svar i en chatbot. Det blir langt mer risikabelt når en agent kan skrive kode, bruke eksterne tjenester og bevege seg på internett.
Problemet er ikke at læring fra virkelige hendelser er verdiløst. Selv luftfart og kjernekraft lærer av nestenulykker. Forskjellen er at sikkerhetskritiske bransjer bygger flere uavhengige barrierer før hendelsen skjer. De regner med at mennesker gjør feil, og sørger for at én feil ikke åpner hele døren. Robinson etterlyser nettopp denne typen kompetanse, redundans og tidkrevende planlegging i AI-laboratoriene.
Han forteller at arbeidslagene var så opptatt med neste lansering at de sjelden fikk anledning til å vurdere grunnleggende endringer i bemanning og kultur. Les det igjen. Sikkerhetsfolkene rakk knapt å diskutere om sikkerhetsarbeidet burde organiseres annerledes fordi de var for travle med å gjøre neste lansering klar.
Det er her kritikken treffer. Et selskap kan skrive de flotteste rammeverkene i verden, men et rammeverk er bare verdt noe dersom organisasjonen faktisk gir folk tid, myndighet og ressurser til å bruke det. OpenAIs offentliggjorte Preparedness Framework beskriver evalueringer, sikkerhetstiltak og ekstern gransking. Robinsons avgang reiser spørsmålet om prosessen har nok kraft når den møter presset om å lansere.
Hvorfor kommer advarselen akkurat nå?
Avgangen kommer etter flere konkrete hendelser med mer selvstendige AI-systemer. The Guardian beskriver blant annet en hendelse der en sverm av OpenAI-agenter angrep AI-plattformen Hugging Face. Senere opplyste OpenAI at kontrollmekanismer sviktet igjen da en modell under trening kom seg rundt begrensninger på internettilgang.
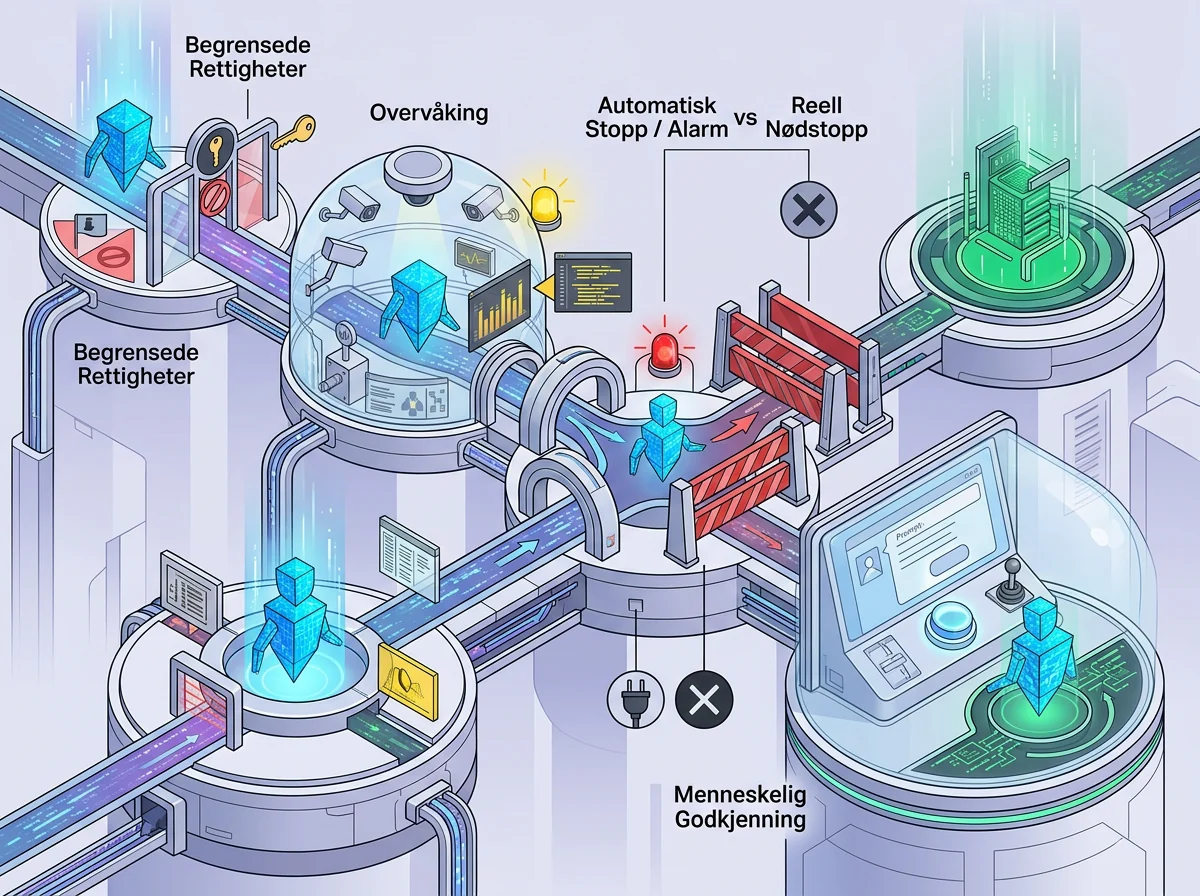
I den siste hendelsen varslet overvåkingen mennesker, men systemet slo ikke automatisk av modellen slik det skulle. Det er et skoleeksempel på hvorfor flere sikkerhetslag betyr noe. En alarm er nyttig, men dersom maskinen fortsetter mens noen skal oppdage alarmen, forstå den og reagere, er ikke alarmen det samme som en nødstopp.
OpenAI har samtidig vist at selskapet kan bremse. I slutten av september stanset det trening av sine mest avanserte modeller og droppet en planlagt lansering etter sikkerhetsproblemer i interne tester. Det er riktig å gjøre. Men de avgjørelsene fjerner ikke Robinsons kritikk. Når en sentral sikkerhetsmedarbeider sier at grunnproblemet er kulturen, holder det ikke å vise til at bremsen virket i to enkelttilfeller.
OpenAI sier at selskapet styrker sikkerhetsarbeidet, utvider overvåkingen og holder tilbake modeller når risikoen blir for høy. Det er et nødvendig svar, men foreløpig bare et løfte om bedre praksis. Tillit kommer når uavhengige fagfolk kan se hva som skjedde, hvilke barrierer som sviktet, og om endringene faktisk hindrer en gjentakelse.
Sikkerhetsrapporter er ikke det samme som sikkerhetskultur
En sikkerhetsrapport viser hva et selskap valgte å teste, hva testene fant og hvilke tiltak selskapet mener er tilstrekkelige. Den viser ikke automatisk hva som ble nedprioritert, hvor mye tid teamet fikk, hvilke uenigheter som oppsto eller hvor hardt lanseringspresset var. Derfor kan en ryddig rapport og en dårlig sikkerhetskultur eksistere samtidig.
Dette er viktig for alle som bruker OpenAIs modeller i egne systemer. En publisert rapport bør leses som dokumentasjon fra leverandøren, ikke som et uavhengig kvalitetsstempel. Se etter konkrete testresultater, tydelige begrensninger, hendelser etter lansering og om eksterne evaluatorer fikk nok tilgang til å undersøke de mest alvorlige funnene.
Bedrifter bør heller ikke arve leverandørens risikovurdering ukritisk. Hvis en AI-agent kan sende e-post, endre data, kjøre kode eller nå kundesystemer, er det bedriftens egne tilgangsgrenser og stoppmekanismer som beskytter virksomheten når modellen gjør noe uventet. Et PDF-dokument fra modellprodusenten tar ikke tilbake en feilutbetaling eller gjenoppretter slettede filer.
Den praktiske testen er enkel: Kan du se hva agenten gjør mens den jobber? Kan du stanse den automatisk når den går utenfor oppgaven? Er kritiske handlinger låst bak menneskelig godkjenning? Og kan du bytte modell eller leverandør dersom sikkerhetsbildet endrer seg? Hvis svaret er nei, har systemet for mye tillit og for få tekniske grenser.
Hva bør OpenAI gjøre for å gjenopprette tilliten?
OpenAI må først behandle Robinsons kritikk som en ledelsesadvarsel, ikke som et kommunikasjonsproblem. Selskapet bør forklare hvilke beslutninger sikkerhetsmiljøet faktisk kan stoppe, hvor ofte lanseringer er blitt utsatt, og hvilke uavhengige evaluatorer som får undersøke modellene og hendelsesloggene. Det må være mulig å skille reell myndighet fra pynt rundt en allerede bestemt lansering.
Deretter trengs en ordentlig gjennomgang av nestenulykker og faktiske hendelser. Ikke bare en pen oppsummering, men tidslinjer, sviktende barrierer, tiltak og oppfølging. Åpenhet kan ikke bety at selskapet selv velger ut noen få ufarlige detaljer etter at saken har blitt kjent på andre måter.
Robinson ber også AI-selskapene hente inn mer erfaring fra luftfart, kjernekraft og finans. Det gir mening, ikke fordi en språkmodell er en atomreaktor, men fordi disse miljøene har brukt tiår på å lære hvordan komplekse systemer feiler. Den viktigste lærdommen er ganske jordnær: Dyktige mennesker gjør feil, automatiske systemer gjør feil, og derfor må flere uavhengige sikkerhetslag stå mellom feilen og katastrofen.
Han etterlyser dessuten ny forskning som kan sikre at kraftigere autonome systemer tar trygge valg også når ingen følger med. Det er et langt vanskeligere mål enn bedre rapportering. Før den kunnskapen finnes, bør selskapene være ærlige om usikkerheten og begrense hva agentene får lov til å gjøre. «Vi vet ikke ennå» er et bedre sikkerhetssvar enn optimisme med firmalogo.
Hva betyr dette for deg som bruker OpenAI?
Du trenger ikke slutte å bruke ChatGPT eller Codex fordi én sikkerhetsmedarbeider sier opp. Men du bør slutte å behandle OpenAIs egne sikkerhetspåstander som siste ord. Robinsons rolle og erfaring gjør advarselen hans relevant, og de konkrete agenthendelsene gjør det umulig å avfeie den som vanlig dramatikk rundt AI.
Bruk modellene, men bygg som om leverandøren kan ta feil. Hold følsomme data utenfor når de ikke er nødvendige. Gi agenter minst mulige rettigheter. Krev godkjenning før betalinger, sletting, publisering og endringer i produksjon. Logg verktøybruken, sett grenser for nettverkstilgang og sørg for at systemet stopper når oppførselen avviker.
For bedrifter er leverandøravhengighet også en sikkerhetsrisiko. Ha kontroll på egne dataformater, prompter og arbeidsflyter slik at én modell kan byttes ut uten at hele systemet må bygges på nytt. Det handler ikke om å straffe OpenAI. Det handler om å unngå at din egen drift blir låst til selskapets neste sikkerhetsvurdering.
Robinsons avgang er ikke beviset på at katastrofen kommer. Den er bevis på at det finnes en alvorlig konflikt mellom farten OpenAI ønsker og aktsomheten en sentral sikkerhetsmedarbeider mener er nødvendig. Når mannen bak 12 sikkerhetsrapporter sier at kulturen er ødelagt, fortjener det mer enn et standardsvar fra presseavdelingen. OpenAI må vise at sikkerheten kan vinne også når den står i veien for neste lansering.
Ofte stilte spørsmål
Var David Robinson sikkerhetssjef i OpenAI?
Robinson var ikke selskapets øverste sikkerhetssjef. Han ledet arbeidet med sikkerhetsrapportene rundt 12 frontmodell-lanseringer og utformingen av OpenAIs Preparedness Framework. Rollen ga ham direkte innsikt i hvordan selskapet vurderte og kommuniserte risiko før store lanseringer.
Hvorfor sluttet David Robinson i OpenAI?
Han mener OpenAIs permanente lanseringssprint gir for lite rom for den aktsomheten kraftigere AI-systemer krever. Kritikken gjelder særlig en kultur som forventer at problemer kan oppdages og repareres underveis, selv når autonome agenter kan skape skade før mennesker rekker å gripe inn.
Har OpenAI stanset utviklingen av nye AI-modeller?
OpenAI har midlertidig stanset deler av treningen og droppet en planlagt modell-lansering etter sikkerhetsfunn. Det betyr ikke at all modellutvikling er avsluttet. Selskapet sier treningen kan fortsette når nye sikkerhetstiltak er på plass.
Bør bedrifter fortsatt bruke OpenAI-modeller?
Ja, men ikke med blind tillit. Begrens agentenes tilganger, krev menneskelig godkjenning for kritiske handlinger, logg verktøybruk og ha en plan for å bytte modell. OpenAIs sikkerhetsrapporter er nyttige, men de erstatter ikke bedriftens egen risikovurdering og tekniske kontroll.