Innhold Vis
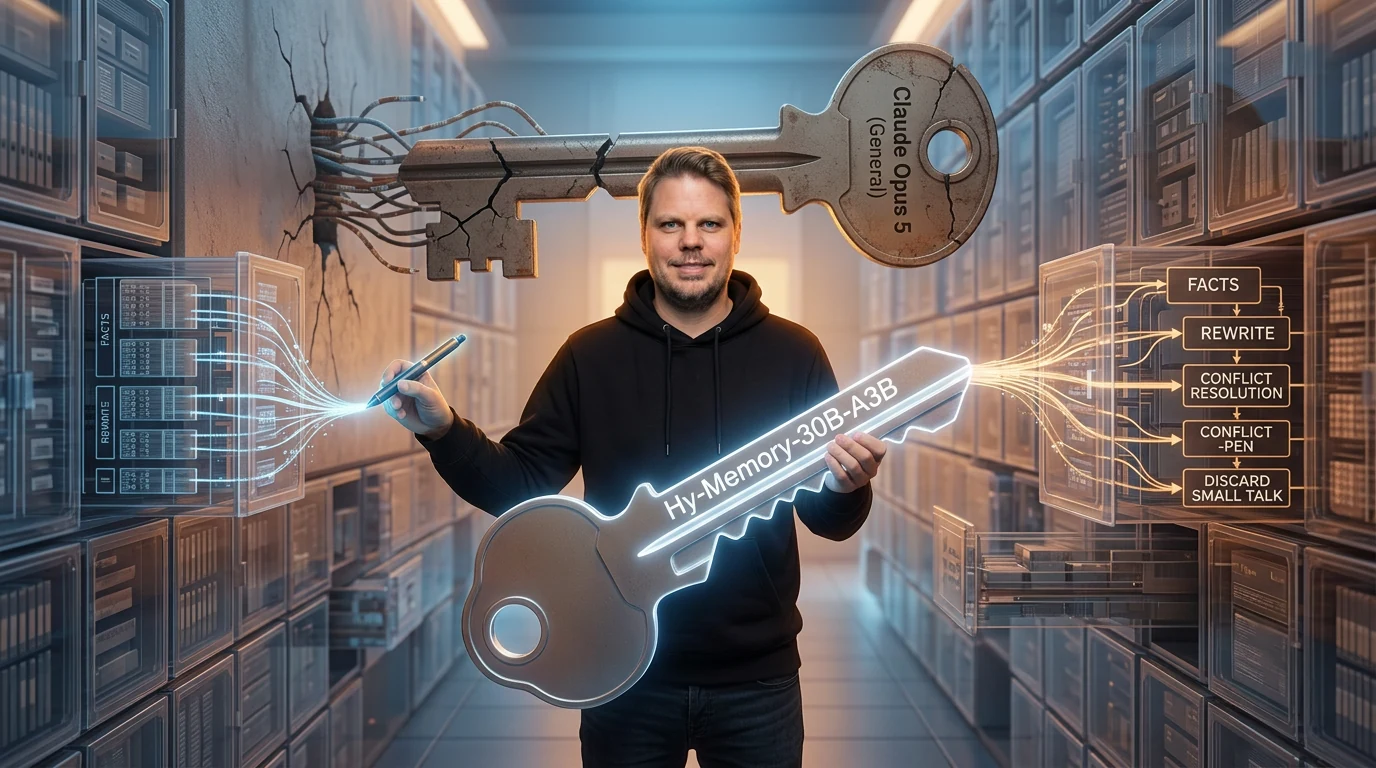
Hy-Memory-30B-A3B er en åpen spesialmodell som bestemmer hva en AI-agent skal huske, hvordan minnet skal formuleres og når gammel informasjon må oppdateres. Tencent hevder at modellen, med rundt 3 milliarder aktive parametre, slår Claude Opus 5 på akkurat denne jobben.
Det høres nesten komisk ut. En liten aktiv del av en åpen modell mot en av de tyngste lukkede modellene – og den lille vinner. Tallene er reelle, men overskriften trenger en solid fotnote: Hy-Memory slår ikke Opus 5 som generell språkmodell. Den vinner knepent i Tencents egen samlepoengsum for skriving til eksterne minnesystemer.
Likevel synes jeg dette er skikkelig spennende. AI-agenter blir ikke bedre av å lagre absolutt alt. De trenger et system som skiller varige fakta fra småprat, oppdaterer motstridende opplysninger og unngår å fylle minnebanken med søppel. Tencent har laget en modell for nettopp den utakknemlige jobben – og publisert vektene under Apache 2.0.
Hva er Hy-Memory-30B-A3B?
Hy-Memory-30B-A3B er en Mixture-of-Experts-modell med cirka 30 milliarder parametre totalt og rundt 3 milliarder aktive per token. Ifølge modellkortet på Hugging Face er den laget for skrivefasen i eksterne minnesystemer som Mem0, MemOS og Tencents eget Hy-Memory.
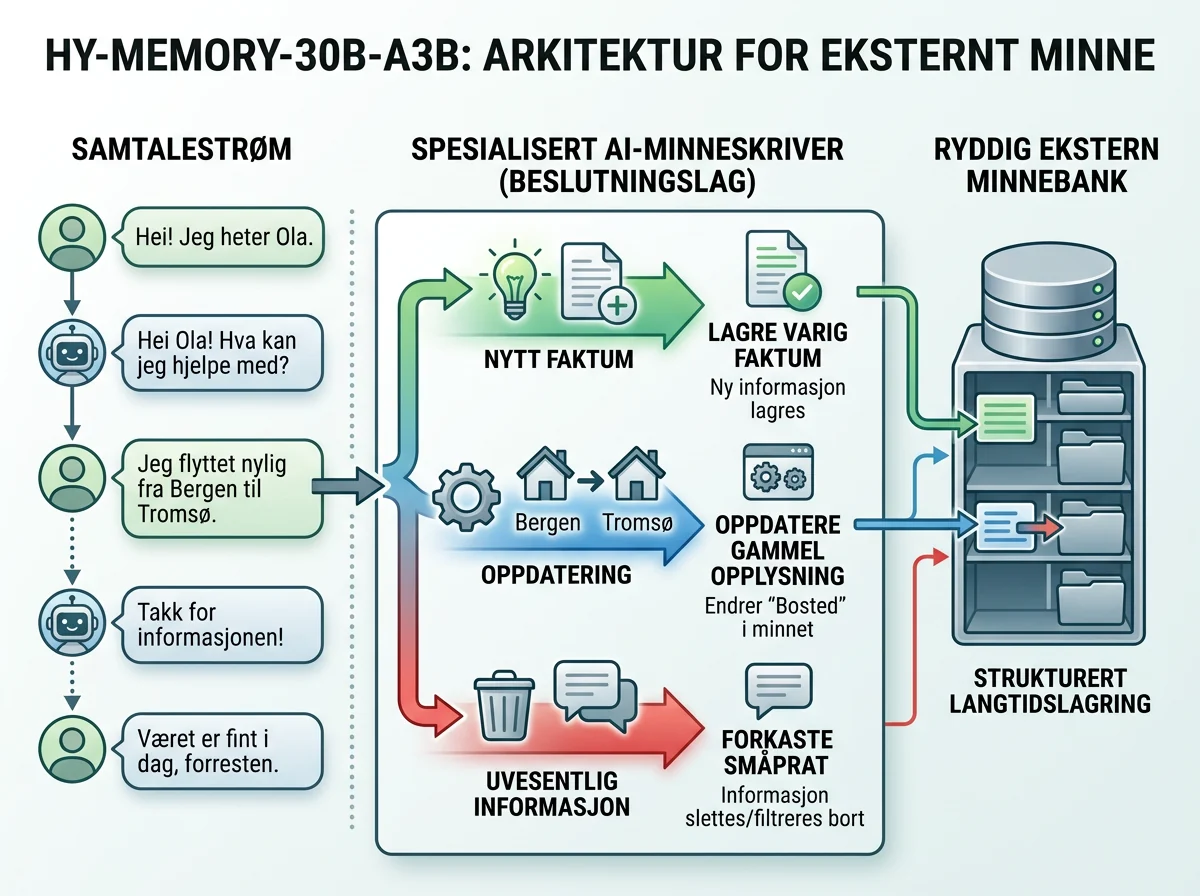
«Skrivefasen» er viktig. Modellen er ikke selve databasen, og den er heller ikke primært modellen som svarer brukeren. Den sitter mellom samtalen og minnebanken og tar avgjørelser som: Er dette verdt å lagre? Hvordan kan opplysningen uttrykkes presist? Er dette en ny opplysning, eller erstatter den noe som allerede ligger der?
Det er en smalere oppgave enn vanlig chat, men den er ikke enkel. Hvis brukeren først sier at hun bor i Bergen og senere forteller at hun har flyttet til Tromsø, holder det ikke å lagre begge setningene som like gyldige fakta. Et godt minnesystem må forstå endringen, bevare nødvendig historikk og hente fram riktig opplysning senere.
Hva betyr det at modellen slår Opus 5?
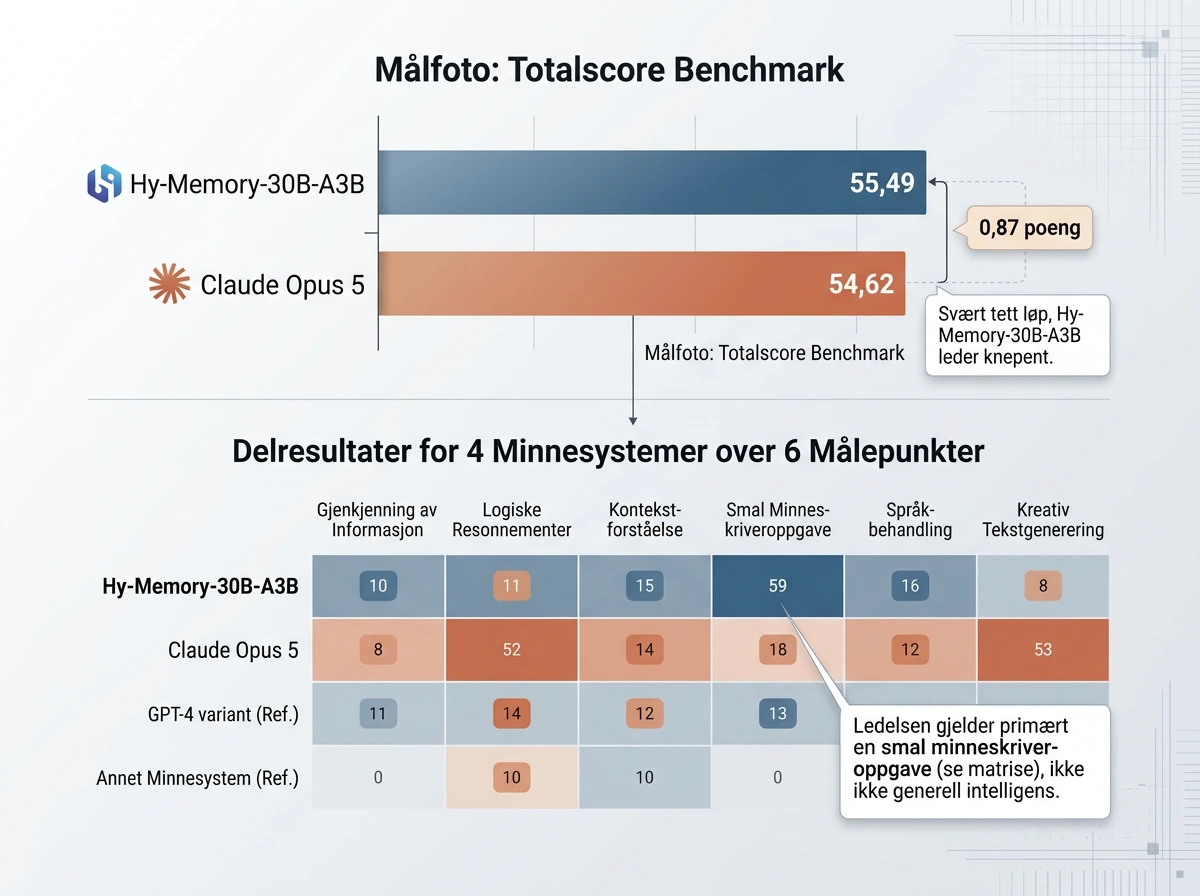
Tencent rapporterer en samlet poengsum på 55,49 for Hy-Memory-30B-A3B, mot 54,62 for Claude Opus 5. Resultatet kommer fra fire minneoppsett, seks målemetoder og faste 20-prosentutvalg av testene. I denne avgrensede evalueringen kom Hy-Memory øverst i alle de fire oppsettene.
Forskjellen er 0,87 poeng. På Mem0 fikk Hy-Memory 54,02 mot 53,43 for Opus 5. På Tencents eget Hy-Memory-oppsett var tallene nesten identiske: 60,55 mot 60,53. Forfatterne skriver selv at marginene på 0,01-0,02 poeng i Hy-Memory og MemOS betyr at modellene i praksis presterte likt, ikke at forskjellen er statistisk avklart. Det største utslaget kom på EverMemOS, som ikke var med i treningen, der Hy-Memory fikk 56,89 mot 54,04.
Det er et godt resultat. Det er ikke dokumentasjon på at en modell med 3 milliarder aktive parametre er «smartere enn Opus 5». Den tekniske rapporten måler én spesialisert rolle: modellen som skriver og vedlikeholder et eksternt minne mens svarmodell, gjenfinning, instrukser og andre deler av systemet holdes faste.
Tencent sammenligner også med den tidligere åpne Hy3-modellen. Hy3 fikk 51,63 samlet, mens en Hy3-A3B-basemodell fikk 47,66. Hoppet opp til 55,49 støtter at trening på selve minnejobben betyr mye mer enn bare modellfamilien og parameterantallet.
Det er også Tencent og forskerne bak modellen som har laget evalueringen. Resultatene er publisert på et fast utvalg på 20 prosent, ikke hele benchmarksettene, og rapporten kom 15. oktober 2026. Jeg ville derfor kalt dette et lovende leverandørresultat som fortjener uavhengig testing – ikke en ny verdensorden basert på 0,87 poeng.
Hvorfor bruke en egen modell til minnet?
En spesialmodell kan gjøre minnesystemet billigere og mer forutsigbart enn å sende hver eneste minneoperasjon gjennom en stor generell modell. Hy-Memory aktiverer rundt 3 milliarder av totalt 30 milliarder parametre per token. Det reduserer beregningen for hvert minneskriv, selv om hele modellen fortsatt må være tilgjengelig i minnet under kjøring.
Dette er samme grunnidé som ellers i programvare: Du trenger ikke sette administrerende direktør til å sortere innboksen. En stor generell modell kan sikkert utføre jobben, men en mindre modell som er trent spesifikt på uttrekk, oppdatering og konfliktløsning kan være både raskere og bedre til akkurat det.
Hy-Memory ble først trent med det Tencent kaller Memory On-Policy Distillation. Modellen skrev sine egne minnetilstander og fikk tett veiledning fra en lærer. Deretter brukte forskerne reinforcement learning der de vurderte om minnebanken faktisk gjorde senere spørsmål lettere å besvare. Belønningen ble knyttet til bestemte deler av forløpet, samtidig som treningen skulle hindre overdreven lagring.
Det siste er minst like viktig som å huske nok. Et system som lagrer hver høflighetsfrase og hvert foreløpige utkast får ikke god hukommelse. Det får et digitalt loft. Gjenfinningen blir dyrere, relevante fakta drukner og modellen kan begynne å behandle gamle eller tilfeldige detaljer som sannhet.
Hva ble faktisk testet?
Evalueringen dekker Mem0, Hy-Memory, MemOS og EverMemOS. For hvert oppsett brukte Tencent seks målinger: LoCoMo Judge, LongMemEval, PersonaMem-v2, Travel SPS, Shopping PS og Code Memory Bench. De seks ble vektet likt i hvert minneoppsett, og de fire oppsettene ble deretter vektet likt i totalsummen.
Forskerne oppgir at bare minneskriveren ble byttet mellom testene. Oppsett, instrukser, gjenfinning, svarmodell og dommer skulle ellers være de samme. Hver skriver bygget dessuten sin egen minnebank fra tom tilstand. Det er riktig måte å isolere spørsmålet på: Hvor mye betyr modellen som bestemmer hva som blir lagret?
Resultatene spriker likevel mellom deltestene. På Mem0 fikk Opus 5 for eksempel 69,47 på LoCoMo mot 59,54 for Hy-Memory, mens Hy-Memory vant LongMemEval 73,00 mot 66,00. På EverMemOS vant Hy-Memory Code Memory Bench klart med 63,19 mot 49,53, men tapte Shopping PS 19,05 mot 23,89.
Det er sunnere å lese tabellen enn slagordet. Samlescoren sier at Hy-Memory var best i akkurat denne matrisen. Delresultatene sier at ingen modell vant alt, og at ditt eget bruksmønster kan gi en annen vinner. En kodeagent, en personlig assistent og et reisesystem legger ikke nødvendigvis samme verdi i hva som bør huskes.
En 3B-aktiv modell er fortsatt en 30B-modell
Betegnelsen 30B-A3B betyr omtrent 30 milliarder parametre totalt og 3 milliarder aktive per token. Det forteller at modellen bruker en sparsom MoE-arkitektur. Den aktiverer åtte av 128 eksperter per token, i tillegg til en delt ekspert, ifølge den publiserte konfigurasjonen.
Det betyr lavere beregning enn om alle 30 milliarder parametre jobbet med hvert token. Det betyr ikke at vektene plutselig tar like liten plass som en vanlig 3B-modell. Hugging Face-repositoryet inneholder 51 safetensors-filer, og API-metadataene oppgir rundt 30,06 milliarder BF16-parametre og cirka 60 GB lagringsplass.
Tencent dokumenterer vLLM 0.31.0 som serveringsvei og bruker et OpenAI-kompatibelt API i eksemplet. Modellkonfigurasjonen oppgir opptil 262 144 posisjoner. Det finnes ingen offisiell GGUF-utgave eller dokumentert Ollama-oppskrift i utgivelsen jeg har kontrollert.
Så nei, dette er ikke en modell jeg uten videre ville lastet inn som om den var en liten 3B. Kvantisering kan naturligvis endre minnebehovet dersom gode varianter kommer, men hastighet, kvalitet og maskinvarekrav må måles på den faktiske utgaven. Jeg har ikke kjørt modellen selv, og lanseringsmaterialet oppgir ikke en ferdig fasit for vanlig forbrukermaskinvare.
Passer den inn i eksisterende minnesystemer?
Ja, det er selve poenget. Modellen er trent for å erstatte den generelle språkmodellen i skrivefasen til Mem0, MemOS og Hy-Memory. EverMemOS ble holdt utenfor treningen og brukt til å måle overføring til et nytt rammeverk. Der fikk Hy-Memory den største ledelsen over Opus 5 i totalscoren.
Dette er mer interessant enn om modellen bare hadde fungert med Tencents eget system. Et minneformat er i praksis en kontrakt: Modellen må følge instruksene til rammeverket, produsere riktig struktur og forstå når den skal legge til, endre eller la være å lagre. Overføring til et ukjent oppsett tyder på at treningen har lært mer enn én fast mal.
Tencent har samtidig lansert Hy-Memory 2.0 som åpen Python-SDK. Systemet skiller mellom chat, arbeid og koding. Chatdelen bygger et hierarki fra rå samtaler til fakta, sammendrag, skjemaer og intensjoner. Arbeid og koding bruker egne lag for fakta og gjenbrukbare erfaringer, mens kodevarianten også kan bevare endringskjeder.
Det ligner på et problem jeg allerede mener fortjener langt mer oppmerksomhet: Agentminne må være søkbart, sporbart og knyttet til faktisk arbeid. En haug med flate notatfiler er ikke et minnesystem. Den nye modellen løser ikke hele arkitekturen, men den kan gjøre én sentral del bedre.
Hva bør du måle før du bytter?
Start med den faktiske jobben agenten din gjør. Kjør den eksisterende minneskriveren og Hy-Memory på de samme samtalene eller arbeidsforløpene, med samme svarmodell og samme gjenfinning. Ellers vet du ikke om forskjellen kommer fra minneskriveren eller fra resten av systemet.
Mål mer enn om et senere spørsmål får riktig svar. Se hvor mange opplysninger modellen lagrer, hvor ofte den overskriver gyldige fakta, om den beholder utdaterte opplysninger og om den finner konflikter. Kontroller også strukturfeil, svartid, tokens per sekund og ressursbruk. En modell som løfter én svarscore, men dobler søppelet i banken, har ikke gjort jobben ferdig.
For kodeagenter bør testen inneholde lange og avbrutte oppgaver, endringer som senere blir reversert, og spørsmål om hvorfor en bestemt løsning ble valgt. For en personlig assistent bør du teste oppdaterte preferanser, tidsavhengige planer og opplysninger brukeren uttrykkelig ikke vil ha lagret. Tencents seks målinger er et startpunkt, ikke din kravspesifikasjon.
Jeg er fortsatt skeptisk til store påstander fra kinesiske modellutgivelser før andre har fått kjørt dem ordentlig. Men her er både vektene, koden og en detaljert evalueringsmatrise tilgjengelig. Det gjør påstanden mulig å etterprøve. Det er langt mer verdt enn enda en lukket demo med konfetti.
Den smale modellen kan være den riktige modellen
Hy-Memory-30B-A3B viser hvorfor agentstakken ikke trenger én gigantisk modell til absolutt alt. En sterk svarmodell kan snakke med brukeren, en embeddingmodell kan finne kandidater, og en spesialtrent minneskriver kan avgjøre hva som fortjener et liv etter samtalen. Det er en mer interessant arkitektur enn å kaste Opus på hver lille bakgrunnsoppgave.
Jeg ville ikke byttet en fungerende produksjonspipeline på grunnlag av én leverandørtest. Jeg ville lastet ned vektene, holdt resten av oppsettet fast og testet modellen på egne feilmoduser. Apache 2.0 gjør det mulig, og det er nettopp derfor åpne modeller betyr noe.
Tencent har ikke bevist at 3B slår Opus 5. De har vist at en 30B MoE-modell med rundt 3B aktive parametre kan slå Opus 5 knepent som minneskriver i deres oppsett. Det er smalere enn slagordet. Og ærlig talt: Det er også mye mer nyttig.
Ofte stilte spørsmål
Er Hy-Memory-30B-A3B en vanlig chatmodell?
Nei. Modellen er spesialtrent for skrivefasen i eksterne minnesystemer. Den avgjør hva som skal lagres, hvordan informasjonen skal representeres og hvordan nye opplysninger skal oppdatere en eksisterende minnebank. Den er ikke lansert som en generell erstatter for en vanlig chatmodell.
Slår Hy-Memory virkelig Claude Opus 5?
Ja, men bare i Tencents avgrensede minneevaluering. Hy-Memory fikk 55,49 i samlet poengsum mot 54,62 for Opus 5 på faste 20-prosentutvalg. Det dokumenterer en knepen seier som minneskriver i dette oppsettet, ikke bedre generell resonnering eller språkforståelse.
Kan Hy-Memory kjøres lokalt?
Vektene er åpne under Apache 2.0 og Tencent dokumenterer servering med vLLM 0.31.0. Modellen har rundt 30 milliarder BF16-parametre og cirka 60 GB med vekter, selv om bare omtrent 3 milliarder aktiveres per token. Faktisk maskinvarebehov avhenger av presisjon og serveringsoppsett.
Hvilke minnesystemer støtter modellen?
Tencent har trent den i Mem0, MemOS og tre Hy-Memory-oppsett for chat, arbeid og koding. EverMemOS ble holdt utenfor treningen og brukt som test på overføring til et nytt rammeverk. Egen integrasjon bør likevel valideres mot formatet og feiltilfellene i systemet ditt.