Innhold Vis
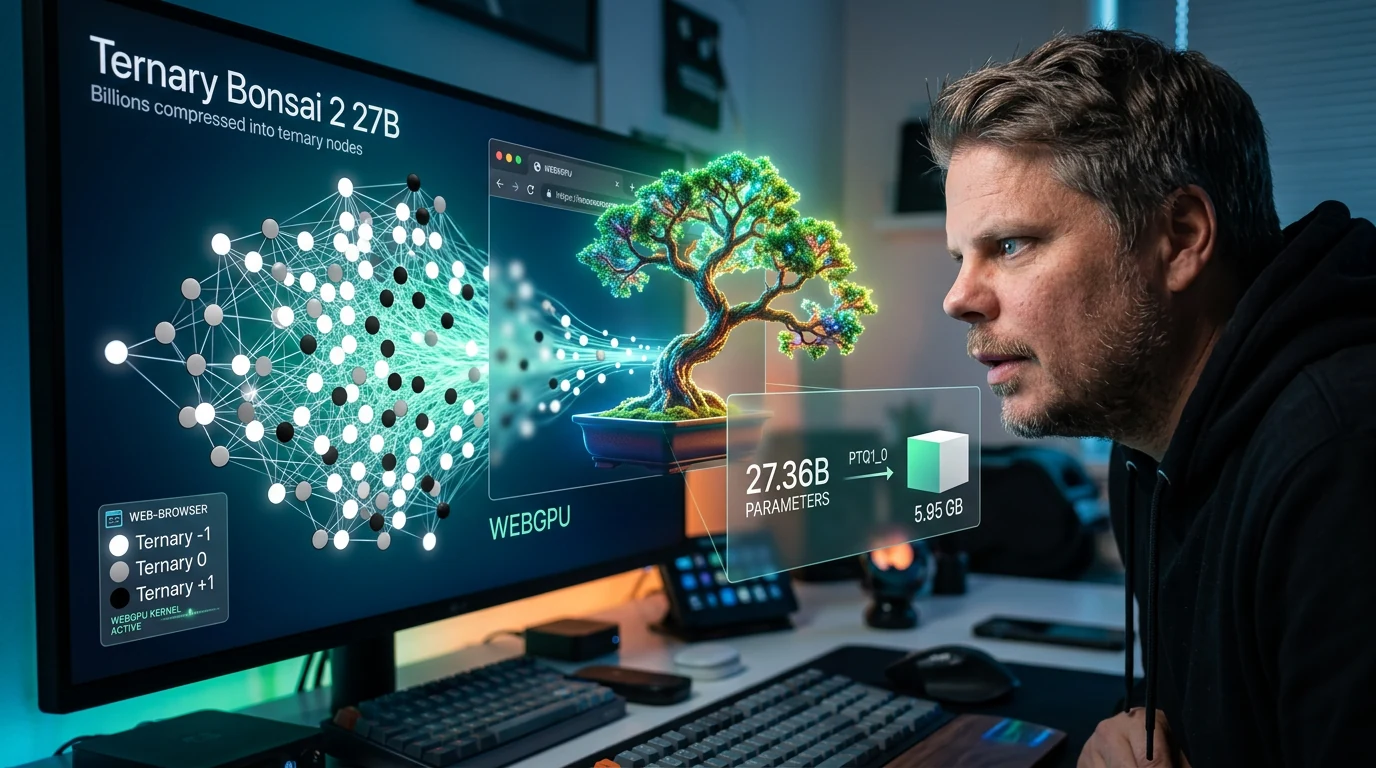
Ternary Bonsai 2 27B presser en språkmodell med 27,36 milliarder parametere ned i en fil på 5,95 GB. Det er lite nok til at hele språkmodellen kan kjøre lokalt i nettleseren med WebGPU.
Dette er ikke bare en ny kvantisering med et enda mer kryptisk filnavn. Prism ML har tatt Qwen3.8-27B, gjort språkvektene ternære og laget egne beregningskjerner som bruker de pakkede vektene direkte. Resultatet er en modell som er omtrent ni ganger mindre enn FP16-utgaven på rundt 54 GB.
Prism ML hevder samtidig at modellen beholder 98,2 prosent av gjennomsnittsscoren til FP16-utgaven i selskapets egen samling av 14 tester. Den påstanden trenger uavhengig praktisk testing før jeg kjøper hele pakken. Men størrelsen er håndfast, filen er ute, WebGPU-demoen er oppe, og retningen er rett og slett dritspennende.
Hva er Ternary Bonsai 2 27B?
Ternary Bonsai 2 27B er en komprimert utgave av Qwen3.8-27B der språkvektene i hovedsak lagres som tre mulige verdier: -1, 0 eller +1. Modellkortet hos Hugging Face oppgir 27,36 milliarder parametere, 262 000 tokens kontekst og Apache 2.0-lisens.
Vanlige FP16-vekter bruker 16 bit per vekt. Bonsai-formatet bruker i praksis 1,72 bit per vekt når skalering og de få tensorene som beholdes i høyere presisjon regnes med. Den tetteste GGUF-pakken heter PTQ1_0, bruker 1,75 bit per vekt og ender på 5,95 GB. Alternativet PQ2_0 bruker 2,13 bit per vekt og er 7,21 GB.
Arkitekturen er ellers den samme som i basismodellen. Omtrent 75 prosent er lineær attention og 25 prosent vanlig full attention. Den blandingen er en viktig grunn til at en lang kontekst kan være mer praktisk enn på en ren transformer med full attention i hvert lag. «Støtter 262 000 tokens» betyr likevel ikke at så lang kontekst er gratis. Runtime, KV-cache, hastighet og tilgjengelig minne teller fortsatt når modellen faktisk kjøres.
Hvorfor er 5,95 GB så oppsiktsvekkende?
En modellfil på 5,95 GB flytter en 27B-modell ned på maskinvare som tidligere var forbeholdt langt mindre modeller. FP16-utgaven er rundt 54 GB. En vanlig svært lavbit-versjon av Qwen3.8-27B som Prism ML sammenligner med, er ifølge modellkortet 9,4 GB. Her får du altså 27B-klassen under den magiske grensen på 6 GB.
Det betyr ikke at enhver PC med 6 GB ledig lagringsplass automatisk får en god opplevelse. Modellstørrelse på disk og samlet minnebruk er ikke det samme. Nettleseren og WebGPU-runtimen trenger plass, og konteksten vokser mens du arbeider. Lange samtaler og agentoppgaver kan derfor møte minnegrensen selv om selve vektene får plass.
Likevel er spranget enormt. Lokal AI blir først virkelig folkelig når sterke modeller kan kjøre på maskiner folk allerede har, uten en tung installasjon og uten at hvert spørsmål sendes til en ekstern server. En 27B-modell i en nettleser er ikke bare en morsom demo. Det viser hvor raskt grensen for hva som kan kjøres på vanlig forbrukermaskinvare flyttes.
Kan modellen virkelig kjøre i nettleseren?
Ja. Den offentlige WebGPU-demoen på Hugging Face kjører Ternary Bonsai 2 lokalt i en kompatibel nettleser. WebGPU gir nettsider tilgang til GPU-en gjennom et standardisert grensesnitt, mens spesiallagde kjerner håndterer de ternære vektene.
Dette er en langt lavere terskel enn å installere CUDA, kompilere llama.cpp og sette opp en lokal server. Du åpner en nettside, laster modellen og kjører inferens på egen maskin. Første nedlasting er fortsatt nesten 6 GB, så det er ikke akkurat en lett liten nettside. Men når vektene og beregningen ligger lokalt, trenger ikke promptene å sendes til en modell-API for at selve genereringen skal fungere.
WebGPU er samtidig ikke magi. Nettleser, grafikkdriver og GPU må støtte oppsettet, og ytelsen vil variere kraftig. En diskret GPU med nok videominne er noe helt annet enn integrert grafikk som deler minne med resten av systemet. Demoen er derfor den enkleste måten å finne ut om akkurat din maskin fungerer, uten å bygge hele runtime-miljøet først.
Hva betyr 98,2 prosent av FP16-intelligensen?
Tallet betyr at Ternary Bonsai 2 fikk et gjennomsnitt på 84,78 poeng mot 86,32 for FP16-modellen i Prism MLs 14 utvalgte tester. 84,78 delt på 86,32 blir omtrent 98,2 prosent. Det er altså en sammenligning av gjennomsnittlige benchmarkresultater, ikke en måleenhet for «intelligens» i vanlig forstand.
Resultatene er imponerende på papiret. Matematikk falt fra 97,06 til 96,57, kode gikk svakt opp fra 89,07 til 89,42, og tool calling falt fra 76,74 til 74,92. Det største dokumenterte tapet ligger i kunnskap og resonnering, som gikk fra 85,55 til 79,86, og vision, som falt fra 71,36 til 66,19.
Dette er leverandørens egne målinger med leverandørens valgte testoppsett. De forteller at komprimeringen ser langt mer lovende ut enn vanlig brutal lavbit-kvantisering, men de forteller ikke hvordan modellen skriver norsk, følger et komplisert systemprompt eller oppfører seg etter to timer som lokal agent. Den forrige Ternary Bonsai 27B-testen min viste nettopp hvorfor praktiske oppgaver betyr mer enn ett samlet prosenttall: Modellen var sterk på strukturert arbeid, mens norsk tekst og OCR hadde tydelige svakheter.
Hva er forbedret fra forrige Ternary Bonsai?
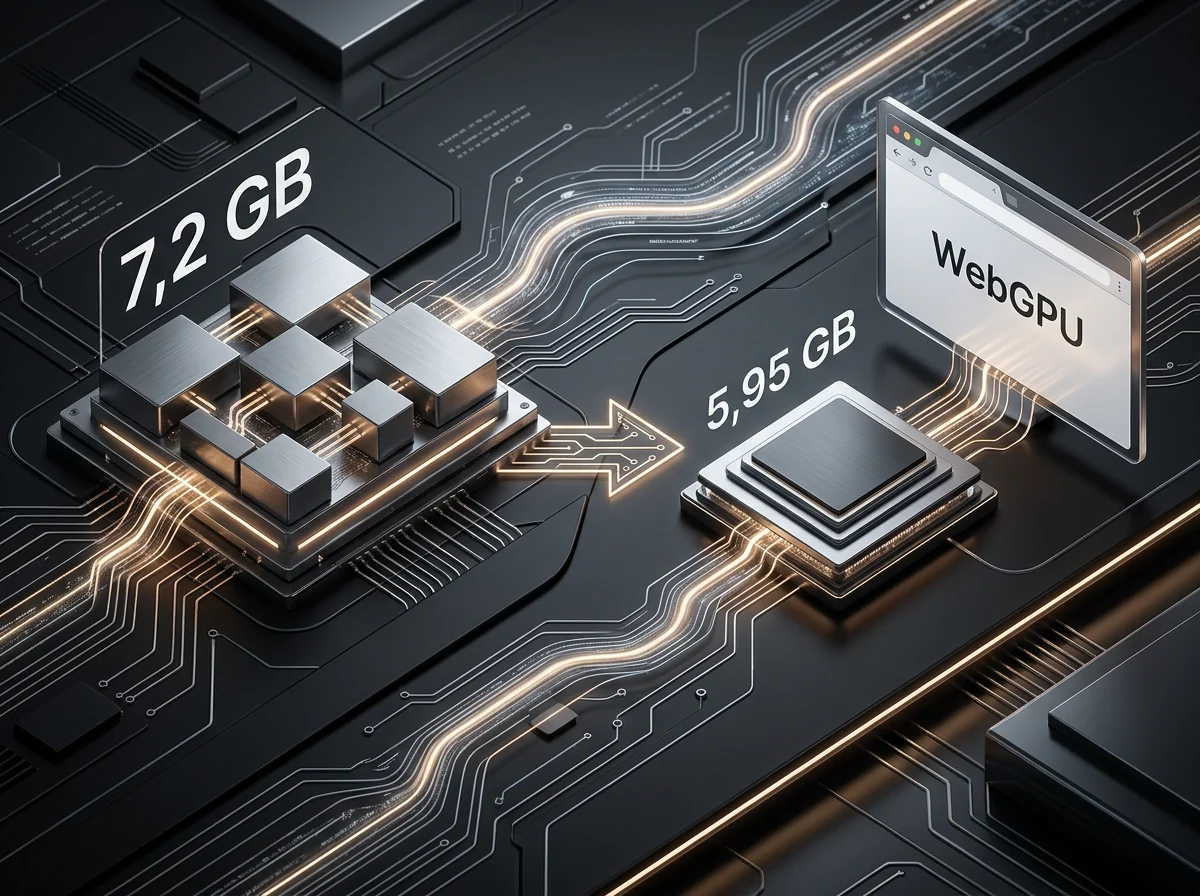
Den forrige ternære 27B-utgaven var basert på Qwen3.6-27B og brukte rundt 7,2 GB i den aktuelle GGUF-pakken. Ternary Bonsai 2 bygger på nyere Qwen3.8-27B og får den tetteste språkpakken ned til 5,95 GB. Dermed er ikke oppgraderingen bare en ny basismodell. Minnegrensen flyttes også merkbart ned.
Prism ML oppgir at den nye modellen når 84,78 i gjennomsnitt på de 14 testene, mot 80,98 for forrige Bonsai-utgave når begge regnes i samme oppsett. Det tilsvarer en oppgitt forbedring i såkalt «intelligence density» fra 0,416 til 0,469. Uttrykket er Prism MLs egen måte å måle testscore per gigabyte på, men det beskriver poenget ganske godt: mer dokumentert kapasitet i en mindre fil.
Det er akkurat denne kombinasjonen som gjør lanseringen viktig. En ny base alene er forventet. En litt mindre fil alene er hyggelig. Når begge deler skjer samtidig, og modellen i tillegg kan kjøres gjennom WebGPU, begynner dette å ligne et reelt generasjonsskifte for lokal AI.
Hvilken GGUF-pakke bør du velge?
Velg PTQ1_0 hvis minne er den harde grensen. Den er 5,95 GB og er ifølge Prism ML også raskest under generering på Ada-kort og Nvidia L4. Velg PQ2_0 hvis du har plass til 7,21 GB og vil prioritere raskere promptbehandling. Prism ML oppgir at PQ2_0 også gir raskere generering på H100, A100 og Blackwell.
Apple Silicon-brukere har i tillegg en egen MLX-utgave. Vision er ikke bakt inn i språkfilen: Den valgfrie Q8_0-filen for vision er ytterligere 0,63 GB og lastes bare når modellen skal ta imot bilder. For ren tekst trenger du den ikke.
Det viktigste er å ikke velge ut fra filstørrelsen alene. PTQ1_0 pakker verdiene tettere, men utpakkingen krever mer regning. PQ2_0 bruker litt mer minne for å gjøre jobben enklere for enkelte GPU-er. Den minste filen er derfor ikke automatisk den raskeste på all maskinvare.
Den tekniske fellen du må unngå
De nye GGUF-filene trenger Prism MLs egen llama.cpp-fork. Vanlig llama.cpp avviser PTQ1_0 og PQ2_0 som ukjente typer. Enda verre er det med en feilaktig Q2_0-fil: Den kan lastes uten advarsel, men gir meningsløst resultat fordi standardruntime mangler Hadamard-transformasjonen modellen forventer.
Løsningen er å bruke den testede binærpakken eller bygge Prism MLs llama.cpp-fork. Prism ML peker selv på Bonsai-demo-repositoriet som fasit for oppdaterte binærfiler og kjørekommandoer. For et lokalt kommandolinjeoppsett kan modellen lastes ned fra Hugging Face og startes med forkens llama-cli, full GPU-offload og ønsket kontekstlengde.
hf download prism-ml/Ternary-Bonsai-2-27B-gguf \
  Ternary-Bonsai-2-27B-PTQ1_0.gguf --local-dir .

./bin/llama-cli \
  -m Ternary-Bonsai-2-27B-PTQ1_0.gguf \
  -ngl 99 -fa on -c 32768 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  -p "Forklar ternære modellvekter enkelt." -n 256
-ngl 99 forsøker å legge alle lag på GPU-en, mens -c 32768 setter konteksten til 32 768 tokens. Modellkortet anbefaler temperatur 1,0, top-p 0,95 og top-k 20 i thinking-modus. For instruct-modus anbefales temperatur 0,7, top-p 0,80, top-k 20 og presence penalty 1,5.
Er dette modellen du bør bruke lokalt?
Hvis du vil ha mest mulig modell innenfor 6-8 GB, er Ternary Bonsai 2 en svært spennende kandidat. Den kan være særlig interessant for dokumentarbeid, kode, strukturerte oppgaver og lokale agenter der personvern eller frakoblet drift betyr noe. Apache 2.0-lisensen gjør den også langt enklere å bygge videre på enn modeller med uklare eller svært begrensende vilkår.
Hvis du trenger pålitelig norsk publiseringstekst, ferdig støtte i vanlige apper eller dokumentert stabilitet over lange agentløp, ville jeg ventet på praktiske tester. Den spesielle runtime-avhengigheten betyr også at dette foreløpig er mer krevende enn å hente en vanlig GGUF-fil inn i valgfri klient. Og 98,2 prosent på en testtabell er fortsatt ikke det samme som 98,2 prosent av nytten i din arbeidsflyt.
Men fy faen for en retning. På to måneder har denne modellfamilien gått fra en oppsiktsvekkende 27B-modell rundt 7,2 GB til en nyere base på 5,95 GB som kan åpnes i en nettleser. Dette er akkurat den typen utvikling som gjør lokal AI vanskelig å avfeie.
Ternary Bonsai 2 beviser ikke at skybaserte toppmodeller er overflødige. Den viser noe mer praktisk: Avstanden mellom «liten nok til å kjøre her» og «stor nok til å gjøre nyttig arbeid» krymper fort. Prøv WebGPU-demoen på maskinen du allerede har. Hvis den fungerer godt, har 27B-klassen nettopp blitt tilgjengelig for langt flere.
Ofte stilte spørsmål
Hvor stor er Ternary Bonsai 2 27B?
Den tetteste språkpakken, PTQ1_0, er 5,95 GB. PQ2_0-utgaven er 7,21 GB, mens FP16-basisen er rundt 54 GB. En valgfri Q8_0-pakke for vision legger til cirka 0,63 GB.
Kan Ternary Bonsai 2 kjøre på et skjermkort med 6 GB VRAM?
Selve PTQ1_0-vektene er 5,95 GB, men samlet minnebruk inkluderer også runtime og kontekst. Seks GB er derfor helt på grensen. WebGPU-demoen er den enkleste testen, mens kort med mer minne gir bedre plass til lengre kontekst.
Fungerer modellen i vanlig llama.cpp?
Nei, ikke ennå. PTQ1_0- og PQ2_0-filene krever Prism MLs llama.cpp-fork med egne ternære kjerner og riktig Hadamard-transformasjon. Vanlig llama.cpp avviser de nye filtypene, og feil Q2_0-oppsett kan produsere meningsløs tekst.
Er Ternary Bonsai 2 like god som Qwen3.8-27B i FP16?
Ikke helt. Prism ML måler 84,78 mot 86,32 i gjennomsnitt på 14 tester, altså 98,2 prosent av FP16-resultatet. Det er leverandørens benchmarkoppsett og bør ikke leses som at modellen beholder nøyaktig 98,2 prosent av kvaliteten i alle virkelige oppgaver.