Innhold Vis
Inkling-Small har åpne vekter og aktiverer bare 12 milliarder parametre per token – men navnet «Small» må tas med en god klype salt. Modellen har 276 milliarder parametre totalt, kan arbeide med tekst, bilder og lyd og støtter et kontekstvindu på opptil én million tokens.
Dette er ikke en liten modell du uten videre laster inn på en vanlig PC. Selv kraftig kvantiserte utgaver krever mye minne, og hele kontekstvinduet er en egen utfordring. «Small» handler her om at bare en mindre del av modellen er aktiv for hvert token, og at den bruker langt mindre regnekraft enn den opprinnelige Inkling-modellen.
Det mest interessante er derfor ikke navnet eller én enkelt benchmark. Thinking Machines Lab har sluppet de faktiske vektene og en NVFP4-utgave med støtte for lokal kjøring. Samtidig rapporterer selskapet ytelse på nivå med den langt større Inkling-modellen på flere resonnerings- og agentoppgaver. Det er en kombinasjon som fortjener oppmerksomhet.
Hva er Inkling-Small?
Inkling-Small er en multimodal Mixture of Experts-modell fra Thinking Machines Lab. Den har 276 milliarder parametre totalt, men aktiverer 12 milliarder for hvert token. Ifølge Thinking Machines Labs lansering 30. juli 2026 er modellen trent på Nvidia GB300 NVL72-systemer og har opptil én million tokens kontekst.
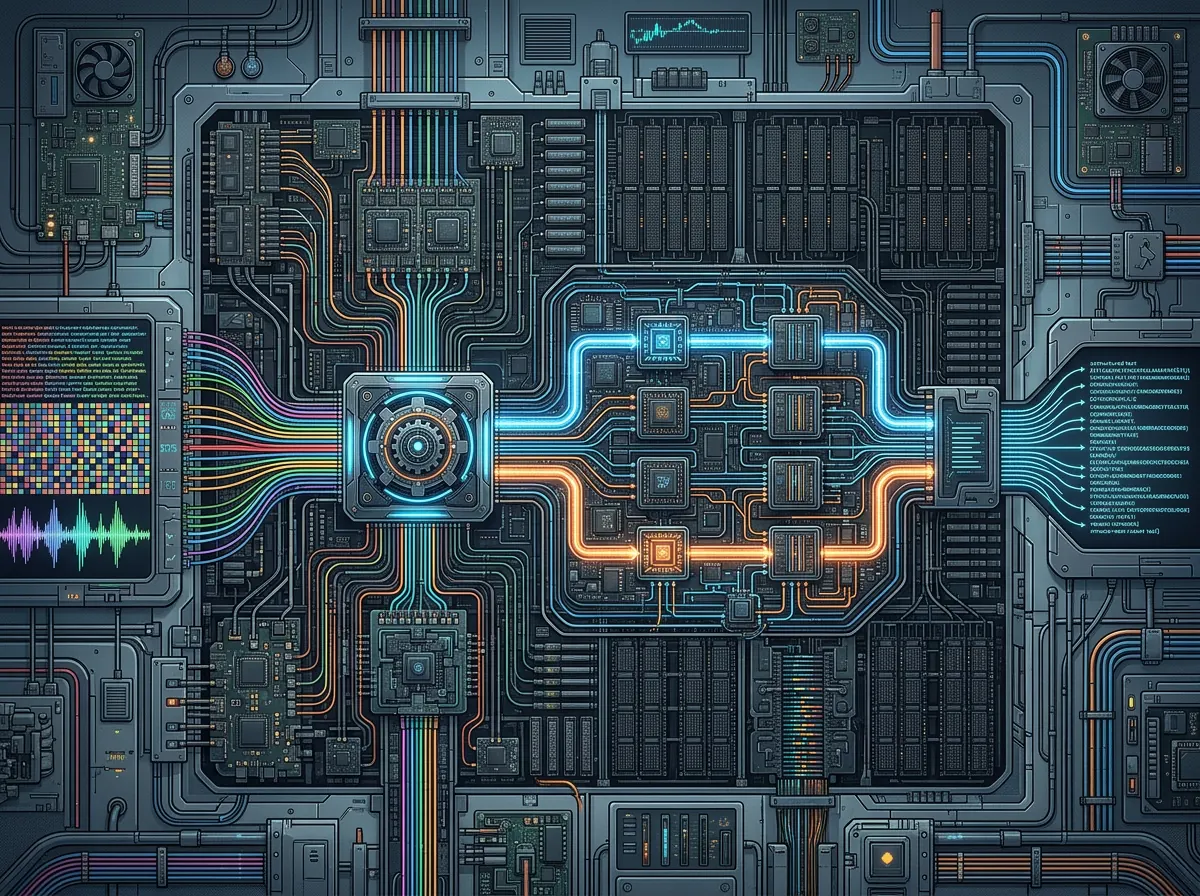
Mixture of Experts, ofte forkortet MoE, betyr at modellen består av mange spesialiserte deler, mens en ruter velger hvilke av dem som skal brukes under hver beregning. Hele modellen må fremdeles lagres i minnet, men ikke alle 276 milliarder parametrene jobber samtidig. Det er grunnen til at «12 milliarder aktive» sier noe viktig om regnebehovet, men ikke forteller hvor mye RAM eller VRAM vektene krever.
Modellen tar imot tekst, bilder og lyd og svarer med tekst. Thinking Machines har bygget den som en generalist for blant annet kodeassistenter, verktøybruk, chat, RAG-systemer og multimodale oppgaver. Den kan også variere hvor mye tid og regnekraft den bruker på å tenke. Det gir utviklere et valg mellom raskere svar og mer grundig resonnering, i stedet for at alle spørsmål behandles likt.
Hvorfor er 12 aktive milliarder interessant?
De 12 aktive milliardene er interessante fordi Inkling-Small aktiverer under en tredel så mange parametre per token som den opprinnelige Inkling-modellen. Den større modellen har 975 milliarder parametre totalt og 41 milliarder aktive. Thinking Machines rapporterer likevel at den mindre utgaven matcher eller slår forgjengeren på flere oppgaver innen resonnering, koding og verktøybruk.
Det handler ikke bare om å krympe samme oppskrift. Inkling-Small begynte treningen senere, og selskapet endret både datamiksen og treningsmetoden. En tidligere utgave ble blant annet trent videre med Inkling som lærer, før Thinking Machines kjørte to uker med ekstra trening rettet mot agentisk koding. Resultatet er en modell som ser ut til å bruke parameterne mer effektivt.
Jeg ville likevel vært forsiktig med å gjøre benchmark-tabellen til en fasit. Thinking Machines rapporterer blant annet 80,2 prosent på SWE-bench Verified og 64,7 prosent på Terminal-Bench 2.1. Selskapet opplyser samtidig at SWE-bench-resultatet bruker en bash-only testsele, mens Terminal-Bench er kjørt med en intern kodesele. Det nyttige signalet er bredere: modellen er laget for å bruke terminal og verktøy, følge lange instruksjoner og holde i en oppgave over flere steg.
Dette er samme utvikling jeg tidligere har sett med andre store MoE-modeller. GLM-5 bruker også et stort totalt parametertall for å få mer kapasitet uten å aktivere hele modellen samtidig. Inkling-Small presser den ideen videre med bare 12 milliarder aktive parametre, men minner samtidig om at effektiv beregning og liten modellfil ikke er det samme.
Kan Inkling-Small faktisk kjøres lokalt?
Ja, Inkling-Small kan kjøres lokalt, og dette er mer enn et løfte om vekter som kommer senere. Thinking Machines har publisert både BF16- og NVFP4-utgaver, mens Unsloth har lagt ut ferdige GGUF-kvantiseringer. Modellkortet nevner lokal støtte gjennom blant annet SGLang, vLLM, TokenSpeed, Unsloth og Hugging Face.
Men du trenger mye minne. I Unsloths GGUF-samling er den aller minste 1-bit-utgaven rundt 74,8 GB. 3-bit-utgavene ligger omtrent fra 97,9 til 120 GB, mens 4-bit-alternativene ligger fra cirka 127 til 163 GB. BF16-utgaven er oppgitt til 527 GB. Det er «Small» i datasenterbetydning, ikke i laptopbetydning.
CUDA kombinert med CPU-offloading kan gjøre modellen mulig å starte på maskiner som ikke har plass til alle vektene i VRAM. Det betyr at deler av modellen ligger i vanlig systemminne og flyttes eller beregnes via CPU. En bruker rapporterte at dette fungerte med en utviklingsgren av llama.cpp, men det er et tidlig brukerresultat – ikke dokumentasjon på at modellen blir rask eller praktisk på alle slike oppsett.
Den aktuelle add-inkling-grenen er en egen fork av llama.cpp, ikke hovedgrenen i prosjektet. Det er et viktig forbehold hvis du vurderer lokal drift nå. Støtten er fersk, og både ytelse, stabilitet og installasjonsmåte kan endre seg raskt. At vektene kan lastes, er første milepæl. God hastighet på din maskin er en helt annen.
Betyr én million tokens at hele kodebasen får plass?
Et kontekstvindu på én million tokens betyr at Inkling-Small teknisk kan behandle svært store mengder tekst i samme økt. Det kan være store kodebaser, lange dokumentserier eller omfattende logger. Men maksimal kontekst er en øvre grense, ikke et løfte om at lokal kjøring med hele vinduet er rimelig eller rask.
Vektene er bare én del av minnebehovet. Modellen trenger også plass til KV-cache og andre data som vokser når konteksten blir lengre. En kvantisert modell som akkurat får plass med kort kontekst, har derfor ikke nødvendigvis nok minne når du skrur vinduet opp mot én million tokens. I praksis vil de fleste lokale oppsett bruke langt mindre kontekst.
Det er heller ikke alltid lurt å fylle vinduet bare fordi det finnes. Mer materiale kan gi modellen viktig sammenheng, men det kan også gjøre det vanskeligere å finne det vesentlige. God RAG, ryddig prosjektstruktur og bevisst valg av filer er fortsatt nyttig. Millionkontekst fjerner ikke behovet for å velge riktig informasjon – den flytter bare grensen for hvor mye du kan ta med.
Er modellen virkelig åpen?
Inkling-Small er en open-weight-modell med publiserte modellfiler. Den offisielle NVFP4-utgaven på Hugging Face er merket med Apache 2.0-lisens, en kjent og forholdsvis tillatende lisens som åpner for både forskning, tilpasning og integrasjon i egne produkter.
Det gjør lanseringen mer håndfast enn modeller som bare kan prøves gjennom leverandørens API. Du kan laste ned vektene, undersøke modellen og kjøre den på egen infrastruktur. Thinking Machines gjør den også tilgjengelig for finjustering gjennom Tinker, i en Playground for tekst, bilde og lyd og via API. Modellkortet opplyser dessuten at tredjepartsleverandører tilbyr API-tilgang. Det gir flere innganger, fra ferdig tjeneste til egen drift.
Likevel er «open weights» den presise betegnelsen. Publiserte vekter betyr ikke automatisk at hele treningsdatasettet, alle treningsverktøy og hvert steg i utviklingen er åpent. Det samme skillet gjelder mange av modellene som omtales som open source. IBM Granite 4.1 viser den andre enden av skalaen med modeller på 3, 8 og 30 milliarder parametre, som er langt mer tilgjengelige for vanlige lokale maskiner.
Hva er den viktigste begrensningen?
Den tydeligste praktiske begrensningen er størrelsen. 12 milliarder aktive parametre gir lavere beregningskostnad enn tallet 276 milliarder skulle tilsi, men alle vektene må fremdeles håndteres. Det gjør Inkling-Small interessant for arbeidsstasjoner med svært mye RAM, fler-GPU-oppsett og servere – ikke til et naturlig førstevalg for en vanlig PC.
Det finnes også en faglig svakhet som er lett å overse mellom alle de sterke kode- og resonneringstallene. Thinking Machines sier selv at den opprinnelige Inkling-modellen fortsatt har bedre kunnskapsdekning og faktapresisjon. I selskapets tabell får Inkling-Small 20,6 prosent på SimpleQA Verified, mot 43,9 prosent for Inkling. Det er et kraftig signal om at god agentisk ytelse ikke automatisk betyr at modellen kan stole på egen hukommelse.
For oppgaver med verktøy, dokumenter og søk kan det være et håndterbart kompromiss. Modellen kan hente informasjon, kontrollere kilder og jobbe mot et konkret miljø. Til spørsmål der du forventer et korrekt faktasvar rett fra modellvektene, bør du være mer forsiktig. Det er egentlig en sunn påminnelse: en modell kan være svært god til å løse oppgaver og samtidig ha klare hull i det den vet.
Inkling-Small er derfor mest spennende som en effektiv, åpen arbeidsmodell for dem som har infrastrukturen. Den kombinerer multimodal input, lang kontekst, verktøybruk og variabel tenketid med åpne vekter som allerede kan lastes ned. Men den demokratiserer ikke lokal toppytelse over natten. Den flytter grensen – og krever fortsatt en temmelig stor maskin for å bli med.
Ofte stilte spørsmål
Hvor mye RAM trenger Inkling-Small?
De minste GGUF-filene starter rundt 74,8 GB, mens 3-bit-utgaver krever omtrent 98-120 GB bare til modellfilen. Du trenger i tillegg minne til kontekst og kjøring. Et realistisk oppsett bør derfor ha mer tilgjengelig RAM eller VRAM enn selve filstørrelsen.
Kan Inkling-Small kjøres på ett skjermkort?
Det avhenger av skjermkortets minne og hvor hardt modellen kvantiseres. De vanlige GGUF-utgavene er for store for de fleste enkeltkort, men CPU-offloading kan fordele arbeidet mellom VRAM og systemminne. Det kan gjøre kjøring mulig, uten at den nødvendigvis blir rask.
Støtter Inkling-Small bilder og lyd?
Ja. Inkling-Small kan ta imot tekst, bilder og lyd og genererer tekst som svar. Thinking Machines beskriver modellen som nativt multimodal, med støtte for blant annet dokumenter, diagrammer, taleinnhold og lengre lydresonnering.
Kan Inkling-Small brukes kommersielt?
Den offisielle NVFP4-utgaven er publisert med Apache 2.0-lisens, som normalt tillater kommersiell bruk, endring og distribusjon. Du må fortsatt lese lisensen og leverandørens vilkår for ditt konkrete produkt, særlig hvis løsningen håndterer sensitive eller regulerte bruksområder.