Innhold Vis
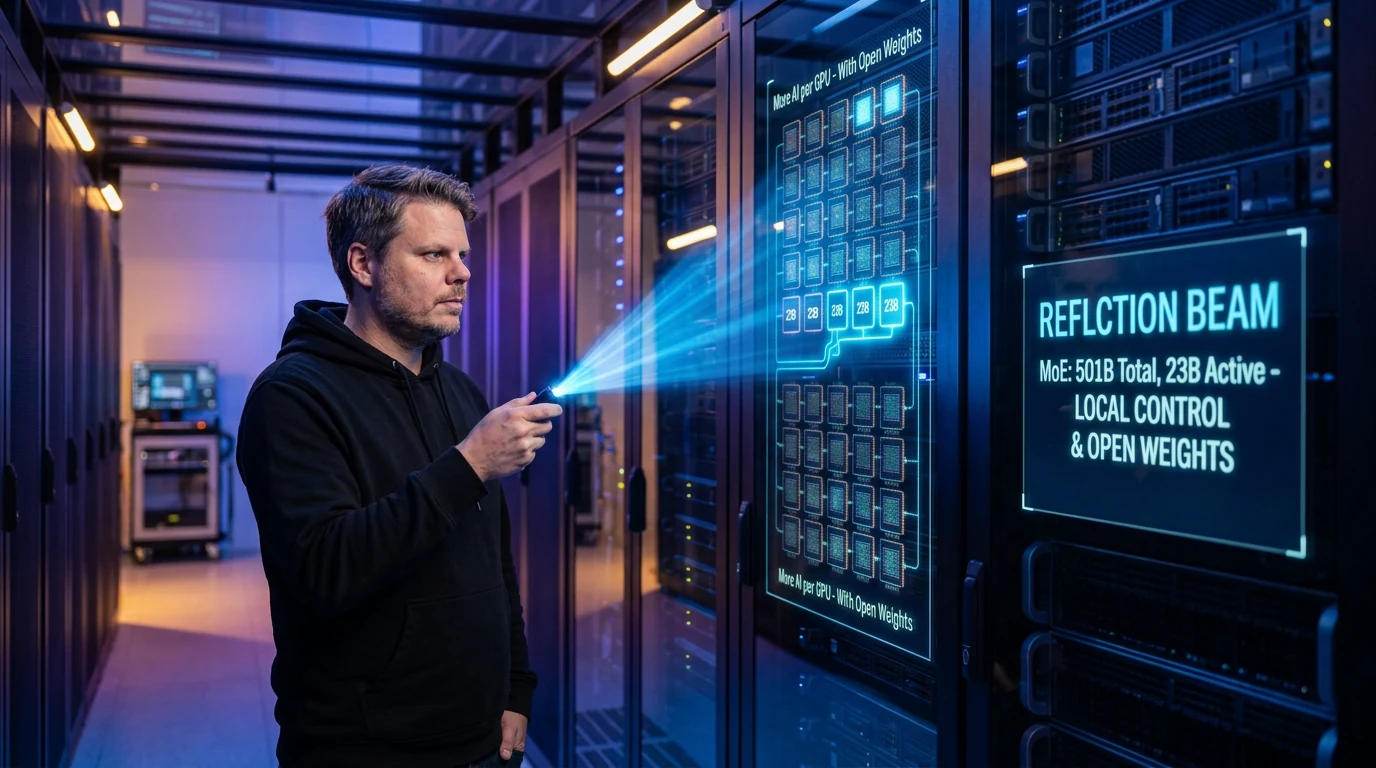
Hvis bedriften din vil kjøre AI på egen infrastruktur, tilpasse modellen med egne data og slippe å sende alt gjennom en lukket API, er Reflection Beam verdt å følge med på. Den nye modellen har 501 milliarder parametere totalt, men bruker 23 milliarder om gangen. Reflection hevder derfor at Beam kan levere konkurransedyktig koding, resonnering og agentarbeid med langt mindre inferensarbeid enn flere kinesiske toppmodeller.
Det er en retning jeg liker. Åpne modellvekter gir utviklere og virksomheter mer kontroll, flere leverandører å velge mellom og en reell mulighet til å bygge noe som ikke forsvinner fordi et amerikansk selskap endrer pris, vilkår eller modell over natten. Konkurransen fra DeepSeek, Qwen og Z.ai har presset denne utviklingen framover. Nå prøver Reflection å svare med en amerikansk modell som er bygget for samme virkelighet.
Men Beam kan ikke lastes ned ennå. 6. oktober 2026 er modellen fortsatt i sluttfasen av sikkerhetstesting, og Reflection lover vekter, modellkort, teknisk rapport og utviklerverktøy senere i oktober. Dette er altså en lovende forhåndsvisning, ikke en ferdig modell jeg vil anbefale noen å flytte produksjonen sin til i dag.
Hva er Reflection Beam?
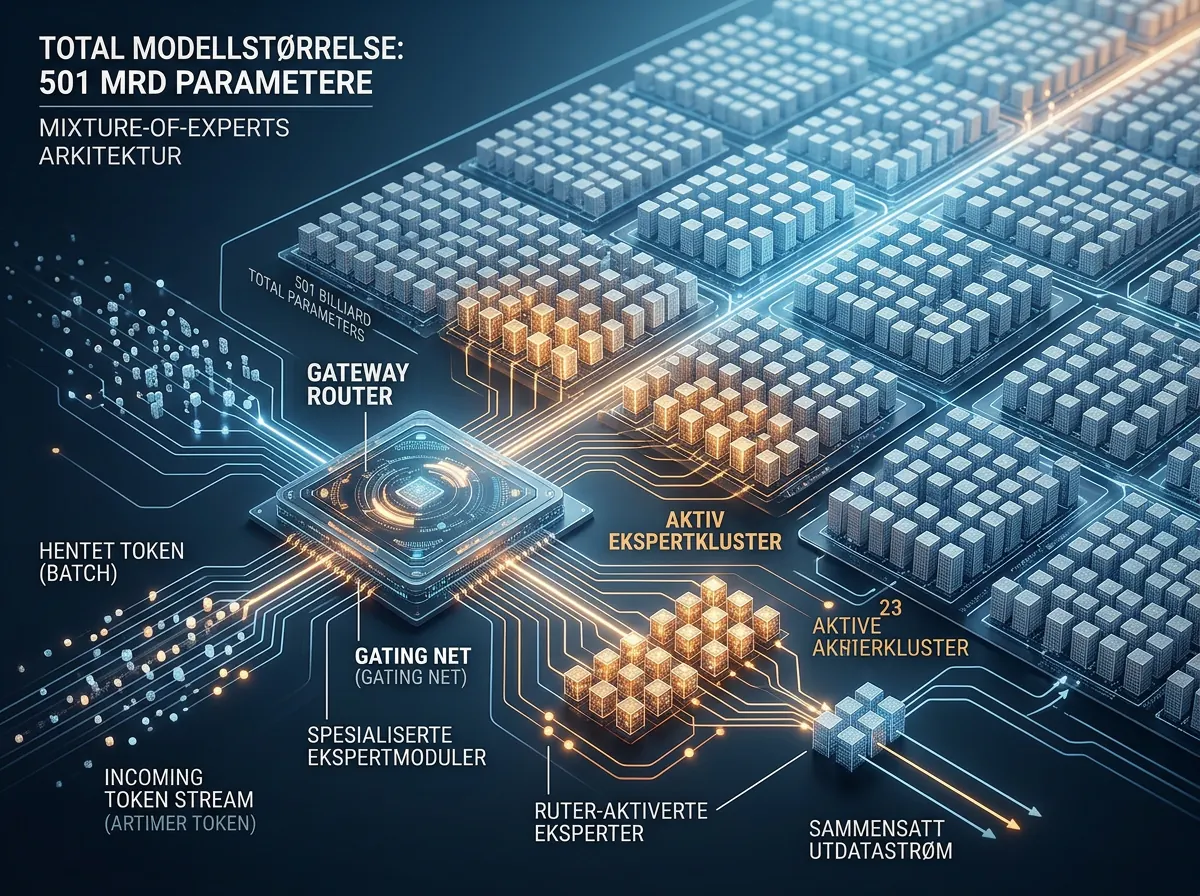
Reflection Beam er en tekstbasert Mixture-of-Experts-modell for koding, resonnering og AI-agenter. Ifølge Reflections offisielle presentasjon 5. oktober 2026 har modellen 501 milliarder parametere totalt, 23 milliarder aktive parametere per token og et kontekstvindu på opptil 1 million tokens.
Mixture-of-Experts betyr at hele modellen ikke regner på hvert eneste token. En ruter sender arbeidet gjennom et mindre utvalg eksperter. Dermed kan modellen lagre mye kapasitet i de samlede vektene, mens beregningsarbeidet per token ligger nærmere de 23 milliarder parameterne som faktisk aktiveres.
Det er viktig å skille beregning fra lagring. Beam blir ikke en vanlig 23B-modell bare fordi 23 milliarder parametere er aktive. Alle de 501 milliardene må fortsatt lagres og gjøres tilgjengelige for inferens. Før Reflection publiserer filene, støttede kvantiseringer og konkrete maskinvareoppsett, vet vi ikke hvor praktisk modellen blir utenfor store servermiljøer.
Reflection trente basemodellen på 23,8 billioner tokens. Den etterfølgende RL-kjøringen brukte mer enn 100 millioner utrullinger på 10 500 Nvidia GB300-GPU-er i fire uker. Det er ikke et lite open source-prosjekt som har fått låne et par kort over helgen. Beam er et forsøk på å bygge en åpen toppmodell med den samme industrielle tyngden som de lukkede laboratoriene.
Hvorfor betyr 23 milliarder aktive parametere noe?
De 23 milliarder aktive parameterne er kjernen i Beam-løftet: Modellen skal bruke mindre beregning per generert token uten å gi avkall på kapasiteten i en langt større modell. Reflection sier at Beam oppnår resultater på nivå med GLM-5.2 i avansert resonnering med 3-4 ganger mindre inferensarbeid.
Det kan få stor praktisk betydning. AI-agenter bruker ofte mange tokens mens de planlegger, leser kode, kaller verktøy, retter feil og prøver på nytt. En liten forskjell i beregning per token kan derfor bli en stor forskjell når tusenvis av oppgaver kjører hver dag. Bedrifter kjøper ikke benchmarkpoeng. De kjøper utført arbeid per time og per krone.
Samtidig er 3-4-gangerstallet ikke en målt pris på en ekte produksjonsfaktura. Reflection har beregnet inferensarbeidet fra aktive parametere og genererte tokens. Selskapet sier selv at regnestykket ikke inkluderer blant annet behandling av prompten, kontekstavhengig attention eller kostnadene ved serverdrift. Det er et nyttig estimat, men ikke det samme som dokumentert totaløkonomi.
Og resultatene er foreløpig leverandørens egne. TechCrunch påpeker at ytelsespåstandene ikke er uavhengig verifisert. Det er akkurat derfor de varslede vektene og den tekniske rapporten betyr mer enn en pen tabell på lanseringsdagen.
Er Beam bedre enn de kinesiske modellene?
Nei, ikke som en generell og dokumentert konklusjon. Reflection viser Beam på nivå med GLM-5.2 i flere oppgaver og nær Qwen 3.8-Max på koding og agentarbeid, men selskapet erkjenner også at Kimi K3 fortsatt ligger foran på rå kapasitet. Beam skal først og fremst vinne på effektivitet, ikke på å toppe absolutt alle tester.
Det er en mer troverdig historie enn å erklære en ny verdensmester etter én leverandørtabell. Reflections egne resultater viser at Beam ligger bak Kimi K3 på krevende kode- og terminaloppgaver. Det peker mot en sterk modell, men også mot et tydelig gap. Uavhengige tester må avgjøre hvor mye av effektivitetsfordelen som overlever i reell drift.
Likevel er dette viktig. DeepSeek viste hvor voldsomt kinesiske modeller kunne presse pris og tilgjengelighet. Qwen, Kimi og GLM har fortsatt å flytte grensene for hva utviklere får med åpne vekter. Et vestlig alternativ som kommer nær ytelsen med mindre inferensarbeid, kan gi markedet den konkurransen det trenger.
Beam bør også sammenlignes med Inkling fra Thinking Machines Lab, som er multimodal og dermed en annen type modell. Reflections egne tester viser Beam foran Inkling på fire kodeprøver der begge har resultater. Det er verdt å merke seg, men tekstmodellen Beam kan ikke uten videre erklæres bedre enn en modell som også arbeider direkte med andre medier.
Hva er en AI-fabrikk?
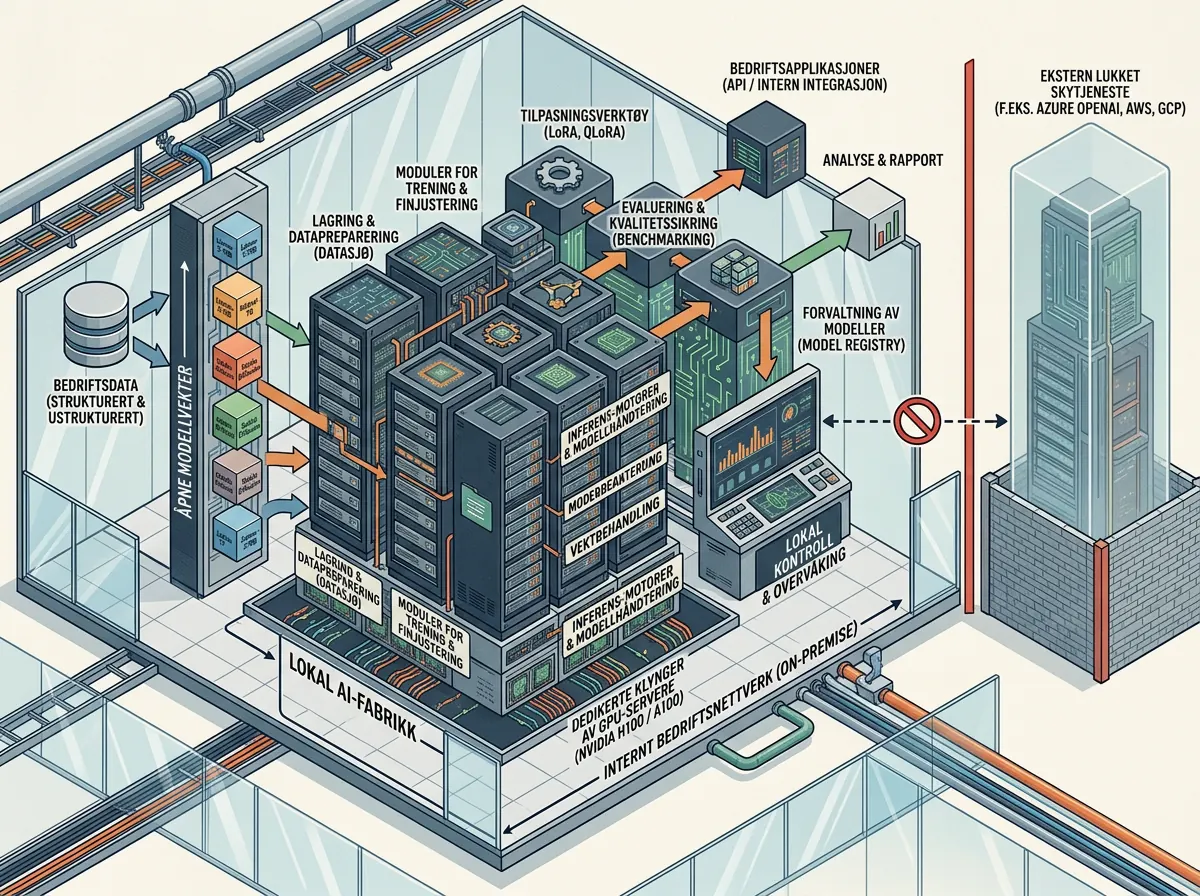
En AI-fabrikk er Reflections navn på en komplett, lokal AI-plattform: åpne modellvekter, programvare for å kjøre og tilpasse modellen, maskinvare og ferdige løsninger på toppen. Målet er at en virksomhet skal kunne trene eller finjustere egne varianter på egne data og beholde driften i privat sky, eget datasenter eller et fysisk isolert miljø.
Det er en ganske annen vare enn et abonnement på en chatbot. Reflection retter seg mot store bedrifter og land som vil eie mer av modellkjeden selv. Finansmiljøer kan holde proprietære data innenfor sin egen infrastruktur. Offentlige virksomheter kan kontrollere hvor systemet kjører. Utviklere kan bygge videre uten å være låst til én lukket modell og én leverandørs API.
Reflection beskriver infrastrukturen som en full stabel med åpne vekter, åpen programvare, beholdere og oppskrifter for tilpasning. Selskapet vil samtidig tilby sin egen API-plattform. Det er en fornuftig kombinasjon: Åpne vekter betyr ikke at alle må eie et datasenter, bare at de som trenger kontroll faktisk har et valg.
Her ligger den virkelige utfordringen til de lukkede laboratoriene. En god modell er viktig, men kontroll over data, tilpasning, drift og leverandørvalg kan være viktigere når AI går fra eksperiment til kritisk infrastruktur. Et inferenslag med mange modeller kan redusere låsing i skyen. Åpne vekter flytter den samme friheten enda lenger ned i stabelen.
Kan du kjøre Beam lokalt?
Ja, det er planen, men «lokalt» betyr ikke nødvendigvis på én arbeidsstasjon. Reflection lover Apache 2.0-lisens og hele stabelen for kjøring, evaluering og finjustering senere i oktober. Selskapet omtaler alt fra privat sky til fysisk isolert infrastruktur, men har ennå ikke publisert de maskinvarekravene utviklere trenger for å planlegge et konkret oppsett.
501 milliarder totale parametere gjør lagring og minnebåndbredde til en betydelig oppgave selv om bare 23 milliarder brukes per token. Kvantisering kan redusere plassbehovet, og ekspertarkitekturen kan gjøre selve inferensen mer effektiv. Det endrer ikke at alle vektene må finnes et sted. Ikke les «23B aktiv» som «passer på et vanlig skjermkort».
Det mest fornuftige er å vente på tre ting: de faktiske vektfilene, dokumenterte kjøreoppsett og målinger fra uavhengige brukere. Først da kan vi sammenligne hastighet, minnebruk, kvalitet etter kvantisering og total kostnad mot Qwen, GLM, Kimi og lukkede API-er på samme maskinvare og samme oppgaver.
Hva bør bedrifter gjøre nå?
Bedrifter med et reelt behov for lokal AI bør sette Beam på testlisten, ikke på innkjøpslisten. Meld interesse for tidlig tilgang hvis koding, agentarbeid eller lange dokumenter er viktige arbeidslaster. Forbered samtidig et lite, representativt testsett med egne oppgaver, krav til svartid og en ærlig kostnadsmodell.
Ikke bruk tid på å gjenskape hele virksomheten som en benchmark. Velg oppgaver som faktisk koster penger eller skaper risiko: feilretting i egne kodebaser, søk i interne dokumenter, verktøykall og lange agentløp. Sammenlign Beam med modellen du bruker i dag, og mål både kvalitet, antall tokens, tidsbruk, maskinvare og hvor ofte mennesker må rydde opp.
Jeg er oppriktig positiv til retningen. Jeg vil ha sterke modeller med åpne vekter som kan kjøres og tilpasses uten tillatelse fra ett lukket laboratorium. Beam kan bli en viktig del av den utviklingen, særlig hvis Reflection leverer Apache 2.0-vekter og en brukbar driftsstabel som lovet.
Men nå må filene på bordet. En åpen modell som kommer senere, er ikke åpen programvare du kan bygge på i dag. Når vektene, modellkortet og den tekniske rapporten er ute, kan uavhengige utviklere kontrollere både ytelsen og regnestykket. Det er da Beam går fra et imponerende løfte til et reelt alternativ.
Ofte stilte spørsmål
Er Reflection Beam tilgjengelig for nedlasting nå?
Nei. 6. oktober 2026 er Beam tilgjengelig som en begrenset forhåndsvisning, mens Reflection fortsatt gjennomfører sikkerhetstesting. Selskapet sier at modellvekter, modellkort, teknisk rapport og utviklerverktøy skal publiseres senere i oktober.
Er Beam en 23B- eller 501B-modell?
Beam har 501 milliarder parametere totalt og aktiverer 23 milliarder per token. Det aktive tallet sier mest om beregningsarbeidet under inferens. Det totale tallet er fortsatt viktig for lagring, minne, distribusjon og hvilken maskinvare som trengs.
Er Beam åpen kildekode?
Reflection lover modellvekter under Apache 2.0 og åpen programvare for kjøring, evaluering og finjustering. Inntil filene og lisensvilkårene faktisk er publisert, er det mest presist å omtale Beam som en varslet open-weight-modell, ikke en ferdig nedlastbar utgivelse.
Vil Beam bli billigere enn DeepSeek, Qwen og GLM?
Det vet vi ikke ennå. Reflection anslår 3-4 ganger mindre inferensarbeid enn GLM-5.2 på enkelte resonneringstester, men dette er ikke en komplett måling av serverkostnad. Reell pris avhenger også av maskinvare, programvare, kontekst, svartid og utnyttelsesgrad.