Innhold Vis
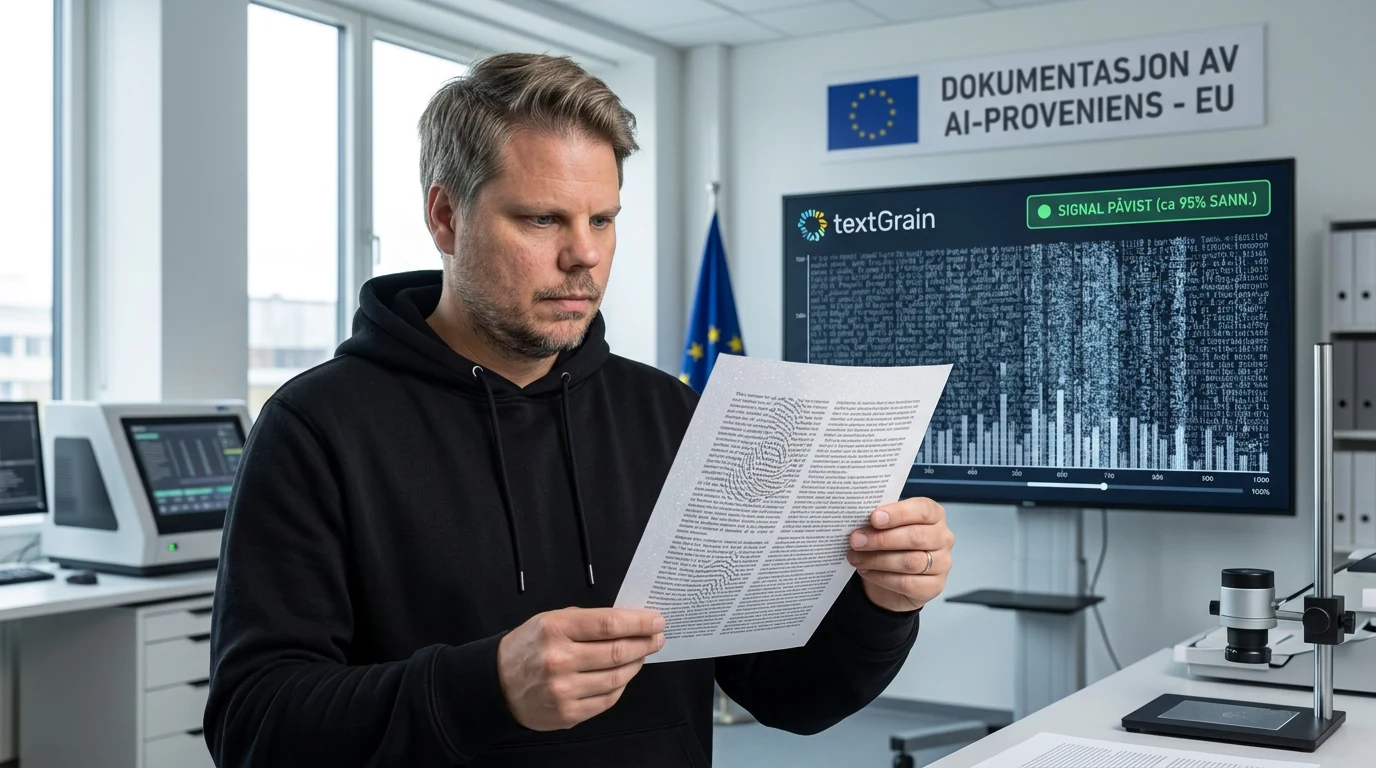
Bruker du ChatGPT eller Codex i EU, får kvalifisert tekst snart et usynlig tekstvannmerke. OpenAI kaller teknologien textGrain og ruller den ut på alle abonnementer i løpet av de kommende ukene. Vannmerket ligger ikke i skjulte tegn eller metadata. Det bygges inn i selve ordvalgene mens modellen skriver.
Det høres mer bombesikkert ut enn det er. OpenAIs egen detektor fant rundt 95 prosent av vannmerkene i 400 tokens med vanlig prosatekst, men bare rundt 80 prosent i tekst på 200 tokens. Bytt ut en fjerdedel av ordene med synonymer, og treffraten falt helt ned til 17 prosent i selskapets forsøk.
Dette er derfor ikke en maskin som kan avgjøre hvem som har skrevet en tekst. Den kan finne et statistisk spor etter OpenAIs modeller, men sier ingenting sikkert om menneskelig arbeid, eierskap, ansvar eller om teksten er sann. Likevel får millioner av europeiske brukere nå dette signalet bakt inn i formuleringene sine fordi EUs AI Act krever maskinlesbar merking.
Hva er textGrain?
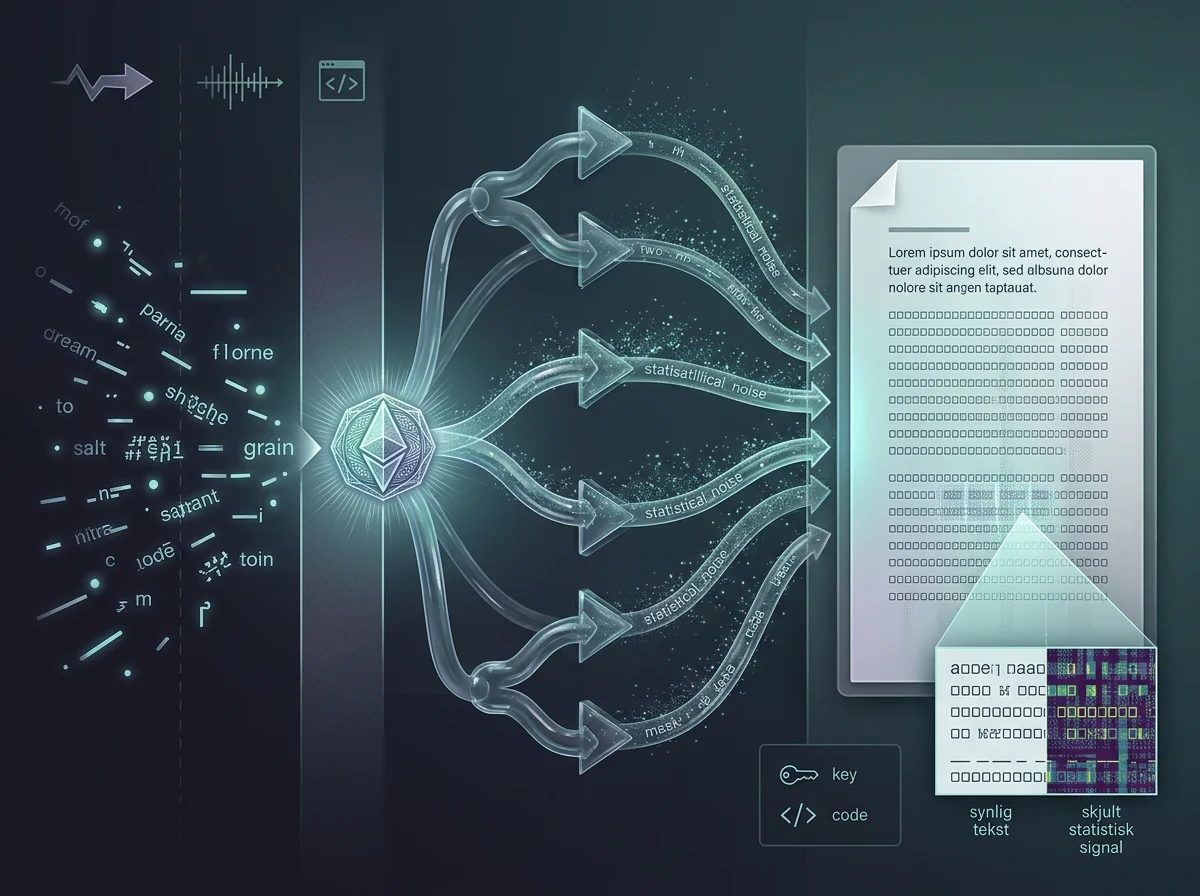
textGrain er OpenAIs metode for å legge et statistisk mønster i modellens valg av ord og ordfragmenter. Ifølge OpenAIs kunngjøring 5. oktober 2026 bruker detektoren det samme hemmelige mønsteret til å vurdere om en tekst sannsynligvis inneholder selskapets vannmerke.
Når en språkmodell skriver, beregner den flere mulige neste tokens og hvor sannsynlige de er. textGrain lager flere justerte fordelinger som favoriserer ulike valg. En hemmelig nøkkel bestemmer hvilken fordeling modellen bruker i hvert steg, og over en lengre tekst dannes et mønster som detektoren kan lete etter.
OpenAI understreker i den tekniske forklaringen av textGrain at systemet ikke legger til skjulte tegn, usynlige mellomrom, merkelig tegnsetting eller egne vannmerke-tokens. Kopiering og innliming fjerner derfor ikke automatisk signalet. Det er ordlyden som bærer det.
Det betyr også at ingen skal kunne lese ut kontoen, organisasjonen, prompten eller samtalen din fra teksten. Vannmerket er et signal om at en støttet OpenAI-modell sannsynligvis har generert eller behandlet teksten. Det er ikke et serienummer knyttet til personen bak.
Hvem får vannmerket?
OpenAI starter i EU. I løpet av de kommende ukene skal kvalifisert tekst fra ChatGPT og Codex få textGrain på tvers av alle abonnementer. API-kunder kan samtidig slå på tekstvannmerking for utvalgte modeller over hele verden, men funksjonen er frivillig og avslått som standard i API-et.
Dette skillet er viktig. En bedrift som bruker ChatGPT eller Codex i EU, får ikke nødvendigvis samme valg som en utvikler som kaller en OpenAI-modell gjennom API-et. API-kunden kan aktivere funksjonen for et enkelt prosjekt eller for hele organisasjonen, mens OpenAI beskriver EU-utrullingen i ChatGPT og Codex som en del av produktet.
Korte svar og kode er også vanskelige å merke pålitelig. EUs retningslinjer krever derfor ikke vannmerking av svar under 200 tokens – omtrent 150 engelske ord – eller av kodebiter. Det gir mening teknisk: En modell har langt færre naturlige formuleringer å velge mellom i en presis ligning eller en fungerende kodesnutt enn i et essay.
For Codex er det altså særlig den vanlige prosateksten rundt arbeidet som er egnet for denne typen signal. Ikke les overskriften som at hver parentes og kodelinje plutselig får et hemmelig stempel. OpenAI bruker selv ordet «eligible» om hvilke tekstutdata som omfattes.
Det er heller ikke en liten detalj når ChatGPT og Codex trekkes stadig tettere sammen. Samme person kan bruke vanlig chat til research og Codex til å skrive dokumentasjon, planer og forklaringer. Vannmerket følger teksttypen og produktreglene, ikke leserens forestilling om hva som er «chat» og hva som er «kode».
Hvor pålitelig er det?
Ikke pålitelig nok til å være en dommer. Med andelen falske positive satt til 1 prosent fant OpenAIs detektor omtrent 80 prosent av vannmerkede passasjer på 200 tokens og rundt 95 prosent ved 400 tokens i prosatekst om psykologi. Resultatene var betydelig svakere i matematikk, der ordvalget er mer bundet.
Vanlig redigering svekker signalet fort. I testen med engelske tekster på 400 tokens startet deteksjonen på rundt 92 prosent. Da 10 prosent av ordene ble erstattet med synonymer, falt den til 66 prosent. Ved 25 prosent utskifting var bare 17 prosent av vannmerkene igjen påviselige.
Språk spiller også inn. OpenAI testet 500 syntetiske engelske prompter oversatt til alle de 24 offisielle EU-språkene. Ved 1 prosent falske positive var treffraten 69 prosent for spansk og 42,2 prosent for rumensk før ekstra justering av styrken. Det er et ganske voldsomt spenn for et system som skal fungere på tvers av én region.
OpenAI sier at vanlige kvalitetstester ikke viser noen meningsfull nedgang med vannmerket, og at hastighetsforskjellen er ubetydelig. Det er positivt for bruken av ChatGPT og Codex. Men det løser ikke hovedproblemet: Et signal kan være usynlig og billig å legge til, samtidig som det er for skjørt til å bære en alvorlig anklage mot et menneske.
Et treff beviser ikke AI-juks
Et positivt treff betyr ikke at OpenAI skrev hele teksten. Modellen kan ha redigert et menneskeskrevet utkast, foreslått enkelte avsnitt eller generert en versjon som senere ble grundig bearbeidet. Detektoren måler ikke hvor mye menneskelig vurdering, kreativitet eller arbeid som ligger i sluttresultatet.
Den fastslår heller ikke hvem som eier teksten, hvem som er juridisk ansvarlig, eller om innholdet er riktig. Og motsatt: Manglende treff beviser ikke at teksten er menneskeskrevet. Den kan være kort, oversatt, omskrevet, laget før utrullingen eller produsert av en annen AI-tjeneste.
Dette er nettopp grunnen til at OpenAI ikke åpner tekstdetektoren for alle ved lansering. Tilgangen begrenses først til godkjente forskere og ekspertorganisasjoner. The Verge beskriver utrullingen som maskinlesbar merking, men i praksis kan en vanlig lærer, redaktør eller arbeidsgiver ikke bare lime inn en tekst i et offentlig OpenAI-verktøy og få et svar.
Det kan være fornuftig å holde en usikker detektor unna fri massebruk. Samtidig er det en pussig løsning: EU krever et maskinlesbart merke i teksten til vanlige brukere, mens muligheten til å lese merket blir forbeholdt en liten godkjent krets. Byråkratiet har altså klart å gi oss et stempel de fleste ikke får se.
Hvorfor rulles vannmerket ut i EU?
Utrullingen er et direkte svar på artikkel 50 i EUs AI Act. EU-kommisjonens veiledning sier at leverandører av generativ AI skal merke syntetisk lyd, bilde, video og tekst i et effektivt, robust og maskinlesbart format.
Reglene begynte å gjelde 2. august 2026. Systemer som allerede var på markedet før den datoen, fikk en begrenset overgang til 2. desember 2026 for selve merke- og deteksjonskravet. Mulige bøter kan komme opp i 15 millioner euro eller 3 prosent av global årsomsetning. Da er det ikke overraskende at OpenAI prioriterer en regional utrulling.
Hensikten – å gi folk mer informasjon om hvor innhold kommer fra – er lett å forstå. Haken er at lovspråk som ber om et «robust» merke ikke gjør en statistisk metode robust i den virkelige verden. Tekst kan oversettes, forkortes og skrives om på sekunder. OpenAIs egne tall viser hvor raskt signalet forsvinner.
Store selskaper kan bygge egne systemer, søke om detektortilgang og bemanne enda en compliance-funksjon. Små aktører og vanlige brukere får derimot nye spørsmål om hva som merkes, hvem som kan kontrollere det og hvordan et feilaktig treff skal håndteres. Som så ofte går de største rett gjennom porten, mens de små blir stående og lese skiltet.
Hva bør du gjøre med dette?
Du trenger ikke begynne å lete etter usynlige tegn i ChatGPT-svar. De finnes ikke. Hvis du kopierer teksten til WordPress, e-post eller et dokument, er det ordvalgene som eventuelt bevarer signalet. Vanlig språkvask kan svekke det, mens omfattende omskriving eller oversettelse kan gjøre det umulig å oppdage.
Bruker du AI profesjonelt, bør du uansett bevare det som faktisk dokumenterer arbeidet: kilder, notater, versjonshistorikk, egne endringer og hvem som godkjente sluttresultatet. Det forteller mye mer om kvalitet og ansvar enn et binært detektortreff. For skoler og arbeidsgivere bør hovedregelen være enkel: Ingen skal anklages for juks eller uredelighet på grunnlag av en tekstmarkør alene.
API-kunder som vil bruke vannmerket, kan aktivere «Allow text watermarking» i prosjekt- eller organisasjonsinnstillingene og velge støttede modeller. Men aktivering gir ikke automatisk tilgang til detektoren. Test derfor hele publiseringsflyten og avklar hva signalet faktisk skal brukes til før funksjonen blir en del av en kundeløsning.
TextGrain er et teknisk interessant forsøk på å etterlate et spor uten å ødelegge teksten. Det er bare ikke et fasitsvar. Behandle det som et svakt opphavssignal, aldri som bevis på forfatterskap, sannhet eller skyld. Hvis myndigheter, skoler eller bedrifter glemmer den forskjellen, blir vannmerket fort farligere enn teksten det skulle forklare.
Ofte stilte spørsmål
Kan andre se at en tekst fra ChatGPT har vannmerke?
Ikke med øynene. textGrain endrer det statistiske mønsteret i modellens ordvalg og krever en kompatibel detektor. OpenAI begrenser ved lansering tilgangen til tekstdetektoren til godkjente forskere og ekspertorganisasjoner.
Inneholder vannmerket personopplysninger eller prompten min?
Nei. OpenAI sier at signalet ikke identifiserer bruker, konto, organisasjon, prompt eller samtale. Det kan indikere at en støttet OpenAI-modell har behandlet teksten, men ikke hvem som brukte modellen.
Forsvinner textGrain når teksten kopieres?
Vanlig kopiering fjerner ikke nødvendigvis vannmerket fordi signalet ligger i ordlyden, ikke i metadata eller skjulte tegn. Omskriving, synonymbytte og oversettelse kan derimot svekke signalet kraftig eller gjøre det umulig å oppdage.
Kan et vannmerke bevise at en elev eller ansatt har jukset?
Nei. Et treff viser ikke hvor mye et menneske har skrevet eller redigert, og falske positive kan forekomme. Et manglende treff beviser heller ikke menneskelig forfatterskap. Kilder, arbeidsprosess og versjonshistorikk må vurderes sammen med andre opplysninger.