Innhold Vis
Audio8-TTS-Realistic kombinerer en hovedmodell på 601 millioner parametere med zero-shot stemmekloning, 23 språk og en medfølgende 44,1 kHz-lydkodek. Norsk er med. Det gjør modellen langt mer interessant enn størrelsen skulle tilsi.
Du gir modellen et lydopptak og en nøyaktig transkripsjon, og den kan lage ny tale med stemmen fra opptaket uten at du trener en egen stemmemodell først. Både kode og modellvekter er gitt ut med Apache 2.0-lisens, så dette er en modell som faktisk kan lastes ned, kjøres lokalt og bygges videre på.
Det mest spennende er likevel ikke bare at Edge0 har fått mye inn i en liten pakke. Selskapet har avsluttet treningen med en egen realisme-kritiker og GRPO, der modellen belønnes for tale som ligner menneskelig levering bedre. Resultatene er lovende, men norsk på språklisten er ikke det samme som dokumentert naturlig norsk tale. Den forskjellen er viktig.
Hva er Audio8-TTS-Realistic?
Audio8-TTS-Realistic er en åpen tekst-til-tale-modell med 601 159 424 parametere i hovedmodellen. Den støtter zero-shot stemmekloning fra ett referanseopptak, dekker 23 språk og leveres med kodek, tokenizer, prosessor og egen Transformers-kode i den komplette modellpakken på Hugging Face.
«Zero-shot» betyr her at modellen ikke trenger separat finjustering på stemmen du vil bruke. Den får et rent referanseopptak sammen med den eksakte teksten som leses i opptaket. Deretter kan den generere annen tekst med egenskapene fra referansestemmen. Modellen kan også lage tale uten referanse, men stemmekloningen er den tydeligste bruksverdien.
Realistic-utgaven bygger på Audio8-TTS-Preview-0.6B. Den beholder samme grunnarkitektur, men utvider språkdekningen fra 11 til 23 språk. De 12 nye språkene er arabisk, finsk, hindi, indonesisk, malayisk, norsk, portugisisk, russisk, svensk, thai, tyrkisk og vietnamesisk.
Dette er en konkret oppgradering, ikke bare en modell med nytt navn. Edge0 oppgir bedre prosodi og mer uttrykksfull levering, samtidig som modellen beholder den kompakte størrelsen. At norsk nå er eksplisitt støttet, gjør utgivelsen relevant for langt flere her hjemme enn Preview-modellen var.
Hvorfor er en modell på 0,6B interessant?
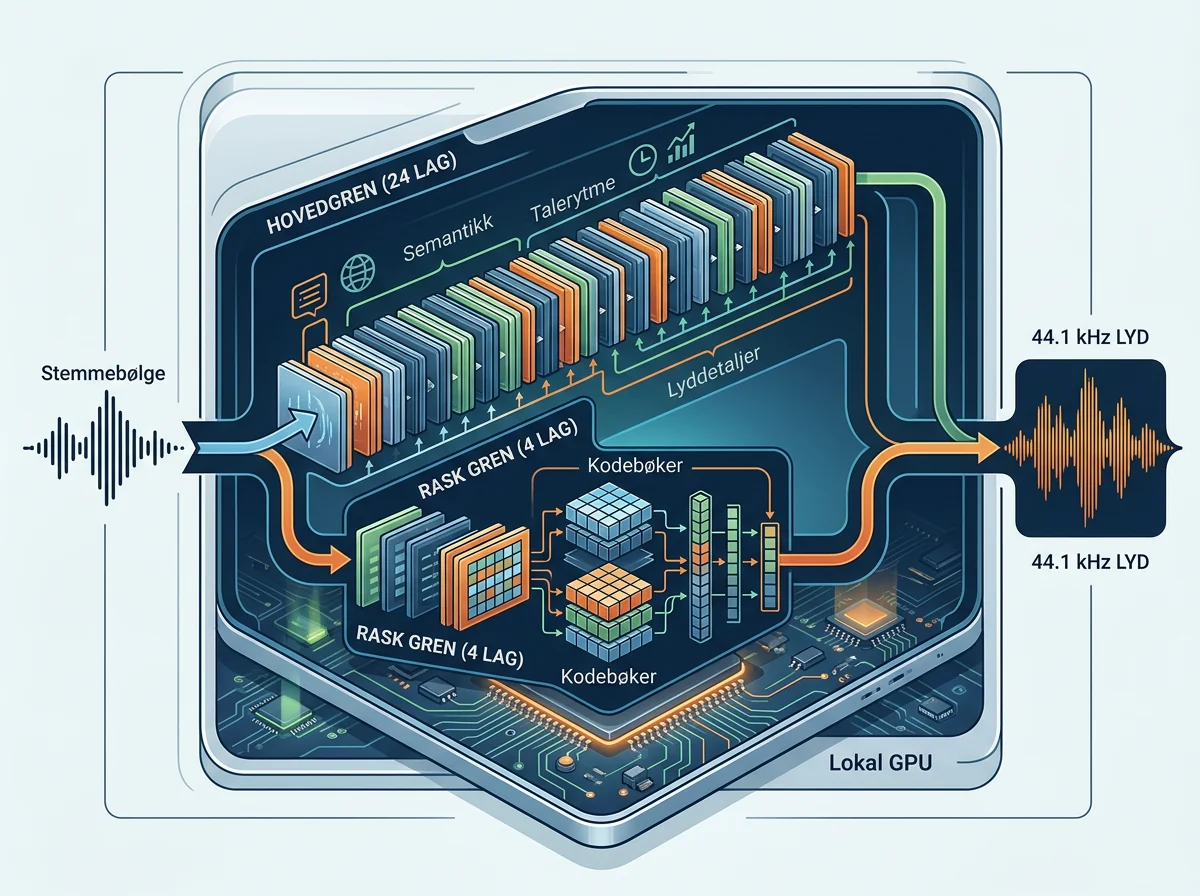
En hovedmodell på 0,6B er liten i dagens tale-AI-marked. Audio8 bruker en todelt autoregressiv arkitektur der en langsom gren lager ett semantisk lydtoken per ramme, mens en grunnere, rask gren lager de resterende kodebøkene. Poenget er å holde den sekvensielle jobben på rammenivå i stedet for å generere hver eneste lyddetalj etter tur.
Den langsomme delen har 24 lag, mens den raske har 4. Hver lydramme består av 10 koder hentet fra kodebøker med 4 096 oppføringer, og den medfølgende kodeken arbeider med 44,1 kHz lyd. Selve kodeken er ikke regnet med i tallet på 0,6B parametere, så modellnavnet beskriver hovedmodellen – ikke absolutt alt som må lastes inn.
Arkitekturen er inspirert av Fish Audio S2 Pro, og den langsomme grenen er basert på Qwen2.5 0.5B. Det er ikke magi. Det er ganske nøktern ingeniørkunst: bruk mesteparten av kapasiteten på strukturen i talen og en langt grunnere del på detaljene i hver ramme.
Edge0 anbefaler Python 3.10 eller nyere og en CUDA-kompatibel GPU. Transformers-pakken ble kontrollkjørt på en NVIDIA H20 med BF16, PyTorch 2.8.0 og Transformers 4.57.3. Det dokumenterer at pakken laster og genererer i det miljøet. Det dokumenterer ikke hvilken fart eller minnebruk du får på et vanlig forbrukerkort.
Hva gjør realisme-treningen annerledes?
Edge0 trente en kritiker til å vurdere generert tale opp mot et menneskelig opptak av samme setning og stemme. Kritikerens signal ble deretter brukt i de siste GRPO-stegene, slik at Audio8 kunne belønnes for mer menneskelig rytme, prosodi og levering – ikke bare lav ordfeilrate.
Det er et fornuftig grep. En TTS-modell kan uttale alle ordene riktig og fremdeles høres ut som den leser en bruksanvisning med livet tappet ut av seg. Ordfeilrate og stemmelikhet fanger viktige egenskaper, men de sier ikke alene om talen oppleves naturlig.
I den tekniske rapporten om Audio8-TTS beskriver forskerne en kritiker som kombinerer en frosset WavLM-front med eksplisitte prosodiske trekk. Den ble kontrollert på 5 600 setning-stemme-grupper, til sammen 89 600 syntetiske ytringer i tillegg til matchede menneskeopptak. De siste to treningsstadiene bruker GRPO: først med ordfeilrate og stemmelikhet, deretter med realisme som belønning.
På de ni kjernespråkene i CV3 falt gjennomsnittlig feilrate fra 5,41 prosent etter vanlig veiledet finjustering til 4,86 prosent etter realisme-stadiet. Stemmelikheten steg samtidig fra 0,639 til 0,661. For de 13 tilleggsspråkene falt samlet feilrate fra 22,36 til 20,77 prosent gjennom hele ettertreningen, mens likhetsscoren steg fra 0,638 til 0,679.
Det interessante er at realisme-stadiet ikke bare løftet kritikerens egen score. Rapporten viser også forbedring i de mer tradisjonelle målene. Det er et godt tegn på at modellen ikke bare lærte å lure sitt eget belønningssystem, selv om uavhengige lyttetester fortsatt veier tyngre enn produsentens egne tabeller.
Hvor godt fungerer Audio8-TTS-Realistic på norsk?
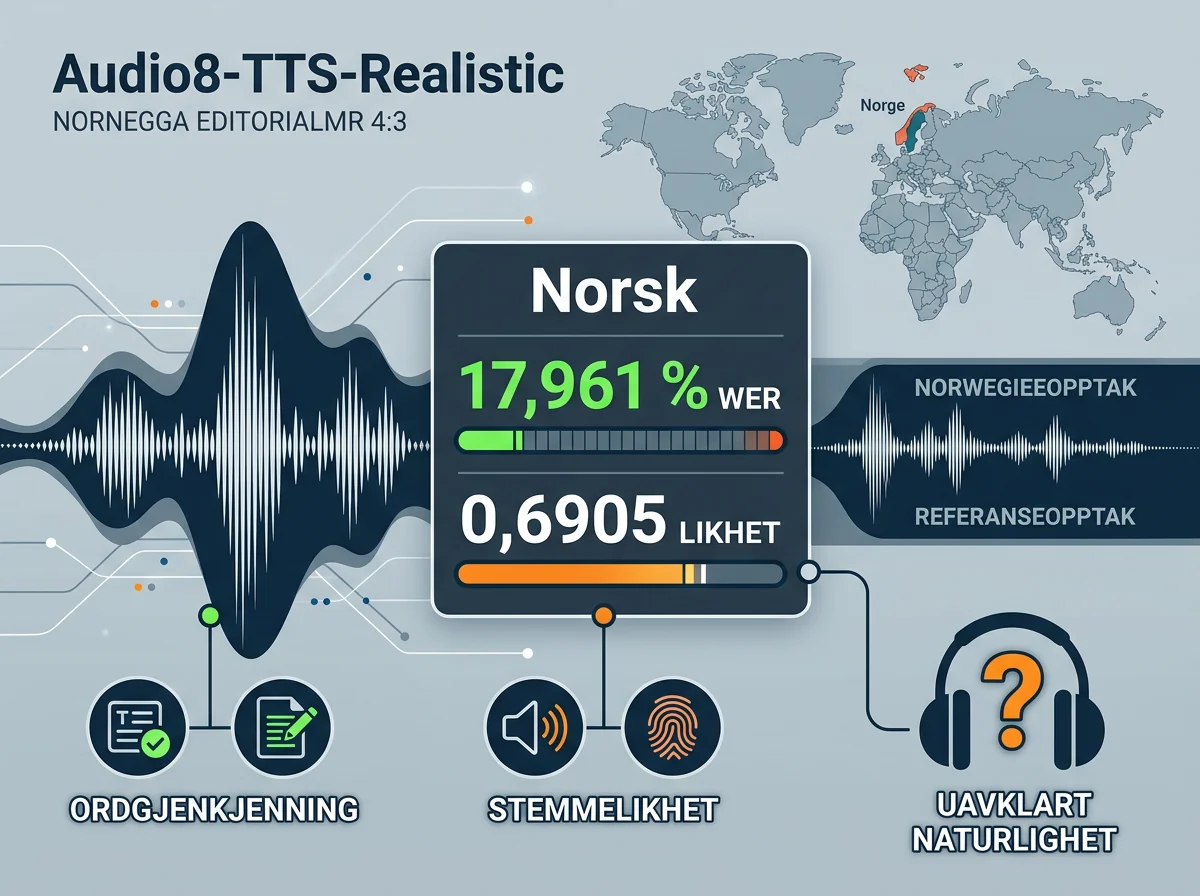
Norsk er offisielt oppført som ett av de 23 støttede språkene. I Edge0s CV3-evaluering fikk norsk en ordfeilrate på 17,961 prosent og en stemmelikhetsscore på 0,6905, målt på 500 norske elementer. Tallene dokumenterer at norsk faktisk inngikk i evalueringen – men de er ikke en full vurdering av naturlighet, dialekter eller uttale.
Ordfeilraten måles ved å transkribere den genererte talen og sammenligne den med målteksten. Det sier noe om hvor forståelige ordene er for målesystemet. Stemmelikhet sier noe om nærheten til referansestemmen. Ingen av delene forteller alene om setningsmelodi, trykk, navn, tall, forkortelser og norske dialekter høres naturlige ut for et norsk øre.
Edge0 advarer selv om at kvaliteten varierer mellom språk og evalueringssett. Engelsk og kinesisk utgjorde omtrent 30 prosent hver av dataene i den veiledede finjusteringen, mens hvert av de andre språkene sto for høyst 3 prosent. Realisme-treningen brukte kinesiske og engelske prompter omtrent likt. Det gir god grunn til å være forsiktig med å overføre påstanden om bedre realisme direkte til norsk.
Jeg har ikke lyttetestet denne modellen, og kildene dokumenterer ingen bred menneskelig vurdering av norsk. Derfor blir det feil å slå fast at Audio8 låter naturlig på norsk bare fordi språket er støttet. Det som er dokumentert, er at norsk er med i både språklisten og en konkret måling. Uttale, prosodi og dialekter er fortsatt ikke vurdert av norske lyttere.
Hvordan kjøres modellen lokalt?
Modellen kan lastes gjennom Hugging Face Transformers med trust_remote_code=True. Du trenger referanselyd, nøyaktig transkripsjon av opptaket og teksten som skal genereres. Referansen bør være ren, fordi støy og feil transkripsjon kan redusere både stabilitet og stemmelikhet.
At modellen krever trust_remote_code=True, er verdt å merke seg. Det betyr at egen Python-kode fra modellarkivet kjøres på maskinen. Les filene og bruk et isolert miljø før du laster en modell på denne måten. Åpne vekter er ikke det samme som at all tilhørende kode bør få fri tilgang til resten av systemet ditt.
Det offisielle Audio8-TTS-arkivet på GitHub har kommandolinjekjøring, batchgenerering og et SGLang Omni-oppsett for serverbruk. SGLang-adapteren tilbyr dynamisk batching, paged attention og et OpenAI-kompatibelt tale-API. Det gjør modellen mer relevant enn en ren forskningsdemo dersom du vil bygge en lokal tjeneste rundt den.
Realistic-utgaven har foreløpig ingen offisiell ONNX-eksport. Den eldre Preview-familien har andre utrullingsalternativer, men de kan ikke brukes som dokumentasjon på ytelsen eller kvaliteten til Realistic. Vil du ha akkurat den nye realisme-treningen, er det modell-ID-en Edge0/Audio8-TTS-Realistic-0.6b som gjelder.
Hva er begrensningene?
Audio8 kan lage uttalefeil, repetisjoner og utelatelser, eller stoppe for tidlig. Referanselyd, transkripsjon og måltekst deler en kontekst på opptil 2 048 pakkede tekst- og lydposisjoner, så lange passasjer bør deles opp. Et dårlig referanseopptak kan også trekke resultatet tydelig ned.
Stemmekloning krever dessuten samtykke. At modellen er åpen og kan kjøres lokalt, fjerner ikke ansvaret for å ha tillatelse til stemmen og være tydelig på at lyden er syntetisk. Det er teknisk enkelt å kopiere et stemmepreg. Det betyr ikke at enhver stemme er fritt råmateriale.
Hvis du er ute etter en helt ferdig tjeneste med garantert kapasitet, støtte og kontrollert kvalitet på alle språk, er dette ikke automatisk svaret. Modellen er først og fremst interessant for utviklere, kreative prosjekter og lokale oppsett der åpne vekter, kontroll over data og muligheten til å bygge selv veier tungt.
Jeg har tidligere skrevet om både den svært lille Flare-TTS-modellen og lokal tale med Pocket-TTS. Audio8-TTS-Realistic legger seg i et annet felt: større enn de aller minste modellene, men fortsatt kompakt nok til at lokal zero-shot stemmekloning ikke trenger å starte med en modell på flere milliarder parametere.
Min vurdering av Audio8-TTS-Realistic
Audio8-TTS-Realistic er en skikkelig spennende utgivelse. Ikke fordi en modellside kan love «realistisk» tale, men fordi Edge0 gir ut en forholdsvis liten modell med åpne vekter, en brukbar lisens, norsk språkstøtte og en gjennomtenkt metode for å trene mot mer menneskelig levering.
Det er også bra at modellkortet viser svakhetene i stedet for å gjemme alt bak ett gjennomsnitt. Norsk feilrate på 17,961 prosent er ikke et tall jeg ville brukt i en reklameplakat. Samtidig er det langt mer nyttig enn en løs påstand om at modellen «støtter norsk» uten noen måling i det hele tatt.
Dommen min er derfor positiv, men presis: Audio8-TTS-Realistic ser ut som et interessant åpent fundament for lokal, flerspråklig stemmekloning. Den dokumenterer at norsk er med, men ikke at norsk tale er ferdig løst. Ikke kjøp markedsføringen på forskudd – og ikke avskriv en liten modell som faktisk har en seriøs teknisk idé bak seg.
Ofte stilte spørsmål
Er Audio8-TTS-Realistic gratis å bruke?
Ja. Kode og modellvekter er utgitt under Apache 2.0, som tillater både bruk og videreutvikling innenfor lisensvilkårene. Du må likevel dekke egen maskinvare og drift, kontrollere NOTICE-kravene og ha samtykke til stemmer du kloner.
Kan Audio8-TTS-Realistic klone en norsk stemme?
Modellen støtter norsk og zero-shot stemmekloning fra et referanseopptak med nøyaktig transkripsjon. Norsk inngår også i Edge0s maskinelle evaluering. Det finnes derimot ikke nok dokumentasjon til å love naturlig uttale på tvers av dialekter og praktiske opptaksforhold.
Trenger Audio8-TTS-Realistic et NVIDIA-kort?
Edge0 anbefaler en CUDA-kompatibel GPU og har kontrollkjørt Transformers-utgaven på NVIDIA H20 med BF16. Modellkortet kan også velge CPU i eksempelkoden, men dokumenterer ikke praktisk CPU-hastighet for Realistic-utgaven. Det finnes foreløpig ingen offisiell Realistic-ONNX-eksport.
Hvor langt referanseopptak bør brukes til stemmekloning?
Edge0 oppgir ikke én universell ideallengde i modellkortet. Bruk et rent opptak med en transkripsjon som matcher nøyaktig, og hold inngangen håndterlig fordi referanselyd, transkripsjon og måltekst deler modellens kontekst. Støy og tekstfeil kan svekke stabilitet og stemmelikhet.