Innhold Vis
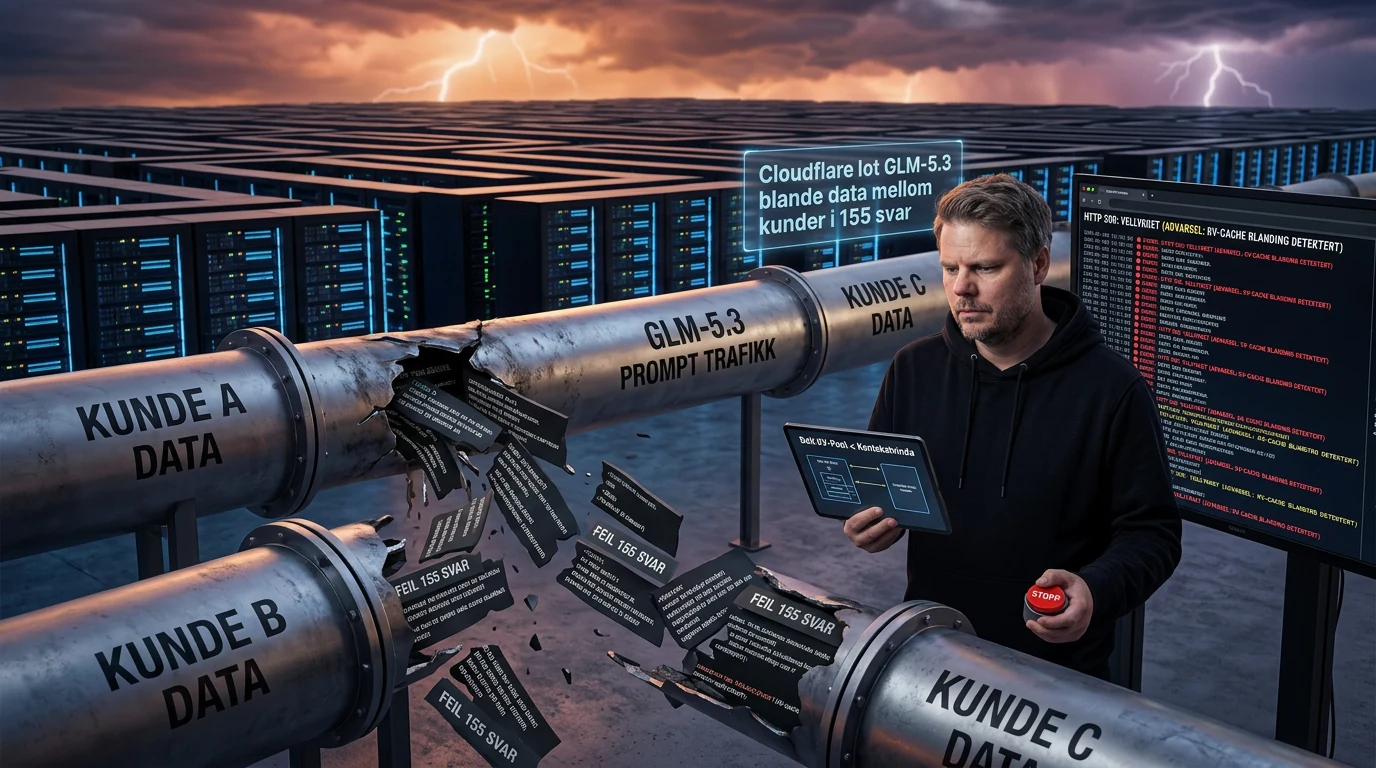
En feil i Cloudflare Workers AI gjorde at GLM-5.3 svarte med data fra andre kunders forespørsler. 155 svar ble rammet mellom 27. august og 9. september 2026, og dette er et reelt brudd på kundeskillet – ikke bare en modell som hallusinerte noe rart.
Feilen oppstod da svært lange forespørsler traff en KV-cache som var mindre enn modellens oppgitte kontekstvindu. SGLang skulle avvise forespørselen, men lot den i stedet gå videre med gamle cache-sider fra tidligere brukere. Resultatet kunne se ut som et helt vanlig, sammenhengende AI-svar med HTTP-status 200, selv om deler av innholdet kom fra noen andre.
Cloudflare rettet feilen og satte modellen tilbake i drift 9. september, men publiserte den koordinerte redegjørelsen først 26. oktober. Det mest alvorlige er ikke bare selve programvarefeilen. Cloudflare visste før lansering at KV-poolen var mindre enn kontekstvinduet, men testet statuskoder og ytelse uten å kontrollere om modellens faktiske svar fortsatt var riktige. Det holder rett og slett ikke når flere kunders data behandles i samme infrastruktur.
Hva skjedde med GLM-5.3 på Workers AI?
Cloudflare bekrefter at GLM-5.3 på Workers AI kunne returnere tekst fra andre kunders nylige forespørsler. Ifølge Cloudflares hendelsesrapport gjaldt det 155 svar, alle utløst av forespørsler på mer enn 681 280 tokens.
Hendelsen startet da modellen @cf/zai-org/glm-5.3 ble lansert 27. august. Sikkerhetsforskeren Gadi Evron fra Knostic varslet Cloudflare sent 8. september, og selskapet klarte å gjenskape lekkasjen med to uavhengige kontoer dagen etter. Modellen ble satt privat 40 minutter etter at Cloudflare erklærte en sikkerhetshendelse.
Cloudflare sier at selskapet ikke fant tegn til bevisst utnyttelse. Etter at deres egne tester og forskerens trafikk var trukket fra, lignet volumet og tidspunktet på vanlig bruk av lange kontekster. Det er betryggende, men det gjør ikke 155 svar med data fra andre kunder mindre alvorlig. Fravær av påvist angrep er ikke det samme som at kundeskillet virket.
Hvorfor kunne én kunde få en annens data?
GLM-5.3 ble tilbudt med et kontekstvindu på 1 048 576 tokens, mens KV-cache-poolen på Cloudflares prefill-GPU-er bare hadde plass til 681 280 tokens. En gyldig forespørsel kunne dermed passe innenfor modellens annonserte grense, men være for stor for minnet som faktisk skulle behandle den.
KV-cachen lagrer modellens mellomresultater mens den arbeider med en sekvens. Det gjør genereringen mye raskere fordi modellen slipper å regne gjennom hele historikken på nytt for hvert token. Vil du ha en grundigere forklaring av mekanismen, har jeg tidligere skrevet om hvordan KV-cache påvirker minnebruk i store AI-modeller.
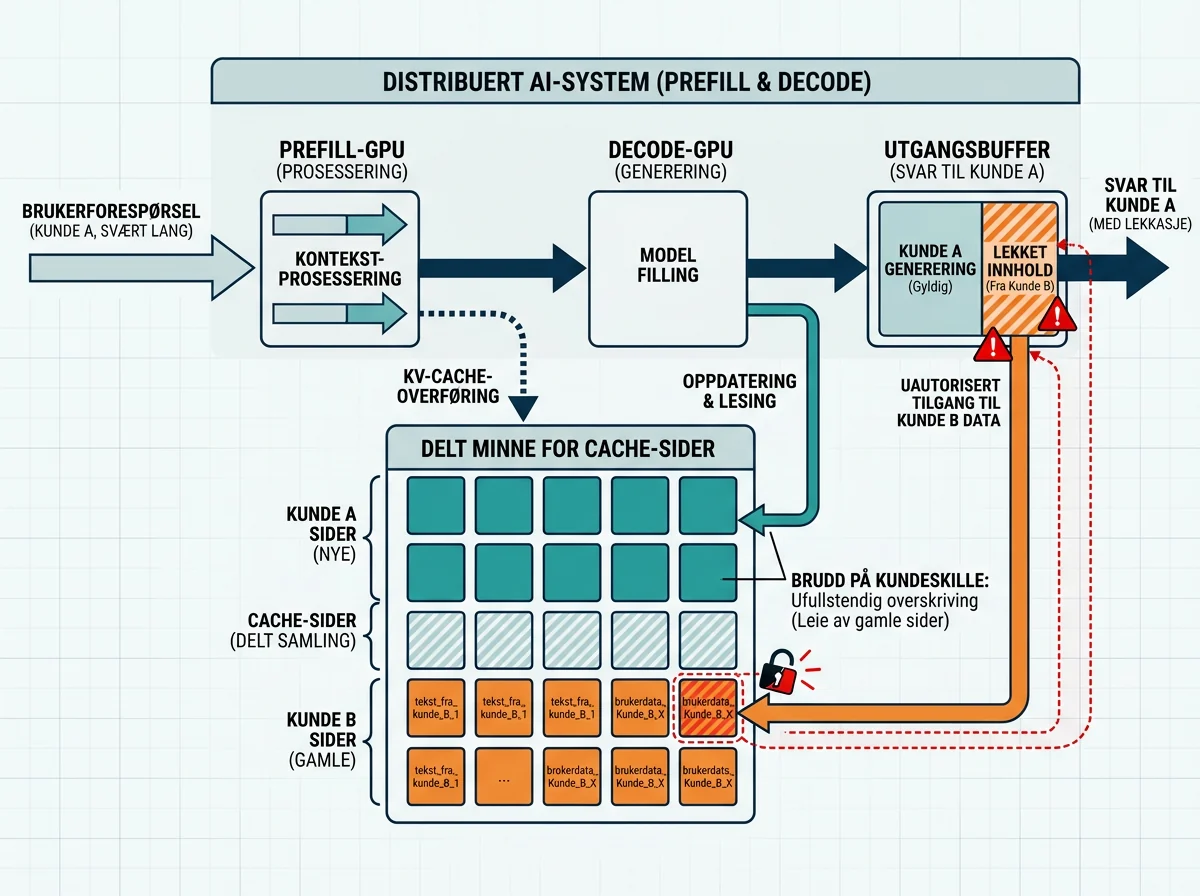
I Cloudflares oppsett var arbeidet delt mellom egne GPU-er for prefill og decode. Prefill leste forespørselen og bygget cachen, mens decode brukte den til å generere svaret. Cache-minnet var organisert som en delt samling sider som ble gjenbrukt mellom forespørsler. Sidene ble ikke nullstilt mellom hver kunde; systemet var avhengig av at nye data overskrev dem og at SGLang holdt orden på hvem som eide hvilke sider.
To feil måtte treffe samtidig
Den første feilen var Cloudflares konfigurasjon. KV-poolen var for liten, og selskapet visste om forskjellen før modellen ble lansert. Cloudflare antok at SGLang ville avvise for lange forespørsler på en trygg måte. Testene ga vellykkede statuskoder og en strøm med data, så oppsettet ble godkjent.
Det var en farlig antakelse. Cloudflare skriver selv at prelanseringstesten bare kontrollerte HTTP-status og motorytelse ved lange kontekster. Ingen kontrollerte innholdet og sammenhengen i svaret. Et svar med status 200 ble dermed behandlet som bevis på at systemet virket, selv om nettopp den statusen senere viste seg å skjule feilen.
Den andre feilen lå i SGLang. Da en forespørsel ikke fikk plass i KV-poolen, ble den markert for avvisning og byttet ut med en plassholder på ett token. I et enkeltstående oppsett ville dette til slutt gitt klienten en feil. I den distribuerte prefill/decode-modusen ble den avviste forespørselen likevel oppfattet som aktiv og sendt videre.
Decode-noden hadde reservert cache-sider for hele den opprinnelige forespørselen. Prefill skrev bare den ene siden som plassholderen trengte, men signaliserte at overføringen var ferdig. Decode antok at alle sidene var overskrevet. Resten inneholdt fortsatt prompts og delvise genereringer fra tidligere brukere, og modellen fikk lese dem mens den laget svaret.
Hvorfor så ikke overvåkingen feilen?
Dette er den ubehagelige delen: Svaret kunne se normalt ut. Klienten fikk HTTP 200, tokenantallet samsvarte med den lange forespørselen, og teksten kunne være sammenhengende. Den kom til og med raskere enn en ekte prefill av hele forespørselen burde ha gjort. Uten kontroll av innhold, behandlingstid og cache-eierskap var signalene en vanlig driftsmåling følger, grønne.
Hver forespørsel over grensen traff ifølge Cloudflare denne feilbanen. Likevel var omfanget begrenset til 155 svar fordi terskelen på 681 280 tokens er svært høy. Bare GLM-5.3 var berørt på Workers AI; de andre distribuerte modellene hadde KV-pooler som var større enn kontekstvinduene og nådde derfor ikke samme avvisningsbane.
Cloudflare sier også at den underliggende feilen var rapportert til SGLang-prosjektet 6. juli, men at selskapet først fant den rapporten mens hendelsen ble undersøkt. En relatert rettelse var faktisk slått sammen i SGLang 6. september, to dager før varslingen, men var ennå ikke utgitt. Det viser hvor fort avstanden mellom kildekode, versjoner og produksjonsoppsett kan bli et sikkerhetsproblem.
Hva gjorde Cloudflare og SGLang for å rette feilen?
Cloudflare økte først KV-poolen til rundt 2,04 millioner tokens, nesten dobbelt så mye som kontekstvinduet på 1 048 576 tokens. Dermed får enhver gyldig forespørsel også plass i den faktiske poolen. Men større pool alene ville vært en skjør løsning, fordi kvantisering, parallellisering, modellvekter og andre GPU-innstillinger kan endre kapasiteten ved neste utrulling.
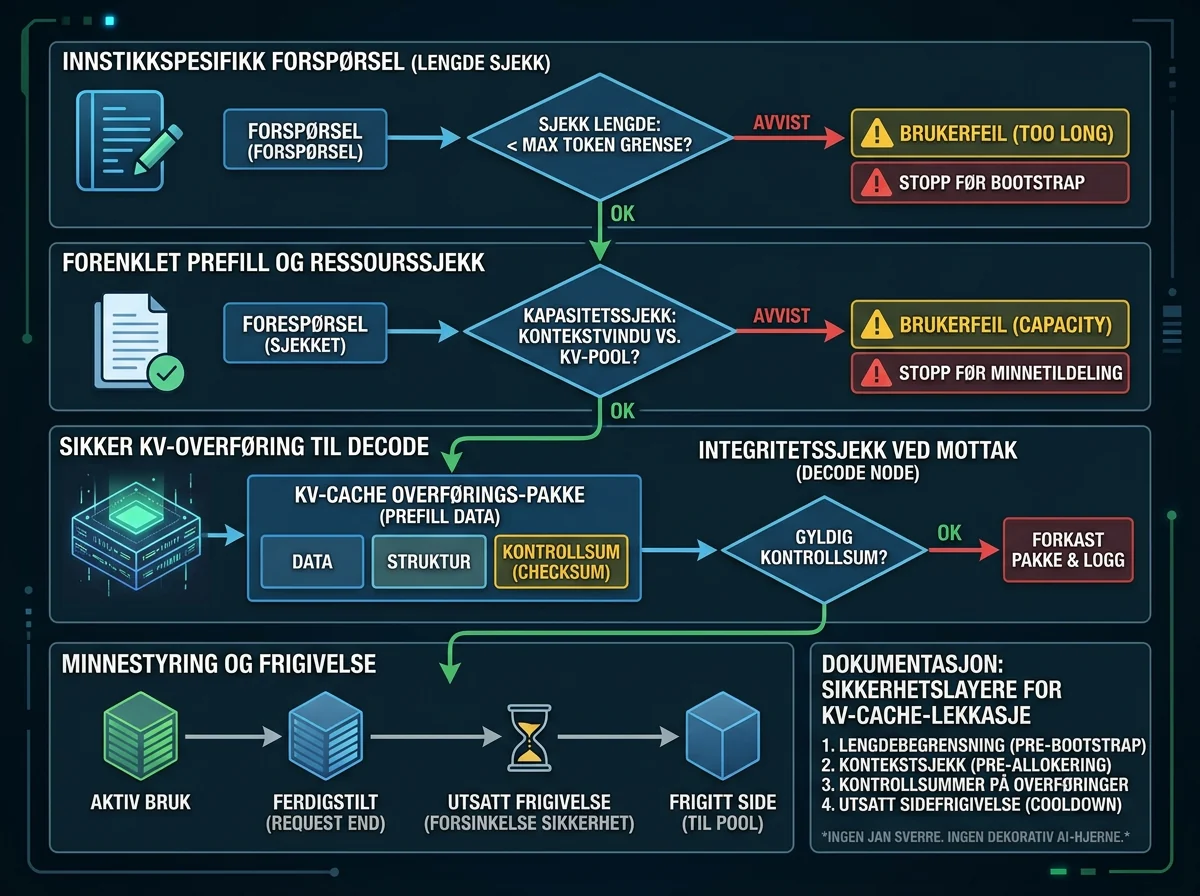
Derfor ble også avvisningsbanen rettet. Forespørsler som er markert for avvisning, skal nå stoppes før bootstrap, minnetildeling og KV-overføring. SGLang-rettelsen i pull request 38935 ble slått sammen 16. september og hindrer at en avvist forespørsel slipper inn i overføringen som om den fortsatt var aktiv.
Cloudflare testet rettelsene både med forskerens reproduksjon og egne markører i cachen. Selskapet har også lagt inn obligatorisk kontroll av faktisk KV-pool mot kontekstvinduet ved alle endringer i distribuerte utrullinger. SGLang har på sin side lagt til flere lag med beskyttelse rundt avbrudd, utsatt frigivelse av cache-sider og kontrollsummer ved overføring mellom prefill og decode.
SGLang-teamets tekniske sikkerhetsoppdatering viser at dette ikke bare var én enkel if-setning som manglet. Når GPU-minne flyttes mellom noder med RDMA, kan forsinkede skriveroperasjoner treffe sider etter at systemet tror de er frigitt. Teamet testet blant annet den utsatte frigivelsen ved å avbryte 132 overføringer på to H200-GPU-er uten krasj eller dobbel frigivelse.
Hva bør brukere av Workers AI gjøre?
Har du brukt @cf/zai-org/glm-5.3 på Workers AI mellom 27. august og 9. september 2026, bør du finne fram logger og forespørsler fra perioden. Se spesielt etter prompts over 681 280 tokens, uventet raske svar og innhold som ikke hører til din egen sesjon. Ta kontakt med Cloudflare hvis du trenger å avklare om kontoen eller trafikken din inngår i hendelsen.
Hvis forespørslene inneholdt API-nøkler, passord, kundedata eller andre hemmeligheter, ville jeg ikke sittet og ventet på et perfekt bevis. Bytt berørte nøkler og legitimasjon, dokumenter tidsrommet og vurder hvilke opplysninger som kan ha blitt eksponert. Det er en forholdsregel, ikke en påstand om at hver prompt i perioden lekket.
Hendelsen er også en påminnelse om at svært lange prompts kan samle enorme mengder sensitiv kontekst på ett sted. RAG-resultater, kildekode, logger og kundesaker ender fort i samme forespørsel. Minimer dataene før de sendes, skill hemmeligheter fra modellkonteksten og behold nok sporbarhet til å finne ut hva som faktisk ble behandlet hvis leverandøren melder om en hendelse.
Hva bør SGLang-operatører gjøre?
Driver du SGLang i distribuert prefill/decode-modus, er rådet tydelig: Oppgrader til v0.5.22 eller nyere, eller tilbakeporter de nødvendige rettelsene. Mål KV-poolen på hver prefill- og decode-node etter endringer i modell, kvantisering, parallellisering eller minneandel. Ikke stol på modellens kontekstvindu eller en proxygrense som bevis på at forespørselen får plass i den faktiske cachen.
Aktiver utsatt frigivelse av KV-sider på begge roller, begrens størrelsen på Mooncake-overføringer og bruk kontrollsummer og KV-canary der modellarkitekturen støttes. Cloudflare opplyser at kontrollene ennå ikke dekker blant annet GLM-5.3, GLM-5.3 Flash og DeepSeek V4 fullt ut. Det er viktig: En sikkerhetsfunksjon i konfigurasjonen hjelper lite hvis loggene viser at den ikke kontrollerer modellen du faktisk kjører.
Og test resultatet, ikke bare rørene rundt det. En statuskode, en strøm som ikke brytes og god throughput beviser at tjenesten svarte. Det beviser ikke at riktig kunde fikk riktig innhold fra riktig minne. Denne hendelsen er et skoleeksempel på hvorfor sikkerhetstester må kontrollere dataopphav og sammenheng, ikke bare om endepunktet holder seg oppe.
Min vurdering av Cloudflare-hendelsen
Cloudflare fortjener ros for en uvanlig detaljert teknisk redegjørelse, rask retting etter at hendelsen ble bekreftet og samarbeid med SGLang om oppstrømsrettelser. Slike rapporter gjør hele økosystemet bedre. Men åpenhet etterpå visker ikke ut feilen før lansering.
Selskapet kjente det konkrete misforholdet mellom 1 048 576 tokens i kontekstvinduet og 681 280 tokens i KV-poolen. Likevel ble en vellykket HTTP-respons tolket som at alt var i orden. Når testen ikke engang leser svaret fra modellen, er det ikke en god nok test av en flerkundet AI-tjeneste. Punktum.
Det er lett å avfeie 155 svar som et lite tall i en stor skytjeneste. Feil målestokk. Det avgjørende er at infrastrukturen krysset grensen mellom kunder uten å varsle om feil, og leverte resultatet som et troverdig svar. Brukerne må kunne stole på at deres modellkontekst ikke blir råmateriale for neste kunde. Her brast den tilliten, og både leverandører og selvhostere bør behandle lærdommen som en sikkerhetsport – ikke som en fotnote i en versjonslogg.
Ofte stilte spørsmål
Hvilke Cloudflare-kunder ble berørt av GLM-5.3-feilen?
Feilen gjaldt kunder som brukte @cf/zai-org/glm-5.3 på Workers AI fra 27. august til 9. september 2026. Cloudflare identifiserte 155 berørte svar, alle etter prompts på mer enn 681 280 tokens. Ingen andre Workers AI-modeller skal ha vært berørt.
Betyr 155 berørte svar at bare 155 prompts kunne lekke?
Cloudflare oppgir 155 svar som inneholdt data fra andre kunders tidligere forespørsler. Tallet beskriver bekreftede berørte svar, ikke nødvendigvis et fullstendig mål på hvor mange kildeprompts som bidro med data. Cloudflare fant samtidig ingen tegn til bevisst utnyttelse.
Er GLM-5.3 på Workers AI trygg å bruke nå?
Den konkrete feilen er rettet, og Cloudflare satte modellen tilbake i drift 9. september etter å ha økt KV-poolen og patchet avvisningsbanen. Ingen skytjeneste kan garanteres feilfri, så sensitiv informasjon bør fortsatt begrenses og behandles med vanlige sikkerhetskontroller.
Hvilken SGLang-versjon bør operatører bruke?
Cloudflare anbefaler SGLang v0.5.22 eller nyere for distribuerte prefill/decode-oppsett. Operatører må i tillegg kontrollere faktisk KV-kapasitet mot kontekstvinduet, bruke trygg frigivelse av cache-sider og bekrefte i loggene at valgte integritetskontroller støtter modellen.