Innhold Vis
Hvis du bruker AI til lange kodejobber eller krevende kunnskapsarbeid, er Grok 4.7 en oppgradering det er verdt å merke seg. xAI har byttet til en større basemodell, trent den lenger på oppgaver som kan ta mange timer og gjort den bedre til å kontrollere sitt eget arbeid. Samtidig beholder standardmodellen prisen fra Grok 4.6.
Det er den kombinasjonen jeg liker her. En modell som bare vinner noen poeng i en pen tabell er lett å glemme. En modell som kan holde tråden lenger, oppdage egne feil og fullføre mer av en reell jobb uten at tokenprisen øker, kan faktisk gjøre en forskjell. Jeg liker Grok-kodemodellene godt fra før, så denne er jeg oppriktig nysgjerrig på. Det er også en naturlig fortsettelse av Grok 4.5, som beholdt den samme grunnprisen.
Men entusiasme er ikke det samme som blind tillit. De mest detaljerte resultatene kommer fra xAI selv, og Grok 4.7 må prøves mot dine egne kodebaser, dokumenter og arbeidsflyter før du vet om oppgraderingen er verdt et modellbytte. Det viktigste akkurat nå er hva som faktisk er nytt, hvor modellen finnes og hva den koster.
Hva er nytt i Grok 4.7?
Grok 4.7 er xAIs nye frontiermodell for koding, agentoppgaver og kunnskapsarbeid. Modellen ble lansert 21. september 2026, har et kontekstvindu på 500 000 tokens og tar imot både tekst og bilder. Den returnerer tekst og støtter funksjonskall, strukturerte svar og fire nivåer av resonneringsinnsats.
Den viktigste endringen ligger under panseret. I xAIs lansering av Grok 4.7 beskriver selskapet en ny og større basemodell enn i Grok 4.6. Ettertreningen har vart lenger og lagt mer vekt på vanskelige oppgaver som krever flere timers arbeid. xAI sier også at modellen er bedre til å verifisere resultatene sine og håndtere lange kontekster.
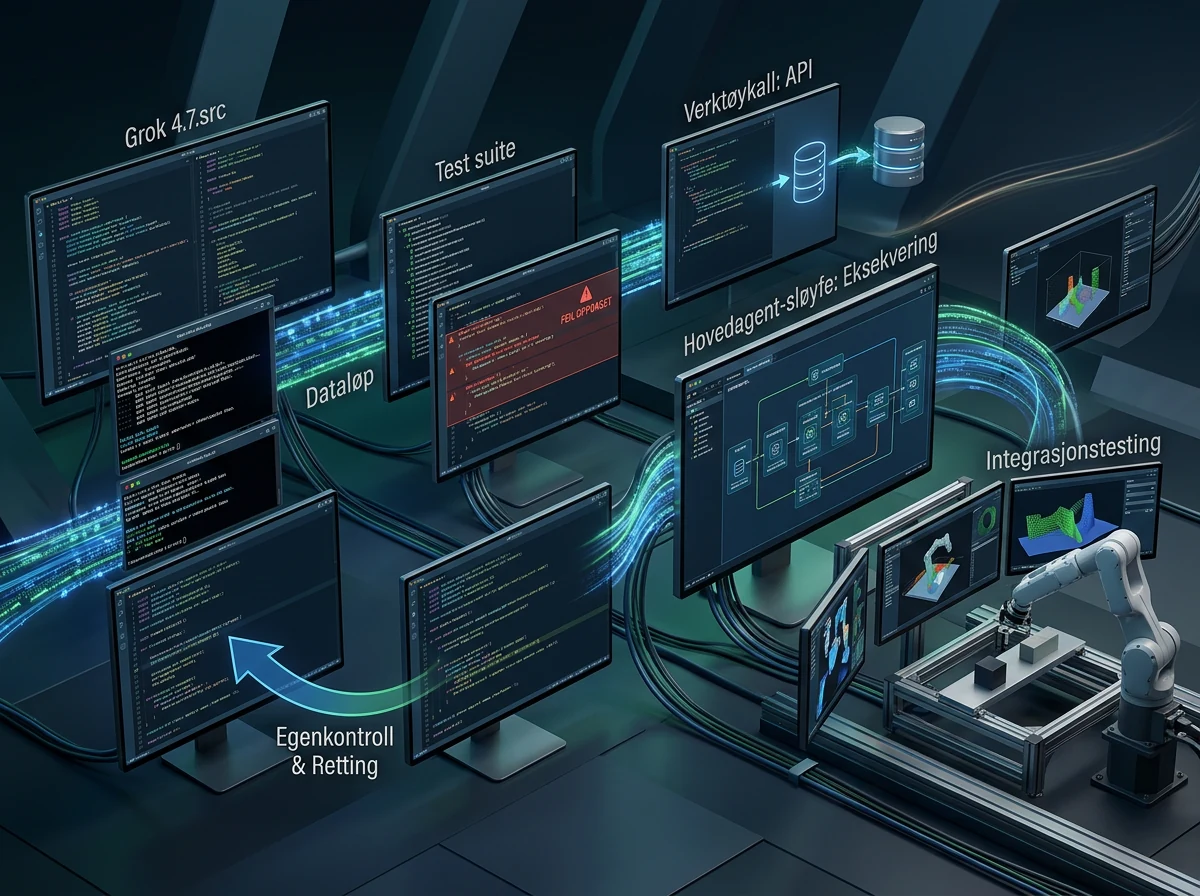
Det siste kan være viktigere enn det høres ut. Lange agentløp ryker ofte ikke fordi modellen mangler kunnskap, men fordi den mister målet, overser en feil eller bygger videre på en dårlig antakelse. Bedre egenkontroll kan derfor gi færre runder med opprydding. «Kan» er det avgjørende ordet her, for det er først i ekte prosjekter vi ser hvor mye bedre den faktisk holder kursen.
Hvor mye bedre er den enn Grok 4.6?
xAIs egne tester viser et tydelig løft fra Grok 4.6 på flere lange arbeidsoppgaver. På CursorBench 4.0 går resultatet fra 40,4 til 46,3 prosent, mens Terminal-Bench 4.0 øker fra 20,3 til 37,6 prosent. På selskapets test for flertrinns kontorarbeid øker poengsummen fra 1 546 til 1 657.
Det er særlig hoppet i terminalarbeid jeg merker meg. En agent som skal endre kode, kjøre kommandoer, lese feil og forsøke på nytt trenger utholdenhet, ikke bare et godt førstesvar. Grok 4.7 er også trent til å forstå Grok Bot-miljøet direkte, noe som peker mot en modell laget for faktisk arbeid i verktøy og ikke bare for samtaler i et tekstfelt.
Samtidig må tallene behandles nøkternt. Testene er valgt og publisert av xAI, og resultatene varierer mye etter oppgave. Grok 4.7 slår sammenligningsmodellene i noen av xAIs tabeller og taper i andre. Det mest ærlige svaret er derfor at 4.7 ser klart bedre ut enn 4.6 i xAIs egne målinger, men at ingen tabell kan fortelle hvordan modellen håndterer akkurat ditt kodearkiv eller dine dokumenter.
Hva betyr 500 000 tokens i praksis?
Et kontekstvindu på 500 000 tokens gir plass til store mengder kode, dokumenter, bilder og tidligere meldinger i samme forespørsel. Det kan være nyttig når modellen må se flere deler av et kodearkiv samtidig, sammenligne lange avtaler eller beholde historikken gjennom et omfattende agentløp.
Stor kontekst er likevel ikke det samme som perfekt hukommelse. Mer materiale kan også bety mer støy, høyere kostnad og flere muligheter til å feste seg ved feil detalj. Jeg ville fortsatt gitt modellen et tydelig oppdrag, relevante filer og konkrete kontrollpunkter i stedet for å helle inn alt jeg finner og håpe på magi.
Modellsiden for Grok 4.7 oppgir funksjonskall, strukturerte svar og reasoning-nivåene low, medium, high og xhigh. Standardnivået er high. Det gjør modellen fleksibel, men høyere innsats kan bruke flere output-tokens. Mål derfor både kvalitet, tidsbruk og faktisk regning når du sammenligner innstillingene.
Hva koster Grok 4.7?
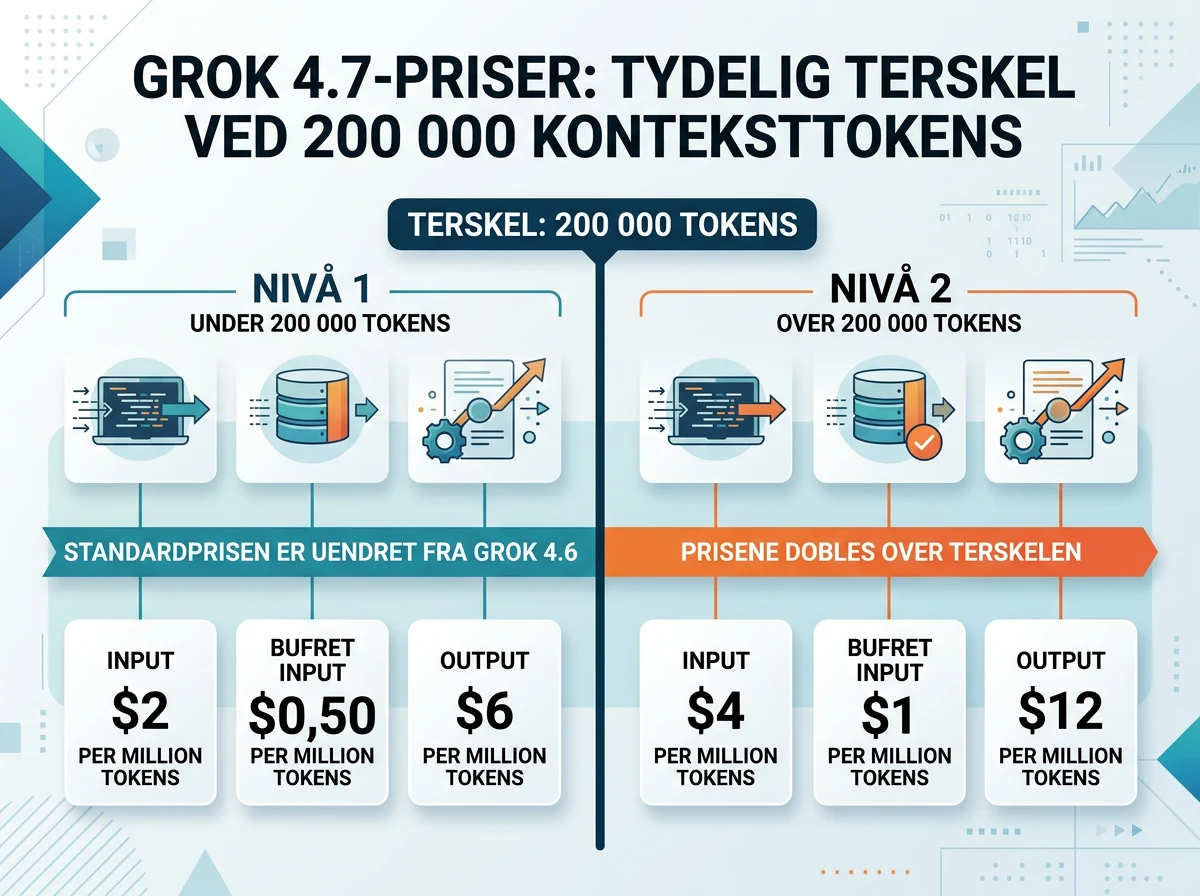
Grok 4.7 koster 2 dollar per million input-tokens, 0,50 dollar per million bufrede input-tokens og 6 dollar per million output-tokens når forespørselen holder seg under 200 000 konteksttokens. Med Norges Banks siste publiserte kurs 30. september tilsvarer det omtrent 19, 5 og 58 kroner.
Når forespørselen når 200 000 prompt-tokens, dobles standardprisene til 4 dollar for input, 1 dollar for bufret input og 12 dollar for output per million tokens. Det er omtrent 38, 10 og 115 kroner. Grensen er lett å overse hvis du sender store kodebaser eller lange dokumentpakker, så logg både antall konteksttokens og kostnad per fullført oppgave.
Prisene er uendret fra Grok 4.6. Det betyr at en ren modelltest er enkel for API-brukere: Kjør de samme oppgavene mot begge modellene og sammenlign kvalitet, tokenbruk, tidsbruk og hvor mye menneskelig opprydding som gjenstår. Den billigste modellen per million tokens er ikke nødvendigvis billigst hvis den må prøve fem ganger.
Hvor kan du bruke Grok 4.7?
Grok 4.7 er tilgjengelig gjennom xAI API med modellnavnet grok-4.7. Den finnes også i Cursor, Grok Build, tredjeparts kodeverktøy, modellrutere og enkelte skyplattformer. Hos OpenRouter heter modellen x-ai/grok-4.7 og har samme grunnpris som i xAI API. Dette er altså en faktisk tilgjengelig modell, ikke en forhåndsvisning med en venteliste og en lovnad om at tilgang kommer senere.
Det er verdt å skille standardmodellen fra Grok 4.7 Fast. Ifølge xAIs offisielle versjonsnotater er Fast den samme modellen med omtrent dobbelt så høy output-hastighet. Den koster dobbelt standardpris ved vanlig kontekst og 1,5 ganger standardpris ved lang kontekst.
Fast-varianten er foreløpig bare tilgjengelig i Cursor og Grok Build, ikke i det offentlige xAI API-et. Den faktureres gjennom abonnementet i disse tjenestene. Hvis du bygger en integrasjon direkte mot API-et, er det derfor standardutgaven du kan planlegge rundt nå.
Bør du bytte fra Grok 4.6?
Ja, Grok 4.7 bør inn i en kontrollert sammenligning hvis du allerede bruker 4.6 til koding, agenter eller lange dokumentoppgaver. Prisen er den samme, og xAIs egne resultater peker på bedre utholdenhet og egenkontroll. Det er et godt utgangspunkt, men ikke en grunn til å bytte produksjonsmodell uten testing.
Lag heller et lite evalueringssett med ekte oppgaver: en feil som krever lesing på tvers av flere filer, en endring med tester, et dokument som må kontrolleres mot kilder og en agentjobb med flere verktøysteg. Mål om svaret faktisk virker, hvor mange forsøk som trengs og hvor mye du må rette manuelt. Benchmarkpoeng betaler ingen faktura og reparerer ingen produksjonsfeil.
Har du en løsning som sender svært store kontekster, bør du i tillegg teste begge sider av grensen på 200 000 tokens. Ofte kan bedre uthenting, komprimering eller oppdeling gi et billigere og mer presist resultat enn å sende en halv million tokens hver gang.
Sikkerheten er strammere – men modellen skal fortsatt kontrolleres
xAI sier at Grok 4.7 har en helt ny sikkerhetsstabel og bedre motstand mot jailbreaks. I selskapets HackerBench-test slapp modellen gjennom 3,3 prosent av risikable forespørsler, mens den samtidig sjelden blokkerte legitimt sikkerhetsarbeid. På LatchBios test for biologisk sikkerhet oppgir xAI en poengsum på 62,4 prosent.
Det er positivt at leverandøren prøver å kombinere nyttige cyberferdigheter med færre farlige svar. Men disse tallene gjør ikke modellen feilfri, og «sikker» betyr ikke at kodeforslag, analyser eller handlinger kan kjøres uten kontroll. En agent med terminal, nettverk og produksjonstilgang må fortsatt ha minst mulige rettigheter, tydelige godkjenningspunkter og logger du faktisk følger med på.
For vanlig utviklingsarbeid er rådet enkelt: La modellen gjøre mye, men la automatiske tester, kodegjennomgang og begrensede tilganger være rekkverket. En modell som jobber lenger på egen hånd kan spare mye tid. Den kan også rekke å gjøre mer skade hvis oppgaven eller tilgangen er feil.
Grok 4.7 ser ut som en oppgradering med substans
Grok 4.7 treffer en retning jeg har mye mer tro på enn enda et kappløp om korte demosvar. Modellen er laget for å holde ut gjennom lange oppgaver, kontrollere sitt eget arbeid og fungere bedre i agentmiljøer. At standardprisen ikke øker, gjør det lett å undersøke om løftet er reelt. Samtidig er 4.7 en modell du kan bruke nå, mens Grok 5 fortsatt peker mot det neste store spranget.
Det betyr ikke at xAIs egne benchmarkgrafer skal få bestemme modellvalget. Bruk dem som en grunn til å teste, ikke som en fasit. Hvis 4.7 løser flere av dine faktiske oppgaver på første forsøk og krever mindre opprydding, er den bedre. Hvis ikke, hjelper det lite at den vant en tabell.
Min foreløpige dom er derfor positiv: Dette ser ut som en meningsfull Grok-oppgradering, særlig for koding og flertrinns arbeid. Jeg ville prøvd den nå, men med målinger, kostnadsgrenser og samme kontroll som enhver annen modell får. Begeistring er fint. Produksjonslogger er bedre.
Ofte stilte spørsmål
Er Grok 4.7 tilgjengelig i xAI API?
Ja. Grok 4.7 er tilgjengelig med modellnavnet grok-4.7 i xAI API. Modellen finnes også i Cursor, Grok Build, OpenRouter, tredjeparts kodeverktøy, modellrutere og enkelte skyplattformer. Fast-varianten er derimot foreløpig begrenset til Cursor og Grok Build.
Har Grok 4.7 samme pris som Grok 4.6?
Ja. Under 200 000 konteksttokens koster standardmodellen 2 dollar per million input-tokens og 6 dollar per million output-tokens, omtrent 19 og 58 kroner med kursen brukt her. Fra og med 200 000 prompt-tokens dobles tokenprisene.
Kan Grok 4.7 lese bilder og kode?
Ja. Grok 4.7 tar imot både tekst og bilder og er spesielt rettet mot koding, agentoppgaver og kunnskapsarbeid. Output er tekst. Den støtter også funksjonskall og strukturerte svar, slik at den kan inngå i verktøybaserte arbeidsflyter.
Er Grok 4.7 Fast tilgjengelig via offentlig API?
Nei. Grok 4.7 Fast er foreløpig bare tilgjengelig i Cursor og Grok Build. xAI oppgir omtrent dobbelt output-hastighet. Varianten koster dobbelt standardpris ved vanlig kontekst og 1,5 ganger standardpris ved lang kontekst.