Innhold Vis
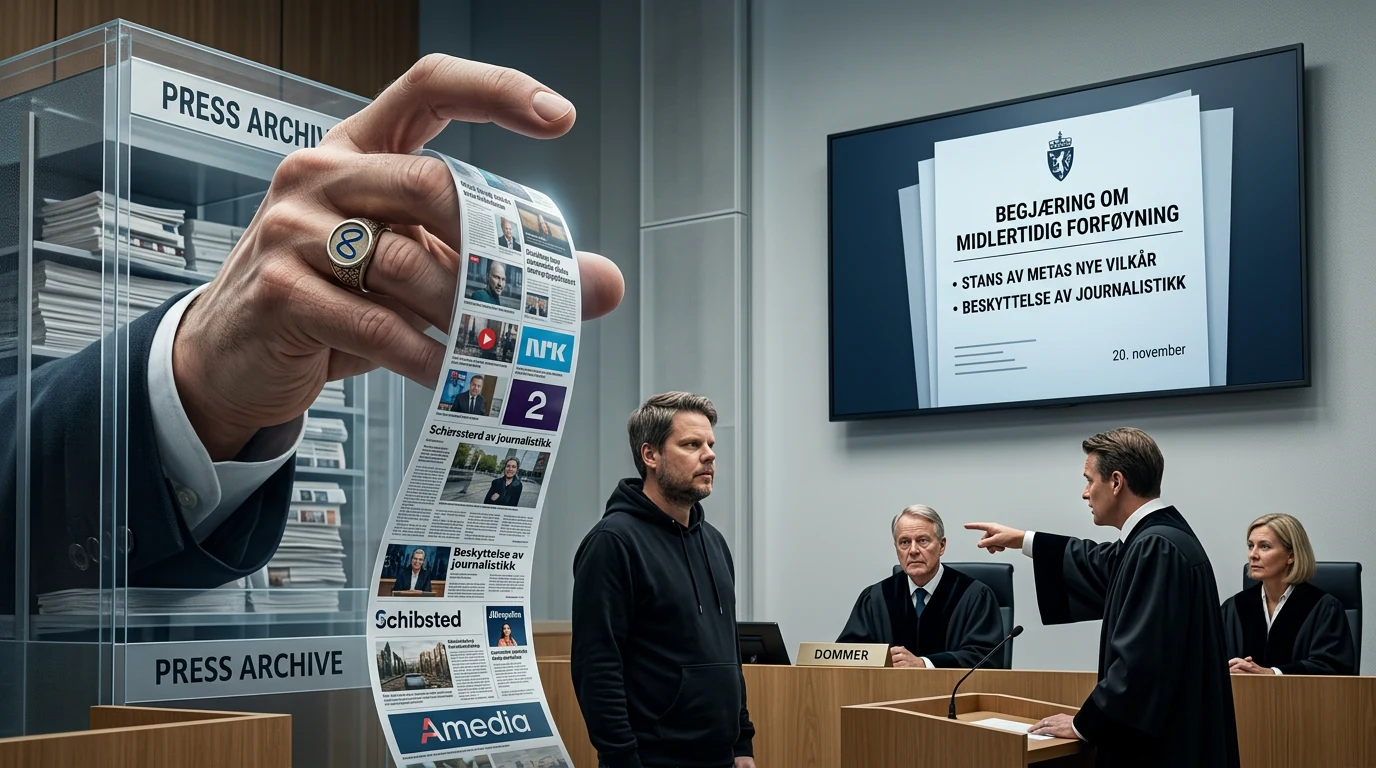
Norske mediebedrifter ber Oslo tingrett stanse Metas nye vilkår før de trer i kraft 20. november. NRK, TV 2, Schibsted og sju andre aktører mener vilkårene kan gi Meta altfor vide rettigheter til å hente artikler, bilder og video fra nettstedene deres – også materiale bak betalingsmur.
Det er en reell og viktig konflikt. Mediene er avhengige av Facebook og Instagram for å nå publikum, mens Meta vil at videre bruk av bedriftsproduktene skal telle som aksept av de nye vilkårene. Når den praktiske måten å si nei på er å forlate noen av verdens viktigste distribusjonskanaler, ligner det lite på en frivillig avtale mellom jevnbyrdige parter.
Men saken må beskrives presist. Det er ikke slått fast at Meta får bruke alle norske betalingsartikler til AI-trening. Meta har fjernet en eksplisitt henvisning til «train» fra den reviderte teksten og avviser at endringen handler om å skrape nyhetsnettsteder. Samtidig står den brede tillatelsen til automatisert innhenting igjen. Det er nettopp dette retten nå blir bedt om å gripe inn i.
Hva ber de norske mediene retten om?
Medieaktørene ber om en midlertidig forføyning som stanser de nye vilkårene mens lovligheten blir vurdert. Ifølge Digis omtale av saken står NRK, TV 2, Schibsted, Amedia, Polaris, Aller, DN, Mentor Medier, NTB og Hordaland Folkeblad bak. Det er 10 aktører med svært ulik størrelse, fra allmennkringkasteren til en lokalavis.
De vil hindre at vilkårene trer i kraft 20. november før en domstol har vurdert om de er i tråd med norsk rett. Mediebedriftenes Landsforening mener Meta misbruker en dominerende stilling ved å koble tilgangen til plattformene med retten til å hente innhold fra nettstedene som er knyttet til bedriftskontoene.
Det er viktig å skille denne saken fra en annen Meta-konflikt som pågår samtidig. Tidligere i oktober varslet MBL og NRK et mulig søksmål om svindelannonser som misbruker norske mediers navn, logoer og journalistikk. Dagens rettslige skritt gjelder de nye kommersielle vilkårene og tilgangen til medienes eget innhold. Meta har med andre ord klart å få to ulike medieoppgjør i fanget samme måned. Det er nesten imponerende, bare ikke på den gode måten.
Hva står i Metas nye vilkår?
De nye vilkårene gir Meta og selskaper som opptrer på vegne av Meta adgang til å bruke automatisert programvare mot nettsteder som er knyttet til en virksomhets produkter eller tjenester. Det omfatter blant annet crawlers, bots og scrapers som kan åpne, indeksere, mellomlagre, analysere og samle inn innhold. Teksten åpner også for at Meta kan opprette testkontoer og komme tilbake for å hente oppdateringer.
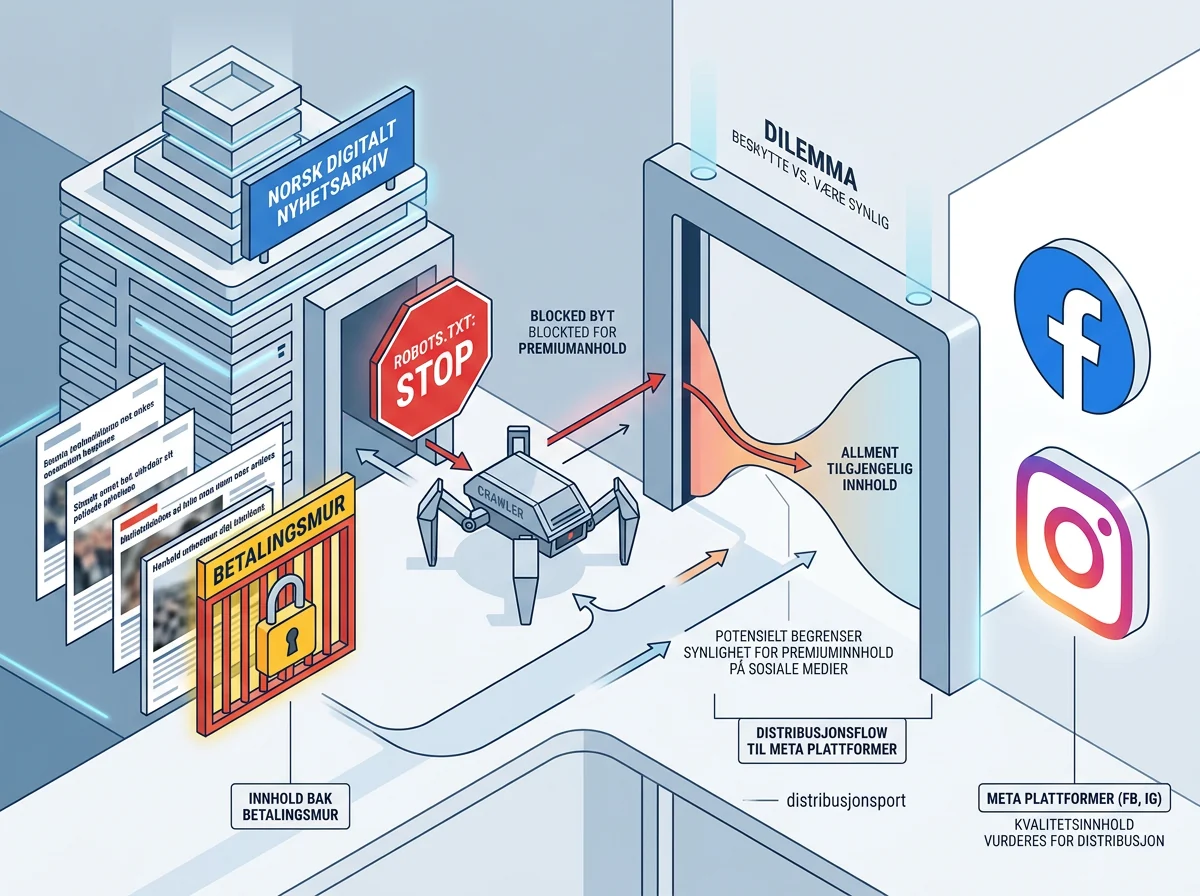
Omfanget er grunnen til at mediehusene reagerer. En bedriftskonto kan være koblet til et nettsted med tusenvis av artikler, et stort bildearkiv og innhold som bare abonnenter skal ha tilgang til. En tillatelse som følger av videre bruk av Facebook eller Instagram, kan da få konsekvenser langt utenfor selve innholdet som mediet velger å publisere på Meta-plattformene.
Metas kommersielle vilkår gjelder dessuten bredere enn bare kjøp av annonser. De omfatter forretningsmessig bruk av selskapets produkter, blant annet administrasjon av sider. En virksomhet trenger altså ikke være en stor annonsør for å bli berørt. Fortsetter den å bruke de aktuelle produktene etter ikrafttredelsen, regnes vilkårene som akseptert.
Meta utsatte datoen fra 30. oktober til 20. november. Selskapet oppga at det trengte mer tid til å forklare samarbeidspartnere og andre berørte hva som endres og hva som ikke endres. Tre ekstra uker er fint, men en utsettelse svarer ikke på hvem som faktisk får bestemme over innholdet.
Kan Meta bruke innholdet til AI-trening?
Det korte og ærlige svaret er at dette er omstridt. En tidligere versjon av vilkårene sa uttrykkelig at innhentet innhold kunne brukes til å utvikle, forbedre, forske på og «train» Metas produkter. Ordet som eksplisitt viste til trening, er borte fra den reviderte engelske teksten som ble kontrollert 23. oktober.
Det betyr likevel ikke at hele striden er ryddet av veien. Meta beholder tillatelsen til å samle inn innhold og bruke det til å utvikle og forbedre annonse- og bedriftsprodukter. Europeiske utgiverorganisasjoner mener den reviderte ordlyden fortsatt ikke uttrykkelig utelukker AI-bruk av journalistikken.
Meta er uenig. I en uttalelse gjengitt av Reuters 22. oktober sa selskapet at crawler-vilkårene bare gjelder annonse- og bedriftsprodukter, at de ikke endrer hvordan Meta bruker webcrawlere, og at innholdseiere fortsatt kan signalisere valgene sine gjennom robots.txt.
Det er altså ikke slått fast at Meta har fått en ubetinget rett til å trene AI på alt bak norske betalingsmurer. Det er medienes tolkning og frykt, ikke en rettskraftig konklusjon. Men Meta bør heller ikke få slippe unna med at ett ord er fjernet. Hvis selskapet mener AI-trening er utelukket, kan det skrive nettopp det klart og bindende. Her burde det ikke være behov for juridisk gjettelek.
Hvorfor holder ikke robots.txt som svar?
robots.txt er en teknisk beskjed til crawlere, ikke en forhandlet avtale om opphavsrett, betaling eller konkurransevilkår. Meta sier at slike reservasjoner blir respektert, men selskapet bruker flere crawlere med ulike oppgaver. Blokkering av AI-crawleren kan redusere tilstedeværelsen i Metas produkter, mens blokkering av andre crawlere kan påvirke lenkeforhåndsvisninger og annonser. En teknisk blokkering er derfor ikke ett enkelt svar uten følger.
Dette er kjernen i maktforholdet. Mediene har investert i journalistene, fotografene, arkivene og betalingsløsningene. Meta kontrollerer to av kanalene som brukes for å spre resultatet. Dersom plattformen kan gjøre bred adgang til det underliggende nettstedet til prisen for fortsatt distribusjon, har «samtykke» fått en ganske kreativ betydning.
Det samme mønsteret er kjent for privatpersoner, selv om reglene og rettsgrunnlaget ikke er identiske. Jeg har tidligere skrevet om hvordan du reserverer Instagram-bilder mot gjenbruk i Meta AI. I denne saken er problemet større: Mediehusene mener de ikke får et reelt, avgrenset valg som lar dem beholde distribusjonen uten å godta den nye crawler-tilgangen.
Hva står på spill for leserne?
Dette er mer enn en krangel mellom store selskaper. Journalistikk koster penger å lage, og betalingsmuren finnes fordi innholdet har en verdi. Hvis en dominerende plattform kan hente materialet, bruke det til å forbedre egne produkter og samtidig bli stedet der publikum får svarene, kan trafikk, abonnementer og annonseinntekter flyttes bort fra dem som betalte for arbeidet.
Det betyr ikke at de norske mediehusene automatisk har rett i alle juridiske spørsmål. Schibsted, NRK og TV 2 er heller ikke små og maktesløse aktører. Men størrelsen deres endrer ikke det prinsipielle spørsmålet: En aktør skal ikke kunne ta seg til rette i andres arkiver bare fordi den kontrollerer en viktig inngang til publikum.
Samtidig bør utfallet ikke bli en ordning som bare de største mediehusene har råd til å bruke. Hvis løsningen ender i dyre spesialavtaler, kompliserte reservasjonsordninger og juridiske skjemaer, går de store gjennom porten mens små utgivere blir stående ute. Den fellen kjenner vi. Rettigheten til eget innhold må være forståelig og praktisk også for lokalavisen, fagbladet og den lille nettutgiveren.
Norge skal ifølge NRK og MBL være det første landet som tar akkurat disse vilkårene til retten. Dermed kan Oslo tingrett få betydning langt utenfor de 10 aktørene som står bak begjæringen. Vilkårene er globale, og utgiverorganisasjoner i EU og Storbritannia har allerede protestert.
Hva bør bedrifter gjøre før 20. november?
Har du en Facebook-side, Instagram-konto eller andre Meta-produkter som brukes i virksomheten, bør du lese varselet i din egen bedriftskonto før 20. november. Ikke stol på en skjermdump fra en amerikansk konto eller et sammendrag i en nyhetssak. Ulike språkversjoner av teksten har ikke vært like, og det er vilkårene Meta faktisk viser deg som er relevante.
Lagre en datert kopi av vilkårene og noter hvilke nettsteder og domener som er knyttet til kontoen. Kontroller serverlogger eller trafikkoversikter for Meta-crawlere, og sjekk hva som faktisk ligger tilgjengelig for testkontoer. Har du kundeområder, staging-miljøer eller annet innhold som ikke skal indekseres, er dette et godt tidspunkt for å gå gjennom tilgangene.
Du kan også kontrollere robots.txt, men ikke behandle den som en juridisk trylleformel. En blokkering kan påvirke både indeksering og hvordan innhold vises på Meta-plattformene. En detaljert gjennomgang av vilkårene og crawlerne anbefaler å skille mellom Metas ulike roboter, fordi de ikke har samme funksjon.
For norske medier er rådet enda enklere: Fortsett å presse fram et tydelig svar. Enten skal Meta ha adgang til AI-trening, eller så skal selskapet ikke ha det. Enten respekteres reservasjoner uten at synligheten straffes, eller så gjør de ikke det. Slike spørsmål skal ikke begraves i en tekst de fleste aksepterer ved å fortsette som før.
Retten må få prøve makten bak avkrysningsboksen
Det mest interessante ved saken er ikke om Meta kan skrive vilkår med mange juridiske ord. Det kan selskapet helt sikkert. Spørsmålet er hvor mye en dominerende plattform kan kreve når alternativet for en bedrift er å miste tilgang til Facebook og Instagram som distribusjonskanaler.
De norske mediene gjør derfor rett i å be om en avklaring før 20. november, ikke etter at innholdet eventuelt er hentet og brukt. Data som først er samlet inn, lar seg ikke alltid putte pent tilbake i arkivet. En midlertidig stans er nettopp laget for situasjoner der skaden kan være vanskelig å reversere.
Meta kan avvæpne mye av konflikten selv: Skriv klart hva crawlerne får hente, hva materialet kan brukes til, hvordan en virksomhet sier nei, og at et nei ikke straffes med dårligere distribusjon. Hvis vilkårene ikke er ment å gi adgang til AI-trening på journalistikk, bør det stå uten forbehold. Fram til det skjer, er det helt rimelig at noen ber retten se nærmere på makten bak avkrysningsboksen.
Ofte stilte spørsmål
Har norske mediebedrifter allerede saksøkt Meta?
De har bedt Oslo tingrett om en midlertidig forføyning som skal stanse de nye vilkårene mens lovligheten vurderes. Begjæringen kommer fra 10 aktører, blant dem NRK, TV 2, Schibsted, Amedia og NTB.
Når skal Metas nye vilkår begynne å gjelde?
Meta har utsatt ikrafttredelsen fra 30. oktober til 20. november 2026. Selskapet sier utsettelsen skal gi mer tid til å forklare hva som endres. Den omstridte tillatelsen til automatisert innhenting fra tilknyttede nettsteder står fortsatt i teksten.
Gir vilkårene Meta rett til å trene AI på betalingsartikler?
Det er ikke rettslig avgjort. En tidligere tekst nevnte trening uttrykkelig, men ordet er fjernet. Utgiverne mener den gjenværende ordlyden fortsatt er vid nok til AI-bruk, mens Meta sier den gjelder annonse- og bedriftsprodukter og ikke gir nye rettigheter til å skrape nyhetssider.
Kan en bedrift bare blokkere Metas crawlere?
En bedrift kan bruke robots.txt til å styre Metas crawlere, og Meta sier slike valg respekteres. Men crawlerne har ulike oppgaver, og blokkering kan påvirke AI-indeksering, lenkeforhåndsvisninger eller annonser. Derfor er ikke en teknisk blokkering et fullgodt alternativ til tydelige avtalevilkår.