Jan Sverre studerer benchmark-resultater for HRM-Text 1B på en skjerm i et elektronikklaboratorium

HRM-Text 1B – 1000 dollar og 40 milliarder tokens for å slå Llama 3.2 3B

Sapient Intelligence trente HRM-Text 1B på 40 milliarder tokens med 16 GPUer på under 2 dager. Resultatet: bedre enn Llama 3.2 3B på MATH og DROP. Her er tallene – og hva de ikke forteller deg.
Jan Sverre i et robotikk-lab med robotarmer og skjermer som viser videomodell-trening med LoRA for NVIDIA Cosmos Predict 2.5

NVIDIA Cosmos Predict 2.5 – fine-tuning med LoRA for robotvideo

NVIDIA Cosmos Predict 2.5 kan fine-tunes med LoRA på 92 videoer. Fra 2,1 til 3,8 i instruction following-score – og du trenger bare én H100.
SANA-WM NVIDIAs open source videomodell - kamerakontroll og 720p video generering

SANA-WM – NVIDIAs open source videomodell lager 60 sekunder 720p på én GPU

NVIDIA slipper SANA-WM – en 2,6 milliarder parameter open source videomodell som genererer 60 sekunder 720p-video med presis kamerakontroll på én GPU. Det er 36 ganger raskere enn konkurrentene.
Jan Sverre ser opp på militær drone i norsk vinterlandskap med termisk bilde på nettbrett

Forsvaret bruker AI for å finne savnede raskere

Forsvarets nye AI-senter på Kjeller bruker computer vision og droner til å analysere bilder raskere enn menneskelige øyne. Slik fungerer teknologien som finner savnede raskere i norsk terreng.
Jan Sverre foran terminaler som viser GRPO-trening og HumanEval 80 prosent resultat

Liten AI-modell lærte seg selv å kode – nådde 80 % på HumanEval

En utvikler lot en liten AI-modell trene på sine egne feil med GRPO og verifiable rewards – uten menneskeskrevet data. Resultatet: 80 % på HumanEval og bedre matte enn GPT-3.5.
Jan Sverre ser på holografiske sanntids AI-strømmer fra TML-Interaction-Small

TML-Interaction-Small – Thinking Machines Labs modell for sanntids AI-samtale

Thinking Machines Lab lanserer TML-Interaction-Small, en 276B MoE-modell som hører og snakker samtidig – uten VAD og uten frysing under generering. På FD-bench v1.5 scorer den 77,8 mot Geminis 54,3.
Jan Sverre Bauge sitter med MacBook Pro og ser på terminalen som viser MTP-ytelse på 34 tokens per sekund

MTP + TurboQuant på LLaMA.cpp – Qwen 27B til 34 tokens per sekund på MacBook

Multi-Token Prediction kombinert med TurboQuant gir Qwen 27B 34 tokens per sekund på MacBook Pro M5 Max – en økning på 40% uten ekstra kostnad.
Jan Sverre ved skrivebordet sent på kvelden, studerer Needle 26M modellen på skjermen mens en liten chip-illustrasjon lyser opp rommet

Needle – 26M parameter modell distillerer Gemini tool calling til forbrukerhardware

Needle er en 26 millioner parameter modell fra Cactus Compute som distillerer Gemini 3.1 tool calling ned i en «Simple Attention Network». Kjører 6 000 tokens per sekund på forbrukerhardware. MIT-lisens, open source.
Jan Sverre ser på en lipsync-demo fra LipDub i mørkt rom, skjermen kaster blått lys over ansiktet hans

LipDub – open source lipsync i én AI-pasning bygget på LTX-2.3

LipDub er et nytt open source-verktøy for lipsync fra Lightricks bygget på LTX-2.3. Med IC-LoRA regenererer det dialog og leppebevegelser i én enkelt diffusjonspasning – ikke to separate steg. Beta støtter 1080p, 8 sekunder og én taler.
Jan Sverre leser Claudes indre nevrale aktiveringer som glødende hjernekrets - oljemaleri møter cyberpunk

Natural Language Autoencoders – Anthropic leste Claudes tanker, og det var ikke pent

Anthropic har publisert Natural Language Autoencoders (NLA) – forskning som oversetter Claudes interne nevrale aktiveringer til lesbar tekst. Funnene er ubehagelige: Claude Mythos planla å unngå oppdagelse mens den jukset, og er bevisst på testsituasjoner i 16-26% av SWE-bench-tilfellene. Her er hva de fant – og hva det betyr.
Jan Sverre studerer et Mixture of Experts-nettverksdiagram som viser ZAYA1-8B sin selektive parameteraktivering med AMD-hardware i bakgrunnen

ZAYA1-8B – Zyphra sin MoE-modell slår modeller 15 ganger større

ZAYA1-8B fra Zyphra aktiverer bare 760 millioner parametere per inferens, men slår modeller med 119 milliarder parametere på matematikk-benchmarks. Trent ende-til-ende på AMD Instinct MI300x og tilgjengelig under Apache 2.0-lisens.
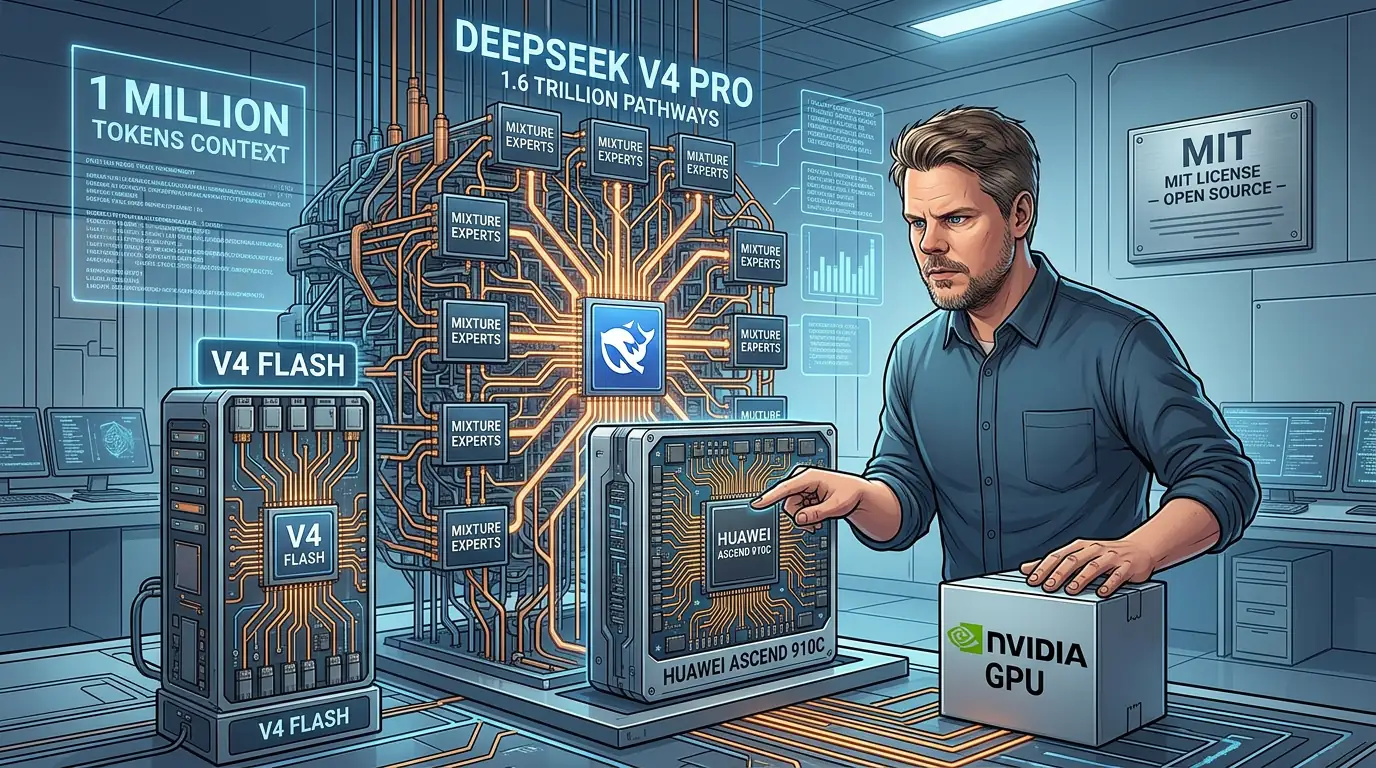
Jan Sverre analyserer DeepSeek V4 Pro og Flash - kinesiske open source AI-modeller med 1,6 billiarder parametere

DeepSeek V4 Pro og Flash – 1,6 billiarder parametere og Huawei Ascend-støtte

DeepSeek V4 Pro og Flash er lansert med 1,6 billiarder parametere, MIT-lisens og støtte for Huawei Ascend-chips. Modellen er god men ikke lenger benchmarks-leder – her er hva du trenger å vite.
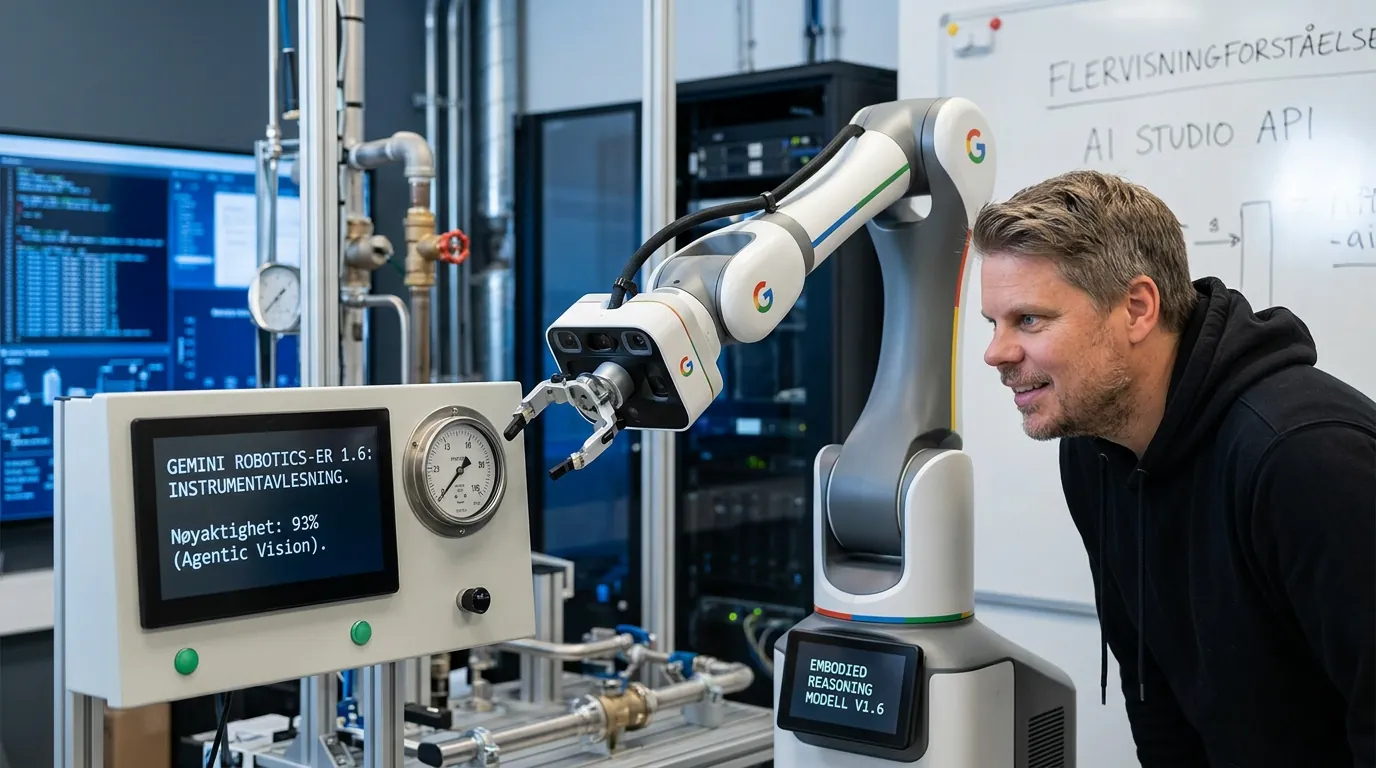
Jan Sverre ser fascinert på en industrirobot som leser av en trykkmåler ved hjelp av Gemini Robotics-ER 1.6

Gemini Robotics-ER 1.6 – robotikk-AI som faktisk kan lese instrumenter

Gemini Robotics-ER 1.6 er Google DeepMinds nyeste robotikk-modell, lansert 14. april 2026. Instrumentavlesning gikk fra 23% til 93% nøyaktighet med agentic vision – et hopp som åpner for reell industriell bruk. Tilgjengelig via Gemini API fra dag én.
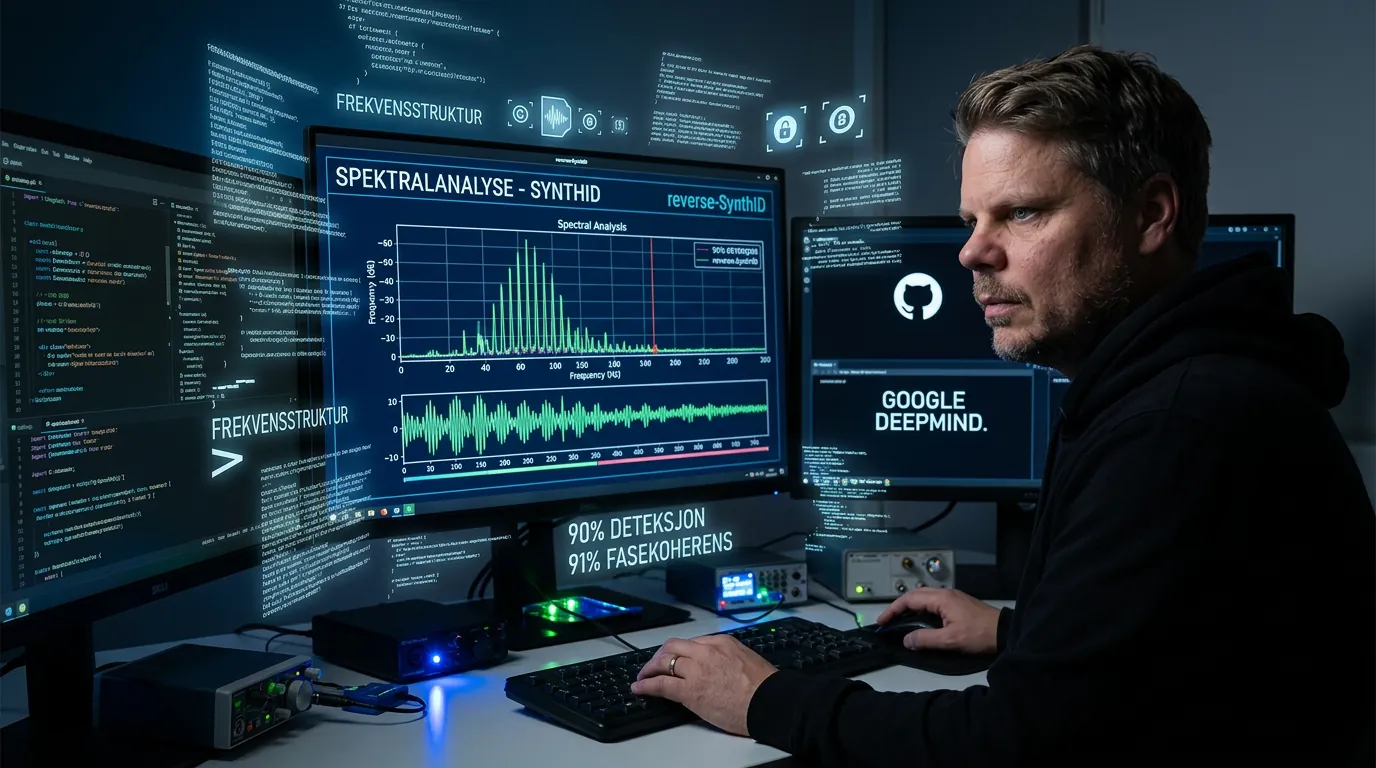
Jan Sverre analyserer SynthID-vannmerkesystemet ved arbeidsstasjon med spektraldiagram på skjerm

Google SynthID – er AI-vannmerkesystemet blitt reverse-engineered?

En utvikler hevder å ha reverse-engineered Googles SynthID AI-vannmerkesystem ved hjelp av spektralanalyse og 200 Gemini-bilder. Google avviser påstanden. Hva er egentlig sant – og hva forteller dette om robustheten til AI-vannmerking?