Innhold Vis
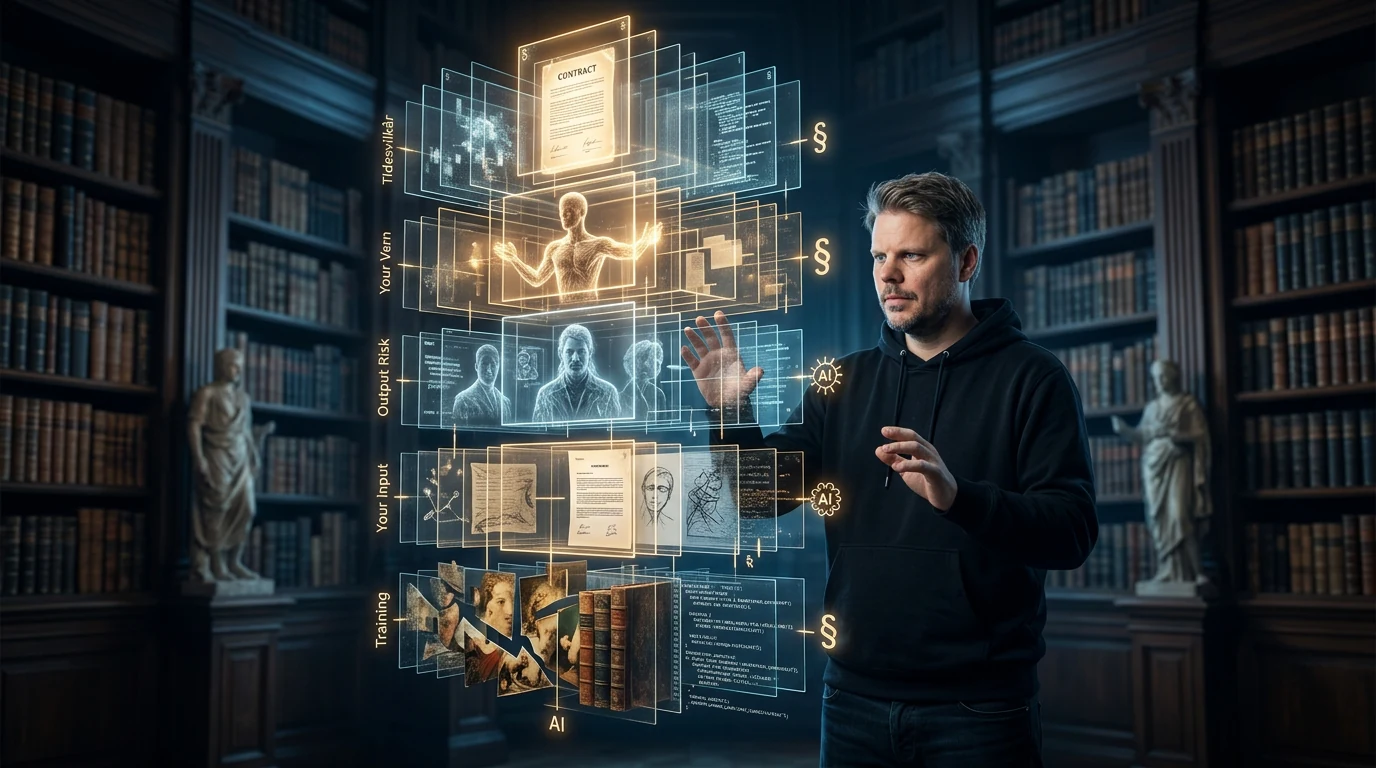
AI og opphavsrett er ikke ett juridisk spørsmål. Det er minst fem forskjellige spørsmål som må besvares før du laster opp, lager, publiserer eller selger noe med AI. Hvem eier inputen? Hva ble modellen trent på? Kan resultatet krenke andre? Har resultatet selv opphavsrett? Og hva sier avtalen med AI-tjenesten?
Det er derfor debatten så ofte går i grøfta. Én person snakker om ulovlig skraping av millioner av bøker. En annen snakker om retten til et bilde hun har redigert i tre dager. En tredje peker på at tjenesten tillater kommersiell bruk. Alle sier «AI og copyright», men de diskuterer helt forskjellige handlinger og helt forskjellige rettigheter.
Jeg skal skille dem fra hverandre. Dette er generell informasjon og analyse, ikke individuell juridisk rådgivning. Lovstatusen for Norge er datert 13. september 2026, fordi både norske lovforslag og europeiske AI-regler er i bevegelse.
De fem spørsmålene du må holde fra hverandre
Før du vurderer om AI-bruken er trygg, må du undersøke fem lag: modellens trening, retten til å bruke dagens input, risikoen for at output krenker andre, om resultatet har eget vern, og hvilke rettigheter tjenesteavtalen faktisk gir deg. Ett ja svarer ikke automatisk på de fire andre.
Det første spørsmålet gjelder materialet som ble brukt da grunnmodellen ble trent. Det andre gjelder det du selv sender inn nå – en prompt, kontrakt, bok, kundeliste, lydfil, illustrasjon eller kildekode. Det tredje gjelder resultatet: Kopierer det et eksisterende verk eller andre beskyttede kjennetegn? Det fjerde er om dine egne skapende valg er sterke nok til at hele eller deler av resultatet får opphavsrettslig vern. Det femte ligger i kontrakten mellom deg og leverandøren.
En tjeneste kan altså gi deg lov til kommersiell bruk uten at en ren maskinframbringelse nødvendigvis får opphavsrett. Et resultat kan mangle eget vern og samtidig krenke et eksisterende verk. En modell kan være lovlig tilgjengelig for deg selv om treningsgrunnlaget er omstridt. Og du kan ha lovlig tilgang til et dokument uten at det betyr at du kan sende en kopi til en ekstern AI-tjeneste.
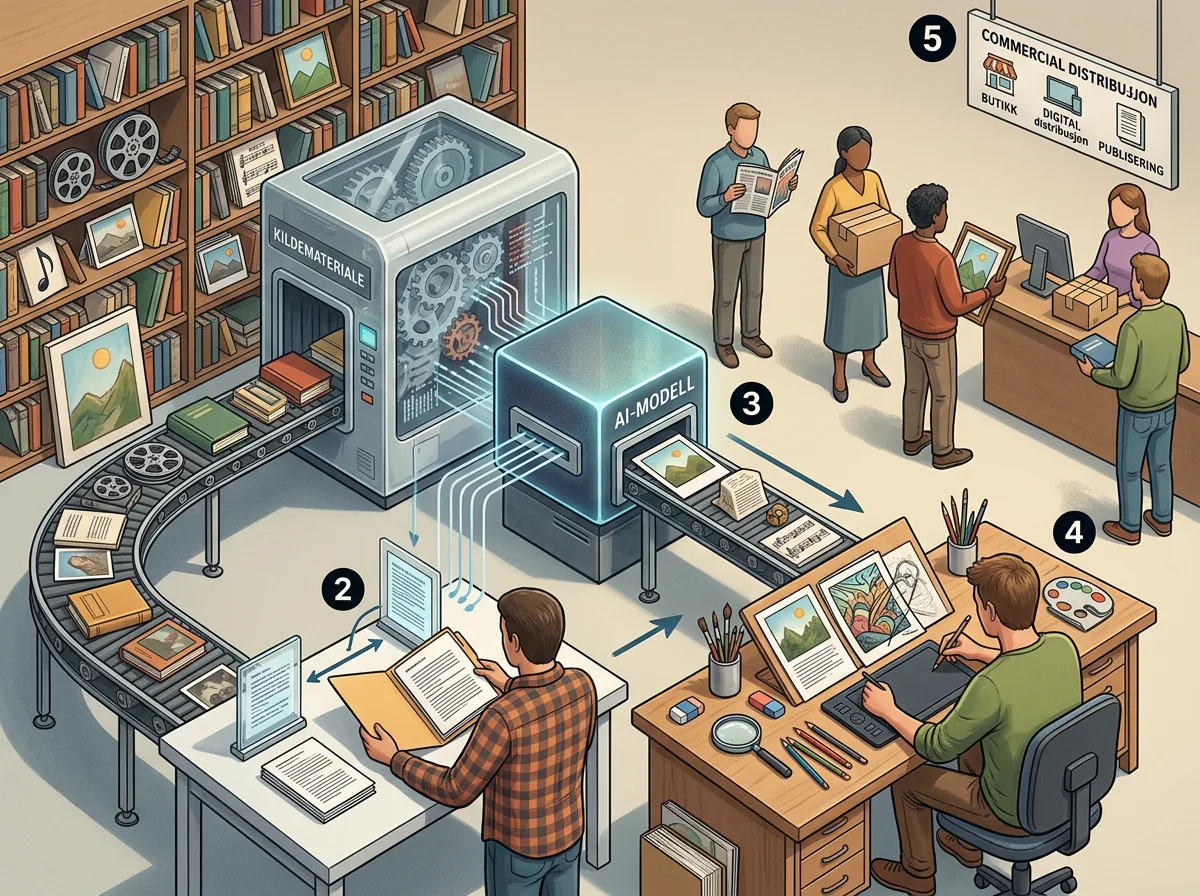
Denne oppdelingen er ikke juridisk flisespikkeri. Den er en praktisk måte å unngå dyre feil på. Hvis noen sier «du eier outputen», bør det første motspørsmålet være: Hva mener du med eier, og hvilket av de fem spørsmålene har du faktisk svart på?
Hva beskytter opphavsretten i Norge?
Norsk opphavsrett beskytter originale litterære og kunstneriske verk, ikke enhver idé, metode eller teknikk. Vernet oppstår hos den som skaper verket når uttrykket bærer preg av original og individuell skapende innsats. Det kreves ingen registrering for at vernet skal oppstå.
Kultur- og likestillingsdepartementets oversikt over opphavsretten, oppdatert 19. mars 2026, forklarer at opphaveren som hovedregel har enerett til å lage eksemplarer og gjøre verket tilgjengelig for allmennheten. Loven har samtidig avgrensninger, blant annet regler om kopiering til privat bruk og sitatrett. Navngivelse og vern mot krenkende bruk hører også med.
Det avgjørende skillet går mellom ideen og det konkrete uttrykket. Ideen om en ung trollmann er ikke det samme som en bestemt figur med navn, symboler, klær, relasjoner og en gjenkjennelig verden. En musikksjanger er ikke det samme som en bestemt melodi. En programmeringsmetode er ikke det samme som en konkret bit kildekode.
Det betyr heller ikke at ordet «stil» er et magisk frikort. En generell estetikk kan være noe annet enn et beskyttet verk, men en output kan komme så nær bestemte figurer, tekstpassasjer, komposisjoner, melodier eller andre originale elementer at saken ikke lenger bare handler om stil. Varemerke, markedsføringsrett, personvern og retten til eget ansikt eller egen stemme kan dessuten bli relevante selv når opphavsrett ikke er hovedproblemet.
Har det du lager med AI selv opphavsrett?
Et AI-assistert resultat kan ha opphavsrettslig vern når et menneskes originale, skapende valg faktisk kommer til uttrykk i resultatet. Det finnes derimot ingen enkel norsk regel som sier at én prompt automatisk gjør brukeren til opphaver av alt modellen leverer.
En prompt som «lag et fint bilde» etterfulgt av valg av første resultat gir et svakt grunnlag for å peke på menneskelig utforming av selve uttrykket. Femti prompter og mange regenereringer viser mer arbeid, men arbeidstid er ikke det samme som originalitet. Det sentrale spørsmålet er hvilke konkrete skapende valg du har tatt, og om de kan sees i verket.
Grunnlaget blir sterkere når du lager skissen, bestemmer komposisjonen, skriver teksten, styrer bestemte uttrykkselementer, kombinerer flere resultater og redigerer vesentlig. Bruker du AI til avgrenset etterarbeid i et ellers selvskapt verk, forsvinner ikke vernet i ditt menneskelige arbeid av den grunn. Vernet kan knytte seg til de menneskeskapte delene eller til en original bearbeiding og sammenstilling, uten at du dermed får monopol på alt modellen bidro med.
Her er USA nyttig som sammenligning, men ikke som norsk fasit. U.S. Copyright Office skrev i sin Part 2-rapport fra januar 2025 at AI-output kan vernes når et menneske har bestemt tilstrekkelige uttrykkselementer, eller når menneskelig materiale, kreativ bearbeiding eller arrangement kan skilles ut. Ren prompting ble ikke ansett som tilstrekkelig. Amerikansk rett er ikke norsk rett, men sammenligningen viser hvorfor den faktiske skapende prosessen betyr mer enn hvor mange timer eller kroner du brukte.
Dette har en praktisk bakside som er lett å overse. Hvis de maskinbestemte delene mangler vern, kan du ha lov til å selge resultatet uten å ha den eksklusiviteten du trodde du kjøpte. En konkurrent kan kanskje kopiere elementer du oppfattet som «dine». For et hobbybilde er det kanskje uvesentlig. For en figur, en produktserie eller en hel merkevare kan det være et forretningsproblem.
Kan AI-resultatet krenke andres verk?
Ja. AI er ikke et juridisk skjold mellom deg og materialet som kommer ut. Et resultat kan gjengi hele eller beskyttede deler av tekst, bilde, musikk, kode, film eller spillmateriale, og vurderingen må gjøres konkret etter reglene som gjelder der innholdet brukes.
Det finnes ikke et trygt prosenttall for hvor likt et verk kan være. Se heller på en stigende skala: lik idé eller tema, generell sjanger eller stil, lignende teknikk eller stemning, konkrete og gjenkjennelige uttrykkselementer, og til slutt nesten identisk eller direkte gjengivelse. Risikoen blir tydeligere jo lenger ned på listen du kommer, men det finnes ingen automatisk grense som løser vurderingen for deg.
For kode er funksjonalitet og metode noe annet enn konkret kildekode. Likevel kan en kodeassistent returnere gjenkjennelige kodebiter eller materiale som følger bestemte lisensvilkår. En bedrift bør derfor behandle AI-kode som annen kode den ikke fullt ut kjenner opphavet til: gjennomfør kodegjennomgang, lisenskontroll og sikkerhetsskanning før den går i produksjon.
Det samme gjelder bilder, musikk og tekst. Ikke stol på at merkelappen «AI-generert» betyr «rettighetsfritt». Jeg har tidligere skrevet om hvorfor AI-musikk fortsatt kan være menneskelig skapende arbeid, men menneskelig innsats i ditt resultat fjerner ikke rettighetene andre kan ha i materiale som er kopiert inn i det.
Hva kan du gjøre med en bok du har kjøpt?
En kjøpt bok viser hvor galt det blir å presse all AI-bruk inn i samme boks. Tenk på fire handlinger: privat analyse med lokal AI, opplasting av hele boken til en skytjeneste, gjengivelse av boken eller store deler av den, og salg av en filmatisering uten tillatelse. Du starter med samme bok, men gjør fire vesentlig forskjellige ting.
Jeg mener at jeg må kunne bruke en bok jeg lovlig har kjøpt som privat referanse-, analyse- eller RAG-materiale i min egen lokale AI. Da blir dataene på min maskin, og en tredjepart får ikke en ny kopi. Det er mitt prinsipielle syn på privat råderett over et lovlig kjøpt eksemplar – ikke en påstand om at kjøpet overfører opphavsretten, og ikke en garanti for at enhver tenkelig lokal AI-behandling er rettslig avklart.
Jeg ville ikke lastet hele den samme boken opp til en kommersiell sky-AI. Da gir jeg en tredjepart en kopi, og spørsmålene blir flere: Hva lagres, hvor lenge lagres det, brukes innholdet til trening, og hva tillater avtalen? Hvis systemet senere viser lange utdrag til andre, er vi enda lenger unna privat lesing og analyse.

Å bruke AI til å gjenskape eller distribuere hele boken er noe helt annet igjen. Det samme gjelder en filmatisering av romanens beskyttede fortelling uten tillatelse. Opphavsretten fordamper ikke fordi kamera, skuespillere, illustratører eller deler av produksjonen er erstattet av generative verktøy.
Dette skillet forklarer også hvorfor jeg reagerer på selskaper som kopierer enorme mengder beskyttet materiale inn i kommersielle systemer uten avklarte rettigheter. En privat lokal kunnskapsbase er ikke det samme som å bygge en global tjeneste på millioner av verk. Saker om bøker som ble kjøpt, skannet og ødelagt for AI-trening og søksmål om bokbruk i Gemini-trening viser hvor konkret striden om treningsgrunnlaget har blitt.
Trening, finjustering, RAG og input er ikke det samme
Grunntrening former modellens parametre med svært store mengder materiale. Finjustering trener en eksisterende modell videre på et mindre og mer målrettet datasett. RAG henter dokumenter fram når brukeren spør og legger relevante utdrag inn som kontekst. Dagens input er filen, prompten, bildet eller koden du sender til modellen akkurat nå.
RAG betyr ikke nødvendigvis at dokumentene blir bakt inn i modellvektene. Men «modellen trenes ikke på dette» er ikke det samme som at opphavsrett, konfidensialitet og avtaler er borte. Systemet kan fortsatt kopiere, lagre, hente fram og vise beskyttede utdrag. En privat lokal RAG-løsning og en offentlig abonnementstjeneste som svarer tusenvis av brukere med lange bokutdrag har helt ulik rekkevidde.
Lokal behandling endrer også hvem som får tilgang. I skyen må du undersøke om leverandøren lagrer innholdet, bruker det til videre trening, sender det til underleverandører eller behandler det i andre land. Kundemateriale kan i tillegg inneholde personopplysninger, konfidensiell informasjon eller forretningshemmeligheter. Det er egne spørsmål som ikke bør klistres på opphavsretten som om alle regler var én suppe.
På treningssiden er standpunktet mitt klart: Jeg er mot at AI-selskaper skraper opphavsrettsbeskyttet musikk, bøker og annet materiale og tjener penger på kommersielle skytjenester uten å avklare rettighetene. Lisensiert trening viser at andre veier finnes. Suno v6 og overgangen til lisensiert musikk er ett konkret eksempel på at treningsgrunnlaget kan bli en del av selve produktvalget.
Hva er gjeldende lov i Norge 13. september 2026?
Gjeldende norsk grunnlag er åndsverkloven fra 2018 med senere endringer. Prop. 41 LS (2025-2026), med forslag til nye regler om blant annet tekst- og datautvinning, er fortsatt et lovforslag. De foreslåtte paragrafene 50 d, 50 e og 50 f er ikke gjeldende norsk lov per 13. september 2026.
Stortingets saksside for Prop. 41 LS viser at forslaget fortsatt behandles i familie- og kulturkomiteen. Fristen for skriftlige innspill er 28. september 2026, og planlagt frist for komitéinnstilling er 3. november 2026. Første og andre behandling er ikke gjennomført. Datoene er viktige: Et forslag i en proposisjon er ikke lov bare fordi teksten er offentlig.
Regjeringens proposisjon om tekst- og datautvinning sier at AI-trening kan innebære slik utvinning, og at reglene det arbeides med gjelder input- og treningssiden – ikke rettighetene til output. Forslaget legger også opp til at rettighetshavere kan reservere materiale mot visse former for tekst- og datautvinning. Grensen mellom menneskeskapte verk og AI-frambringelser trenger fortsatt avklaring, blant annet gjennom rettspraksis.
Norges gjennomføring av EUs AI Act er heller ikke ferdig. Regjeringen opplyste 4. august 2026 at forslaget til norsk AI-lov skal på ny høring høsten 2026, med ambisjon om en proposisjon våren 2027. Det er altså feil å skrive at hele AI Act allerede gjelder som norsk lov.
Dette er også et område der et komplisert lisens- og kontrollsystem lett kan bli en bomstasjon bare de største selskapene har råd til å passere. Skapere trenger reelt vern. Men hvis etterlevelse krever en hær av advokater, styrker systemet fort gigantene som allerede har kapital, datasentre og juridiske avdelinger. Da står den lille illustratøren fortsatt ute i regnet.
Hva krever EU av tilbydere av generelle AI-modeller?
I EU har forpliktelsene for tilbydere av generelle AI-modeller etter AI Act artikkel 53 vært anvendelige siden 2. august 2025. Kravene gjelder leverandørsiden og må holdes atskilt fra spørsmålet om norsk opphavsrett til ditt konkrete resultat.
Europakommisjonens veiledning for tilbydere av generelle AI-modeller beskriver blant annet krav om en policy for å følge EUs opphavsrett og respektere rettighetsreservasjoner. Tilbyderen skal også offentliggjøre en tilstrekkelig detaljert oppsummering av hvilke typer innhold modellen ble trent på. Kravet til treningsoppsummering omfatter også modeller med åpne lisenser.
Åpenhet er nyttig, men den er ikke en velsignelse fra Brussel som gjør ethvert datasett lovlig. En offentlig oppsummering kan gjøre det enklere for rettighetshavere å forstå datakildene og håndheve rettigheter. Den beviser ikke at alt innhold var lisensiert eller at enhver bruk var lovlig.
For norske brukere er EU-reglene internasjonalt relevante fordi mange tjenester tilbys i EU og utvikles for det europeiske markedet. Likevel må du merke kartet riktig: EU-krav til modelltilbydere, norsk opphavsrett, en framtidig norsk AI-lov og leverandørens egne vilkår er fire forskjellige lag.
Hvor mye betyr tjenestevilkårene?
Tjenestevilkårene bestemmer hva leverandøren lover deg og hvilke rettigheter partene fordeler seg imellom. Når en AI-tjeneste skriver at du «eier output» eller kan bruke den kommersielt, kan det være verdifullt. Men setningen er ikke en garanti for opphavsrettslig vern og heller ikke et frikort mot krav fra andre.
Vilkårene kan ikke gi deg mer enn leverandøren selv har rett til å gi. De kan heller ikke trylle bort en tredjeparts opphavsrett eller gjøre en maskinframbringelse vernet dersom loven ikke oppfyller vilkårene for vern. Samtidig kan avtalen begrense bruk som ellers ikke nødvendigvis ville vært forbudt av opphavsretten.
Kontroller derfor den konkrete tjenesten, abonnementstypen og datoen. Se etter regler om kommersiell bruk, bruk av input og output til trening, lagring, ansvarsfordeling og eventuelt juridisk forsvar eller erstatning. Ikke stol på et skjermbilde av vilkår fra i fjor. Avtalen du faktisk har, er den som betyr noe.
For bedrifter må dette inn i kunde- og samarbeidsavtaler også. Hvem leverte grunnmaterialet? Hvilket AI-verktøy ble brukt? Hvem gjorde de skapende valgene? Hvem skal kontrollere outputen, og hvem bærer risikoen hvis noen fremmer et krav? «AI-en laget det» er ikke en ansvarsfordeling.
Menneskelig læring og maskinlæring ligner – men er ikke identiske
Mennesker lærer ved å lese bøker, høre musikk, se bilder, spille spill og studere andres arbeid. Ingen skaper kultur i vakuum. Det blir derfor for enkelt å omtale all læring fra eksisterende verk som tyveri bare fordi en maskin er med i prosessen.
Men motsatsen er like svak: At mennesker lærer av kunst betyr ikke automatisk at et selskap kan kopiere millioner av verk inn i en kommersiell modell uten å avklare noe som helst. Skalaen, hastigheten, eksemplarframstillingen og den kommersielle konkurransen kan være helt annerledes. Et menneskes hukommelse, min private lokale RAG og et globalt selskap som bygger en abonnementstjeneste er ikke samme handling.
AI tvinger oss til å undersøke grensen mellom å lære av et verk, kopiere verket og bygge en kommersiell maskin på kunnskap hentet fra eksisterende kultur. Opphavsrett har en legitim funksjon: Mennesker må kunne kontrollere og tjene penger på arbeid de har skapt. Samtidig må ideer, kunnskap og teknikker kunne inspirere nye verk. Ellers får vi ikke kultur, bare inngjerdede revir.
Jeg vil beskytte mennesket som skaper uten å gjøre opphavsrett til et system der store selskaper og portvakter får eierskap til all kultur, læring og teknologi. Det er derfor skillet mellom privat lokal bruk og uavklart kommersiell skraping betyr så mye. Begge sider taper hvis debatten reduseres til «all AI er tyveri» eller «alt på nettet er gratis».
En praktisk sjekkliste før du publiserer eller selger
Begynn med inputen. Er materialet ditt eget, lisensiert, i det fri, kjøpt for privat bruk eller bare hentet tilfeldig fra nettet? Skriv ned svaret før du legger det inn i et system. Hvis du ikke vet hvor materialet kom fra, vet du heller ikke hvilke rettigheter eller begrensninger som følger med.
- Kartlegg materialet: Noter opphav, lisens, kjøpsvilkår og hva du faktisk har lov til å gjøre.
- Skill lokal behandling fra sky: Finn ut hvem som får en kopi, hvor den lagres og om leverandøren bruker den videre.
- Les vilkårene: Kontroller kommersiell bruk, trening, lagring, ansvar og eventuelle begrensninger for abonnementet ditt.
- Dokumenter den menneskelige prosessen: Behold skisser, egne utkast, prosjektfiler, redigeringer, valg og versjonshistorikk.
- Kontroller outputen: Søk etter mistenkelig tekst, musikk, kode, figurer og bildeelementer før publisering.
- Avklar ansvar skriftlig: Beskriv hvem som laget hva, hvilket verktøy som ble brukt, og hvem som håndterer et eventuelt krav.
- Vær ekstra forsiktig med fortrolig materiale: Kundedata, upubliserte manus, intern kode, ansikter, stemmer og personopplysninger trenger egne vurderinger.
- Bruk fagfolk når verdien er høy: Ved stor kommersiell verdi eller reell konfliktfare bør en jurist med relevant opphavsrettskompetanse se på saken.
Dokumentasjon er særlig viktig dersom verket skal lisensieres, selges til en kunde, inngå i en investering eller bygges videre på av andre. Lagre mer enn sluttfilen. Skisser og versjonshistorikk kan vise hvilke valg mennesket tok, mens kildeoversikten kan vise at inputen hadde et ryddig grunnlag.
Bruk også vanlig fagkontroll. AI-kode skal gjennom review og lisensskann. Musikk bør kontrolleres for gjenkjennelige melodier og opptak. Bilder og figurer bør undersøkes før de havner i en kampanje. Tekst bør søkes opp dersom formuleringer virker mistenkelig ferdige. Ingen av kontrollene gir en absolutt garanti, men de er langt bedre enn å lene seg på ordet «generert».
En enkel tommelfingerregel er denne: Jo mer et prosjekt skal distribueres, selges, lisensieres eller bygges videre på, desto mindre bør rettighetsgrunnlaget bero på antakelser. Det er kjedelig helt til den dagen det sparer deg for en konflikt. Da er det plutselig den mest spennende mappen i prosjektet.
Hvem eier det du lager med AI?
Det ærlige svaret er at verbet «eier» skjuler flere svar. Du kan ha en kontraktsmessig rett til å bruke outputen, opphavsrett til dine egne skapende bidrag, svak eller ingen enerett til maskinbestemte elementer, og fortsatt en risiko for at resultatet krenker andre. Alt dette kan være sant samtidig.
Derfor bør du aldri stoppe ved leverandørens setning om at outputen er din. Undersøk inputen, skapelsesprosessen, resultatet, loven og avtalen hver for seg. Dokumenter dine egne valg. Kontroller det som skal ut i verden. Og ikke send andres bøker, kundedata eller kode til en sky-AI bare fordi opplastingsknappen er stor og fristende.
Standpunktet mitt er like tydelig som skillet: Skapere skal kunne kontrollere og tjene penger på verkene sine. AI-selskaper skal ikke få late som uavklart kommersiell skraping er det samme som menneskelig læring eller privat bruk. Samtidig må jeg kunne bruke materiale jeg lovlig har kjøpt som privat referanse og analyse i min egen lokale AI, uten at det automatisk likestilles med å bygge en global kommersiell tjeneste.
AI gjør ikke opphavsretten irrelevant. Den gjør det umulig å fortsette å late som alle former for kopiering, læring og skapelse er det samme.
Ofte stilte spørsmål
Kan jeg bruke AI-generert innhold kommersielt?
Ofte tillater tjenestevilkårene kommersiell bruk, men det er ikke hele svaret. Kontroller om inputen kunne brukes, om outputen kan krenke andre, og om dine menneskelige bidrag gir opphavsrettslig vern. Ved høy verdi eller konfliktfare bør du få en konkret juridisk vurdering.
Får jeg opphavsrett bare fordi jeg skrev prompten?
Ikke automatisk. Det avgjørende er om originale, menneskelige skapende valg faktisk kommer til uttrykk i resultatet. Mange prompter viser arbeidsinnsats, men tidsbruk alene skaper ikke opphavsrett. Skisser, styrt komposisjon, egen tekst, utvalg, sammenstilling og vesentlig redigering kan styrke grunnlaget.
Kan jeg analysere en kjøpt bok med lokal AI?
Det finnes ikke en enkel norsk særregel som gjør enhver lokal AI-analyse risikofri. Jeg mener privat lokal analyse og RAG av en bok jeg lovlig har kjøpt bør være mulig, men det er et prinsipielt standpunkt – ikke en juridisk garanti. Kjøpet overfører ikke opphavsretten.
Kan AI-output krenke andres opphavsrett?
Ja. Et resultat kan gjengi beskyttede deler av tekst, bilder, musikk, film eller kode. Det finnes ikke et fast prosenttall som avgjør hvor mye likhet som er tillatt. Se etter konkrete, originale og gjenkjennelige elementer, og kontroller resultatet før publisering.
Hva bør en bedrift dokumentere ved bruk av AI?
Dokumenter kildene til inputen, lisensene, gjeldende tjenestevilkår, verktøy og modell, menneskelige utkast og redigeringer, versjonshistorikk og kontrollen av outputen. Avklar også skriftlig hvem som eier de menneskeskapte bidragene, og hvem som bærer risikoen ved tredjepartskrav.