Jan Sverre i lydstudio ser på holografisk visning av adskilte stemmebølger for identitet og emosjon

Scenema Audio – zero-shot stemmekloning med emosjonell prompting

Scenema Audio lar deg klone en stemme fra 10-20 sekunder audio og styre emosjon via tekstprompt. Open source, MIT-lisens, 16 GB VRAM.
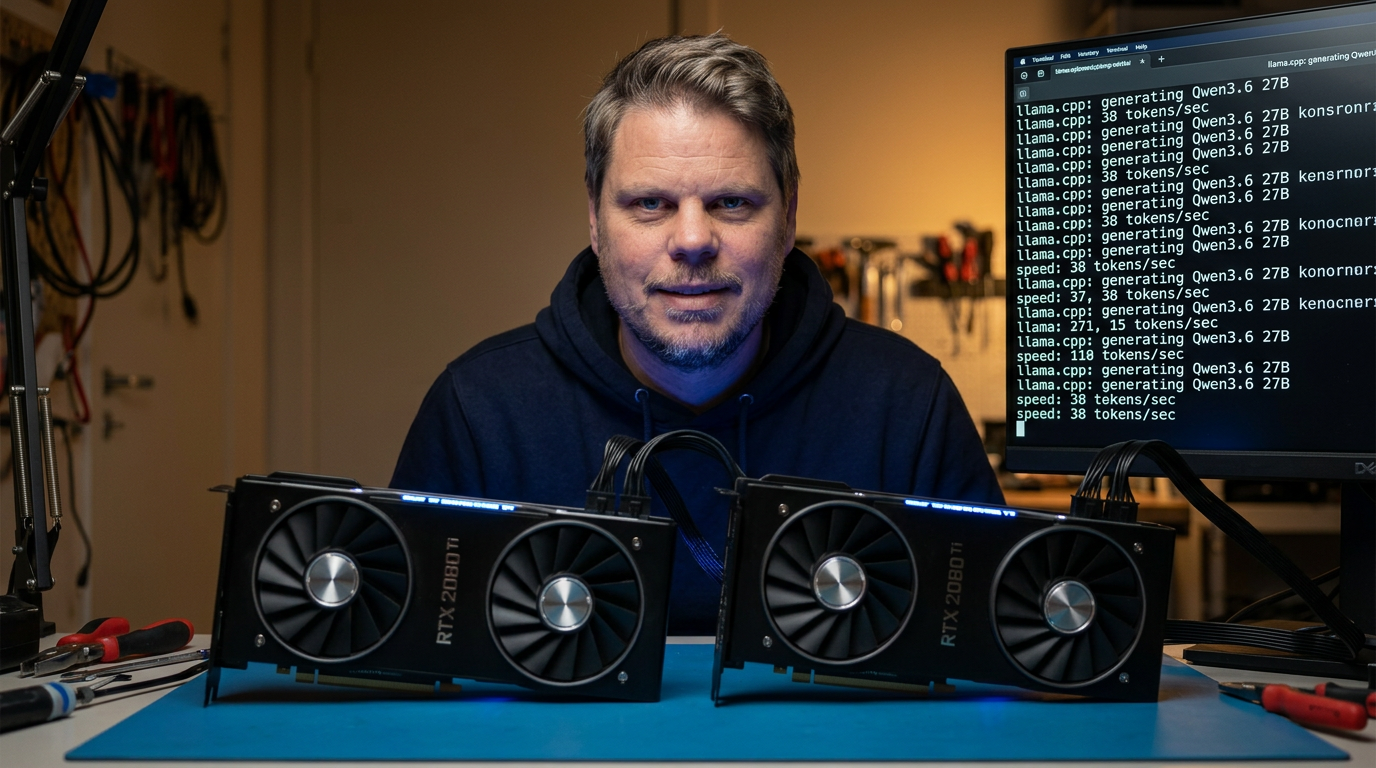
Jan Sverre inspiserer to RTX 2080 Ti grafikkort koblet i dual-GPU-oppsett for lokal AI-inferens

To gamle RTX 2080 Ti gir 38 token/s med Qwen3.6 27B – slik fungerer dual-GPU-oppsett

To RTX 2080 Ti med 22GB VRAM hver gir 38 token/s med Qwen3.6 27B via llama.cpp og Docker. Slik fungerer dual-GPU-oppsett for lokal AI – og hva koster det egentlig?
Jan Sverre ser opp på militær drone i norsk vinterlandskap med termisk bilde på nettbrett

Forsvaret bruker AI for å finne savnede raskere

Forsvarets nye AI-senter på Kjeller bruker computer vision og droner til å analysere bilder raskere enn menneskelige øyne. Slik fungerer teknologien som finner savnede raskere i norsk terreng.
Jan Sverre foran terminaler som viser GRPO-trening og HumanEval 80 prosent resultat

Liten AI-modell lærte seg selv å kode – nådde 80 % på HumanEval

En utvikler lot en liten AI-modell trene på sine egne feil med GRPO og verifiable rewards – uten menneskeskrevet data. Resultatet: 80 % på HumanEval og bedre matte enn GPT-3.5.
Jan Sverre kjører LoRA-trening med Anima TrainFlow på hjemme-PC med GPU

Anima TrainFlow – LoRA-trening på én side med 6GB VRAM

Anima TrainFlow er et gratis LoRA-treningsverktøy som samler alle viktige innstillinger på én side. Kjører på 6GB VRAM, portabelt, og basert på MIT-lisens.
Jan Sverre i et massivt datasenter med serverstativ for Ring-2.6-1T trillion-parameter AI-modell

Ring-2.6-1T – en billion parametere, MIT-lisens og benchmarks som slår GPT-5

Ring-2.6-1T er en open source reasoning-modell med 1 billion parametere fra inclusionAI. MIT-lisens, 128K kontekst og benchmarks som slår GPT-5 og Claude Opus 4.7 – men krever enterprise-infrastruktur for å kjøre.
Jan Sverre sitter i et hjemmelaboratorium omgitt av GPU-er og benchmarkgrafer på skjermen

RTX 5090 og lokal LLM – hva skjer med ytelse når du skrur ned strømmen?

Detaljert benchmark av RTX 5090 ved ulike strømnivåer: prompt parsing, token-generering og strøm-effektivitet for lokal LLM-kjøring. Hvor er sweet spot?
Jan Sverre ved skrivebordet med lokale AI-dokumenter og privat kunnskapsbase på skjermen

Lokal LLM som personlig kunnskapsbase – slik gjør du det privat

Bruk en lokal LLM med dine egne notater, PDF-er og dokumenter som en privat kunnskapsbase. Her er oppsettene som faktisk fungerer i 2026.
Jan Sverre i et lydstudio med mikrofon, omgitt av lydbølger og AI-visualiseringer for DramaBox TTS

DramaBox – den mest ekspressive TTS-modellen du kan kjøre selv

DramaBox fra Resemble AI er en open source TTS-modell som kloner stemmer og styrer latter, sukk og pauser via tekstprompt. Krever 24 GB VRAM.
Jan Sverre ser på holografiske sanntids AI-strømmer fra TML-Interaction-Small

TML-Interaction-Small – Thinking Machines Labs modell for sanntids AI-samtale

Thinking Machines Lab lanserer TML-Interaction-Small, en 276B MoE-modell som hører og snakker samtidig – uten VAD og uten frysing under generering. På FD-bench v1.5 scorer den 77,8 mot Geminis 54,3.
Jan Sverre Bauge sitter med MacBook Pro og ser på terminalen som viser MTP-ytelse på 34 tokens per sekund

MTP + TurboQuant på LLaMA.cpp – Qwen 27B til 34 tokens per sekund på MacBook

Multi-Token Prediction kombinert med TurboQuant gir Qwen 27B 34 tokens per sekund på MacBook Pro M5 Max – en økning på 40% uten ekstra kostnad.
Jan Sverre studerer multimodale AI-resultater fra Ovis2.6-80B på flere skjermer sent på kvelden

Ovis2.6-80B-A3B – multimodal AI med MoE-arkitektur og 64K kontekst

Ovis2.6-80B-A3B er en ny åpen multimodal AI-modell med Mixture-of-Experts-arkitektur som bruker 80 milliarder parametere totalt men bare 3 milliarder under inferens. Apache 2.0-lisens, 64K kontekst og aktiv visuell resonnering.
Jan Sverre holder en Game Boy Color med AI-tekst på pikselskjermen, varmt lampelys i mørkt rom

AI på Game Boy Color – ekte transformer-modell kjører på 8-bit hardware fra 1998

En utvikler har fått Andrej Karpathys TinyStories-260K transformer-modell til å kjøre lokalt på en umodifisert Game Boy Color – uten PC, Wi-Fi eller sky. Her er den tekniske forklaringen og hva det betyr for edge AI.
Jan Sverre ser på benchmarkresultater fra Luce DFlash på AMD Ryzen AI MAX+ 395 med Qwen3.6-27B

Luce DFlash og PFlash på AMD Strix Halo – 2,23x raskere lokal inferens med Qwen3.6-27B

Luce DFlash og PFlash er nå portert til AMD Ryzen AI MAX+ 395 (Strix Halo) med 128 GB unified memory. Qwen3.6-27B kjører 2,23 ganger raskere i decode og 3,05 ganger raskere i prefill enn llama.cpp HIP. MIT-lisens, åpen kildekode.