
Innhold Vis
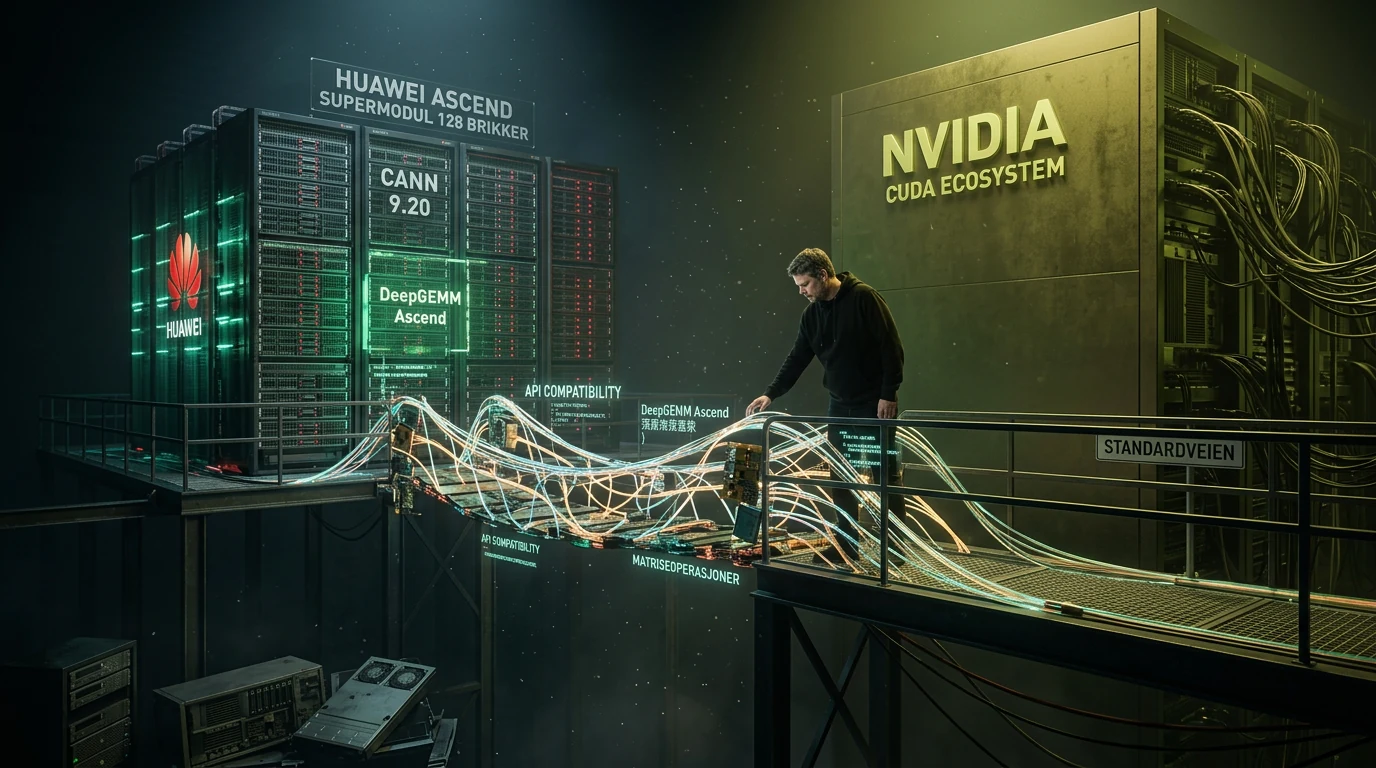
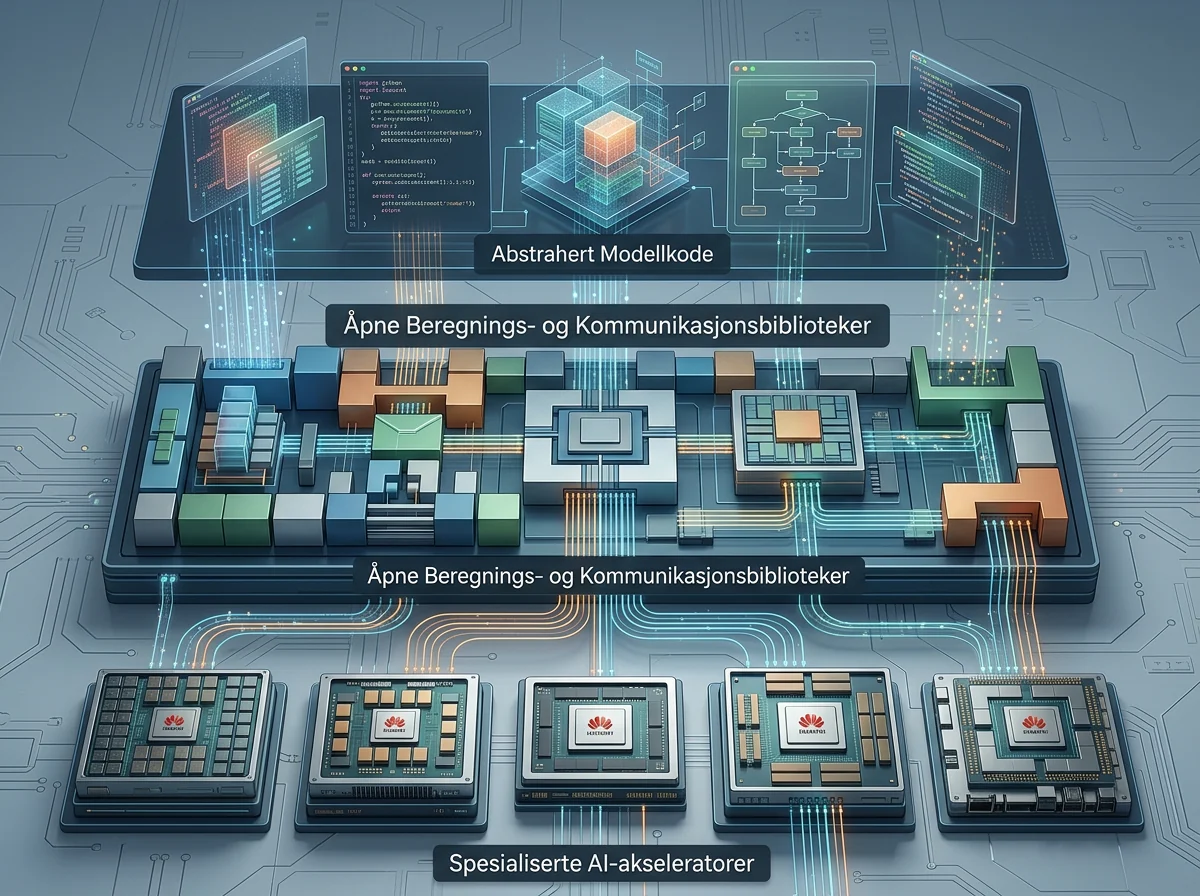
Hvis du vil forstå hva som faktisk kan løsne Nvidias grep om AI-markedet, er det ikke én raskere brikke du skal se etter. Det er programvaren. DeepSeek og Huawei bygger nå programmeringslaget som kan gjøre Ascend-brikker til et reelt alternativ til Nvidia. DeepSeek har åpnet beregnings- og kommunikasjonsverktøy for Ascend-plattformen, samtidig som selskapene har jobbet fram en supernode med 128 Ascend 950-brikker.
Nvidias sterkeste forsvar er ikke bare selve GPU-en. Det er CUDA, bibliotekene, utviklerverktøyene og alle de ferdige arbeidsflytene rundt maskinvaren. En konkurrent kan ha en imponerende brikke på papiret og likevel tape fordi utviklerne må skrive om halve systemet, feilsøke umodne verktøy og vente på støtte for hver nye modellarkitektur.
DeepSeek angriper akkurat den delen av problemet. Det gjør forsøket troverdig. Men jeg ville ikke kalt selskapet fritt fra Nvidia ennå. En fungerende verktøykasse, en 128-brikkers løsning og målinger publisert av utviklerne selv er starten på bevisføringen – ikke slutten.
Hva har DeepSeek og Huawei faktisk lansert?
DeepSeek har åpnet programmeringsinfrastruktur som er tilpasset Huaweis Ascend-plattform, blant annet biblioteker for beregning og kommunikasjon. Huawei har bidratt direkte i utviklingen, og selskapene sier de har optimalisert både regnearbeidet og forbindelsen mellom brikkene i en løsning med 128 Ascend 950-prosessorer, ifølge Reuters’ omtale av kunngjøringen 30. september.
Det konkrete eksempelet er DeepGEMM Ascend på GitHub. Dette er en Ascend-utgave av DeepSeeks bibliotek for raske matriseoperasjoner, selve grunnarbeidet som stadig gjentas når en stor språkmodell trenes eller kjører svar. Biblioteket har samme API som DeepGEMM på andre plattformer og støtter blant annet BF16, FP8, FP4, MQA og selskapets MegaMoE-oppsett.
Poenget med API-kompatibiliteten er praktisk: Utviklere skal kunne beholde mer av arbeidsmåten og koden når de flytter fra én maskinvareplattform til en annen. Under panseret er forskjellene fremdeles reelle. DeepSeek dokumenterer for eksempel et annet format og en annen lagring av skaleringsfaktorer på Ascend enn på Nvidia. Verktøyet skjuler altså mye av maskinvarearbeidet, men det later ikke som brikkene er identiske.
Hvorfor er programvaren viktigere enn brikkeoverskriften?
En AI-chip uten gode biblioteker og utviklerverktøy er litt som en kraftig motor levert i en trekasse. Potensialet finnes, men noen må fremdeles bygge girkasse, instrumenter og resten av bilen. Nvidia har brukt mange år på å gjøre CUDA til standardveien fra modellkode til maskinvare. Derfor blir Nvidia hengende igjen i datasenteret selv når en konkurrent kan vise til sterke enkeltmålinger.
DeepSeek trekker fram TileLang som et høynivåspråk som skal gjøre AI-kjerner enklere å skrive uten å gi opp tilgang til maskinvarens ytelse. I praksis handler dette om å slippe at hver utvikler må håndtere alle detaljer i minneoppsett, justering, adressering og lavnivåparametere. DeepGEMM Ascend bruker i tillegg DeepJIT til kompilering mens programmet kjører og CANN 9.20 som en del av verktøykjeden.
Dette er en viktigere strategi enn å kopiere CUDA kommando for kommando. Hvis DeepSeek kan gi utviklerne samme arbeidsflyt på tvers av plattformer, blir kostnaden ved å prøve Ascend lavere. Og når koden ligger åpent med MIT-lisens, kan andre undersøke, forbedre og bygge videre på den i stedet for å vente på en lukket leverandør.
DeepSeek gjør dessuten dette med egne modellarkitekturer som arbeidslast. Biblioteket inneholder kjerner for blant annet grupperte matriseoperasjoner i MoE-modeller og MQA-beregninger. Det betyr at dette ikke bare er et generelt kompatibilitetsprosjekt. Verktøyene formes rundt de flaskehalsene DeepSeek faktisk møter når selskapets egne modeller skal kjøres.
Hva viser de første målingene på Ascend 950?
DeepSeek oppgir at de tette matriseoperasjonene i DeepGEMM Ascend når opptil 99,8 prosent av den teoretiske maskinvaregrensen i de publiserte testene. Målingene er gjort på Ascend 950DT med CANN 9.20 og omfatter både trenings- og inferensformer hentet fra DeepSeek-modellene. Det er et sterkt teknisk resultat dersom andre klarer å gjenskape det.
Men «99,8 prosent av maskinvaregrensen» betyr ikke at en hel AI-modell trener 99,8 prosent så raskt som på Nvidia. Målingen gjelder bestemte kjerner og matriseformer. En full treningsjobb må også flytte data mellom minne og brikker, synkronisere tusenvis av prosessorer, lagre kontrollpunkter og tåle at maskinvare feiler underveis. Den tregeste eller minst stabile delen kan spise opp gevinsten fra en svært effektiv enkeltoperasjon.
Det er nettopp derfor supernoden med 128 brikker betyr noe. DeepSeek og Huawei sier de har arbeidet med både beregning og kommunikasjon i denne løsningen. De prøver med andre ord å løse mer enn ytelsen inne i én brikke. Likevel er 128 brikker en annen verden enn klyngene som brukes til de største treningsløpene. Dette er et lovende mellomsteg, ikke dokumentasjon på at hele Nvidia-stakken er erstattet.
Huawei har selv sagt at Ascend 950DT er rettet mot dekoding og trening, og at flere kinesiske AI-utviklere ventes å ta slike treningssystemer i bruk i 2027. Samtidig har selskapet erkjent at produksjonskapasiteten ikke dekker etterspørselen, ifølge gjennomgangen av Huaweis nye Ascend-plan. Programvaren kan altså bli klar før nok maskinvare finnes.

Er DeepSeek nå uavhengig av Nvidia?
Nei. DeepSeek har vist en seriøs vei mot mindre Nvidia-avhengighet, men ikke full uavhengighet. Verktøyene må brukes av flere enn DeepSeek, holde seg stabile gjennom lange treningsløp og fungere når klyngene vokser fra 128 til mange tusen brikker. I tillegg må Huawei levere nok Ascend 950-brikker med jevn kvalitet.
Historikken gir god grunn til å holde igjen jubelen. DeepSeek V3 ble trent på 2 048 Nvidia H800-GPU-er. Nyere V4-modeller har fått støtte for Ascend, og Huawei har bekreftet kompatibilitet mellom Ascend-systemene og DeepSeek V4. Å kjøre en ferdig modell er likevel ikke det samme som å gjennomføre et stort, stabilt treningsløp fra start til slutt.
Det er også verdt å skille mellom DeepSeeks egen vei ut og hva vanlige brukere får. De nye Ascend-bibliotekene fjerner ikke Nvidia-støtten fra DeepSeek-økosystemet. Selskapet bygger en alternativ produksjonslinje for seg selv og et ekstra mål for utviklere som har tilgang til Ascend.
Jeg er skeptisk til kinesiske modellpåstander før kode, uavhengige tester og praktisk drift peker samme vei. Her finnes i det minste kode. Det gjør saken mer håndfast enn en scene med store søylediagrammer. Men målingene i prosjektet kommer fortsatt fra utviklerne, og en avhengighet er ikke borte bare fordi det finnes et repository som viser hvordan den kan reduseres.
Hva betyr dette for Nvidia og resten av AI-markedet?
Nvidia mister neppe en dominerende posisjon over natten. CUDA har et enormt forsprang i dokumentasjon, biblioteker, kompetanse og produksjonserfaring. Men DeepSeek viser hvordan en konkurrent kan begynne å gnage på dette forspranget: åpne de viktigste kjernene, behold kjente API-er og optimaliser hele veien fra modellarkitektur til forbindelsen mellom brikkene.
Eksportkontrollen har samtidig fått en ganske forutsigbar bivirkning. Når kinesiske selskaper får dårligere tilgang til de beste Nvidia-brikkene, forsvinner ikke behovet for datakraft. Pengene og ingeniørtimene går i stedet til en konkurrerende chip- og programvarestakk. Staten er sjelden særlig elegant når den prøver å fryse teknologisk utvikling. Her kan presset ha gjort Huaweis svakeste lag til et nasjonalt hasteprosjekt.
For utviklere og bedrifter er rådet mitt enkelt: Følg programvarestøtten, ikke bare spesifikasjonene. Se om bibliotekene støtter modellene og presisjonsformatene du faktisk bruker. Krev målinger på hele arbeidslasten, ikke bare én rask kjerne. Og ikke bytt en moden plattform før driftsverktøy, feilsøking, kapasitet og leveranser er dokumentert.
Det samme gjelder portabilitet. Et bibliotek kan tilby samme API og likevel kreve egne byggeverktøy, drivere og optimaliseringer på hver plattform. DeepGEMM Ascend krever blant annet en Ascend-prosessor, CANN 9.20, Torch NPU og Python 3.10 eller nyere. Det er overkommelig for et team som allerede har Huawei-maskinvare, men det er ikke en bryter en vanlig Nvidia-kunde bare slår på fredag ettermiddag.
Det kan likevel være smart å unngå nye løsninger som låser all modellkode til én leverandør uten god grunn. DeepSeek har nå vist at API-kompatible, åpne kjerner kan gjøre det enklere å flytte arbeid til en annen type akselerator. Lesere som vil følge modellutviklingen videre, kan se min tidligere gjennomgang av DeepSeek V4 Pro og de åpne vektene, og forklaringen av hva DeepSeek er og hvorfor selskapet skiller seg ut.
Dette er derfor ikke dagen Nvidia ble erstattet. Det er dagen DeepSeek viste fram flere av verktøyene som må finnes før en erstatning i det hele tatt er mulig. Hvis Ascend-systemene tåler full trening i stor skala i 2027, blir dette en viktig milepæl. Hvis ikke, har Nvidia fremdeles det konkurrentene sliter mest med å kopiere: en hel plattform som bare virker.
Ofte stilte spørsmål
Kan DeepSeek-modeller fortsatt kjøres på Nvidia-GPU-er?
Ja. De nye Ascend-verktøyene gir DeepSeek og andre utviklere et ekstra maskinvarevalg, men de fjerner ikke støtten for Nvidia. Tilgjengeligheten avhenger av den konkrete modellen og kjøremiljøet, så sjekk dokumentasjonen for versjonen du skal bruke.
Er Huawei Ascend 950 raskere enn Nvidia?
Det kan ikke slås fast generelt ut fra disse målingene. DeepSeek rapporterer svært høy utnyttelse på bestemte beregningskjerner, men en full modelljobb avhenger også av minne, kommunikasjon, programvare, stabilitet og størrelsen på klyngen. Sammenlign hele arbeidslasten.
Hva er forskjellen på CUDA og CANN?
CUDA er Nvidias programvareplattform for GPU-beregning. CANN er Huaweis verktøykjede for Ascend-prosessorer. Begge kobler modellprogramvare til maskinvaren, men har ulike kompilatorer, biblioteker, dataformater og utviklerøkosystemer.
Betyr åpen kildekode at Ascend er lett å ta i bruk?
Ikke nødvendigvis. Åpne biblioteker gjør det enklere å undersøke og tilpasse koden, men du trenger fortsatt Ascend-maskinvare, CANN-verktøy, kompatible rammeverk og kompetanse på plattformen. Produksjonskapasitet og moden feilsøking betyr minst like mye som lisensen.