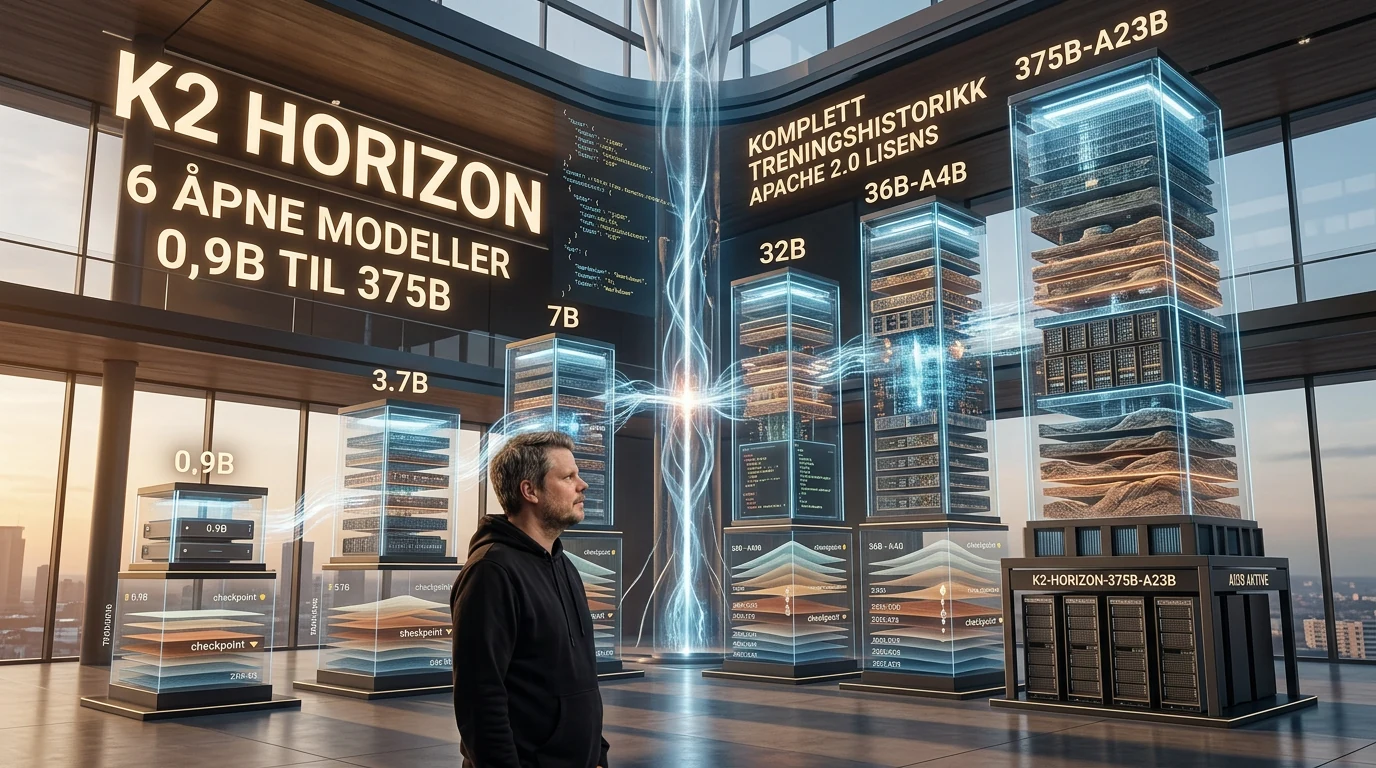
AI-Modeller
K2 Horizon samler seks åpne AI-modeller fra 0,9B til 375B
K2 Horizon samler seks åpne AI-modeller med Apache 2.0-lisens. Se størrelser, MoVA-arkitektur, maskinvarekrav og haken ved benchmarkene før du velger.
Utforsk arkivet
Her tester og vurderer jeg AI-modellene som faktisk betyr noe. Fra Claude og GPT til Gemini, Llama og lokale modeller du kan kjøre på din egen maskin. Ingen PR-prat – bare ærlige erfaringer fra en som bruker disse verktøyene hver eneste dag. Hva funker, hva funker ikke, og hva er bare hype?
K2 Horizon samler seks åpne AI-modeller med Apache 2.0-lisens. Se størrelser, MoVA-arkitektur, maskinvarekrav og haken ved benchmarkene før du velger.
WeatherNext 3 lager nye globale værprognoser hver time, med opptil 5 kilometers oppløsning og bedre nedbørsvarsler i Google Search, Maps og Gemini.
GPT-6 Astra bruker PC-er raskere og mer presist enn før. OpenAI snakker om AGI, men virkelige agentoppgaver blir den avgjørende testen.
Muse Spark 1.3 gjør Meta til en reell frontier-utfordrer med mer effektive AI-agenter og en Contributor-pris som kutter tokenkostnaden med over 90 prosent.
Gemini 3.8 Flash har samme tokenpris som 3.7 Flash, men kan bruke flere resonneringstoken. Dette betyr det for agenter, API-kostnad og modellvalg i praksis.
Muse Voice Transcribe samler transkripsjon, talermerking og endpointing i én sanntidsmodell. Se faktisk pris, fart, språkstøtte og hvorfor API-only er haken.
Claude Fable 5.1 får 75 prosent billigere cache-lesing. Anthropic anslår opptil 45 prosent lavere kostnad for lange, konteksttunge AI-agentjobber i praksis.
H3 Max lager fem sekunder AI-video på rundt tre sekunder. H3 Max Live viser hvorfor raskere enn sanntid kan endre video, spill og direktesendinger.
DeepSeek V4 Flash Vision har fått nedlastbare vekter og MIT-lisens på Hugging Face. Checkpointet er 167,8 GB, så dette er et svært tungt fler-GPU-prosjekt.
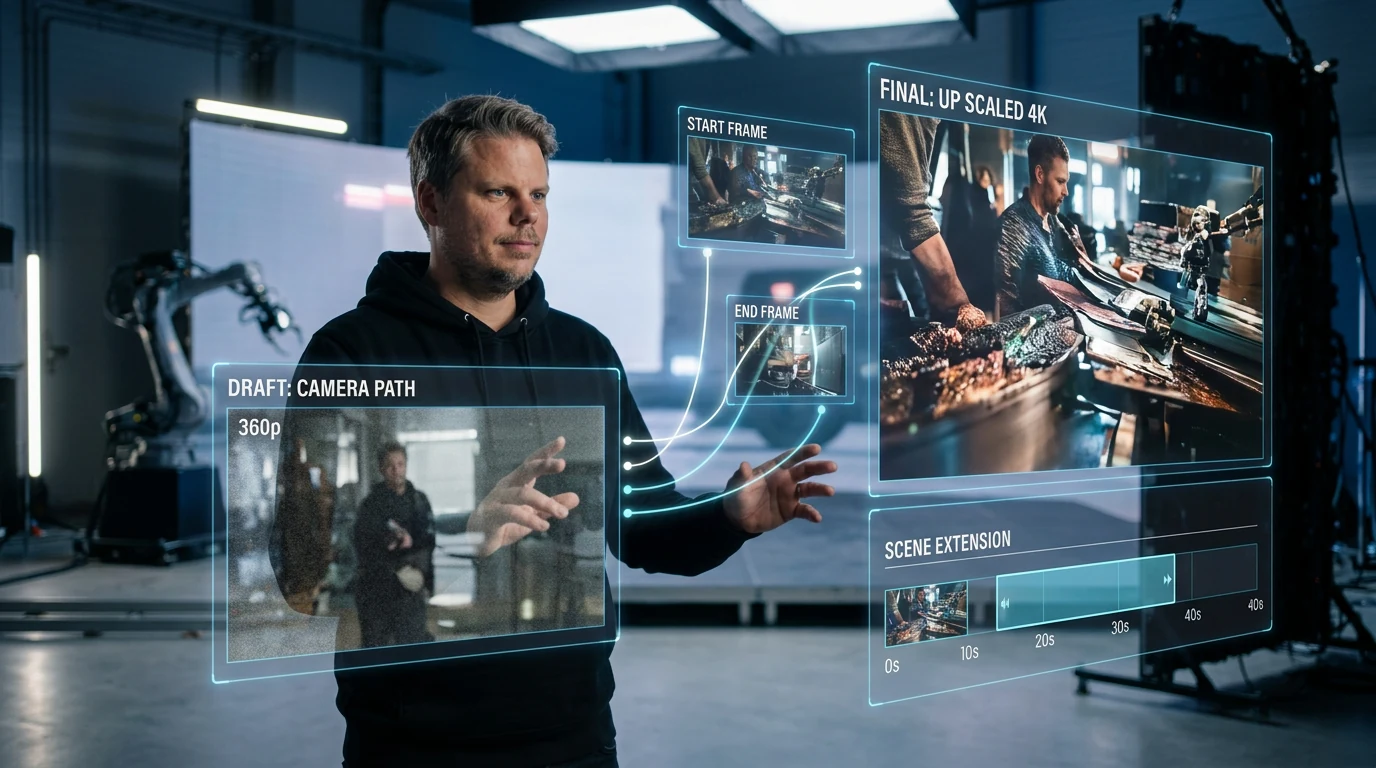
Gemini Omni 1.1 Flash gir bedre kontroll på AI-video med 360p-utkast, sceneforlengelse og 4K, men har en viktig EØS-begrensning.
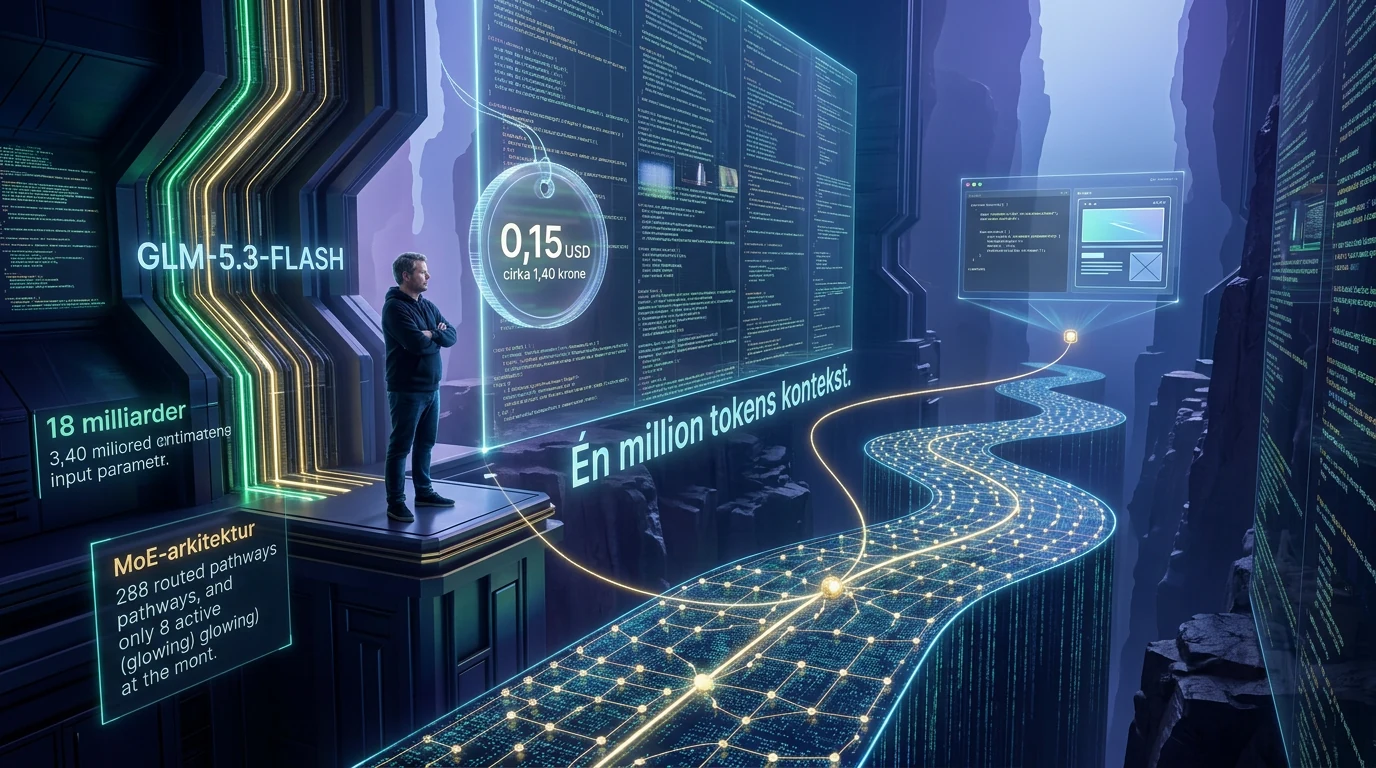
GLM-5.3-Flash gir én million tokens, multimodal agentbruk og åpne vekter til lav API-pris. Se hva modellen koster, krever og egner seg til i praksis…
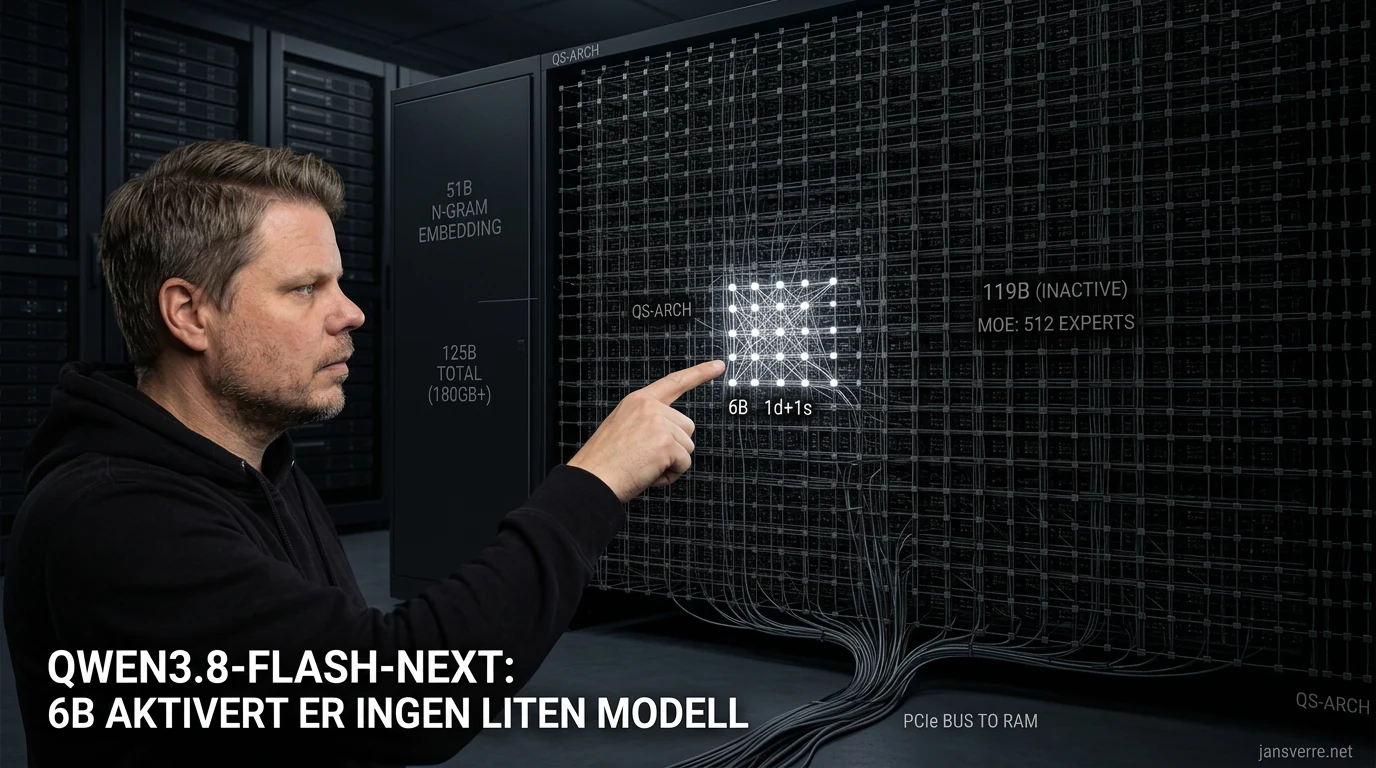
Qwen3.8-Flash-Next gir en åpen forhåndsvisning av Qwen4-arkitekturen. Her er hva 6B aktive parametere, QSA og 262 144 token betyr for lokal kjøring i praksis.
Ox Alpha fra Z.AI får åpne modellvekter. Se hva som er bekreftet om lokal kjøring, databruk, GLM-5.3 og påstanden om at modellen faktisk utfordrer…
IBM Granite 4.2 har 3B-, 8B- og 30B-modeller for lokale AI-agenter, med justerbar reasoning og agenttrening. Se hvorfor 8B er det naturlige startpunktet.