Innhold Vis
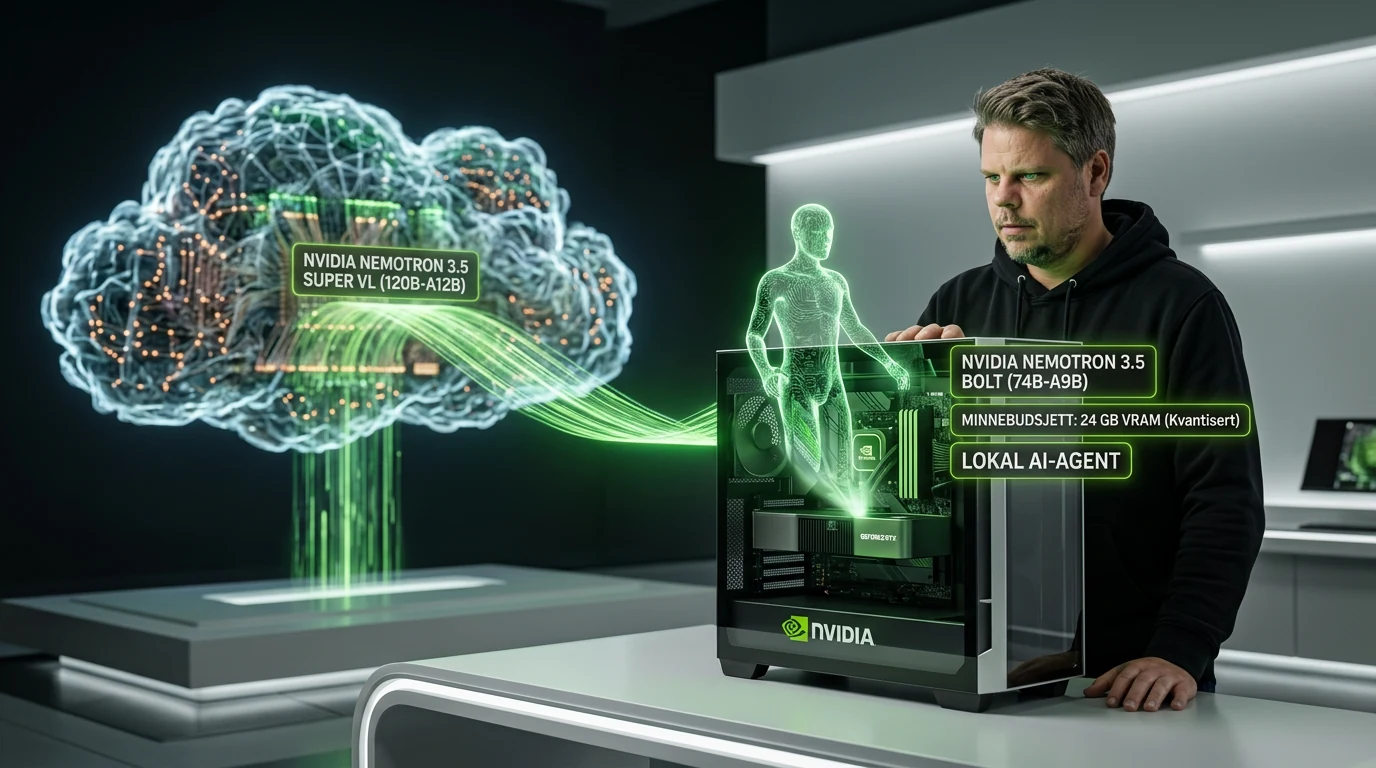
Nvidia Nemotron 3.5 gir bedrifter og utviklere åpne modeller for AI-agenter som kan kjøre på egen infrastruktur, helt fra datasenteret til en lokal PC. Familien består av den store multimodale Super VL-modellen og to lettere Bolt-varianter. Den mest håndfaste PC-nyheten er Nemotron 3.5 Bolt 74B-A9B, som er komprimert og kvantisert for et minnebudsjett på 24 GB.
Det gjør ikke en avansert lokal agent til et ferdig program du installerer med to klikk. Du trenger fortsatt et agentrammeverk, verktøy, tilgangskontroll og maskinvare som passer. Men modellene gjør selve motoren mulig å laste ned, tilpasse og kjøre uten at dokumenter, kode og andre arbeidsdata må sendes til et eksternt modell-API.
For mindre bedrifter er dette en langt mer interessant utvikling enn enda en modell som krever et helt rack med GPU-er. Samtidig bør tallene leses med begge øynene åpne: De imponerende sammenligningene kommer foreløpig hovedsakelig fra Nvidia selv. Lanseringen er reell og modellfilene finnes, men produksjonskvalitet må måles på den konkrete jobben modellen skal gjøre.
Hva har Nvidia lansert?
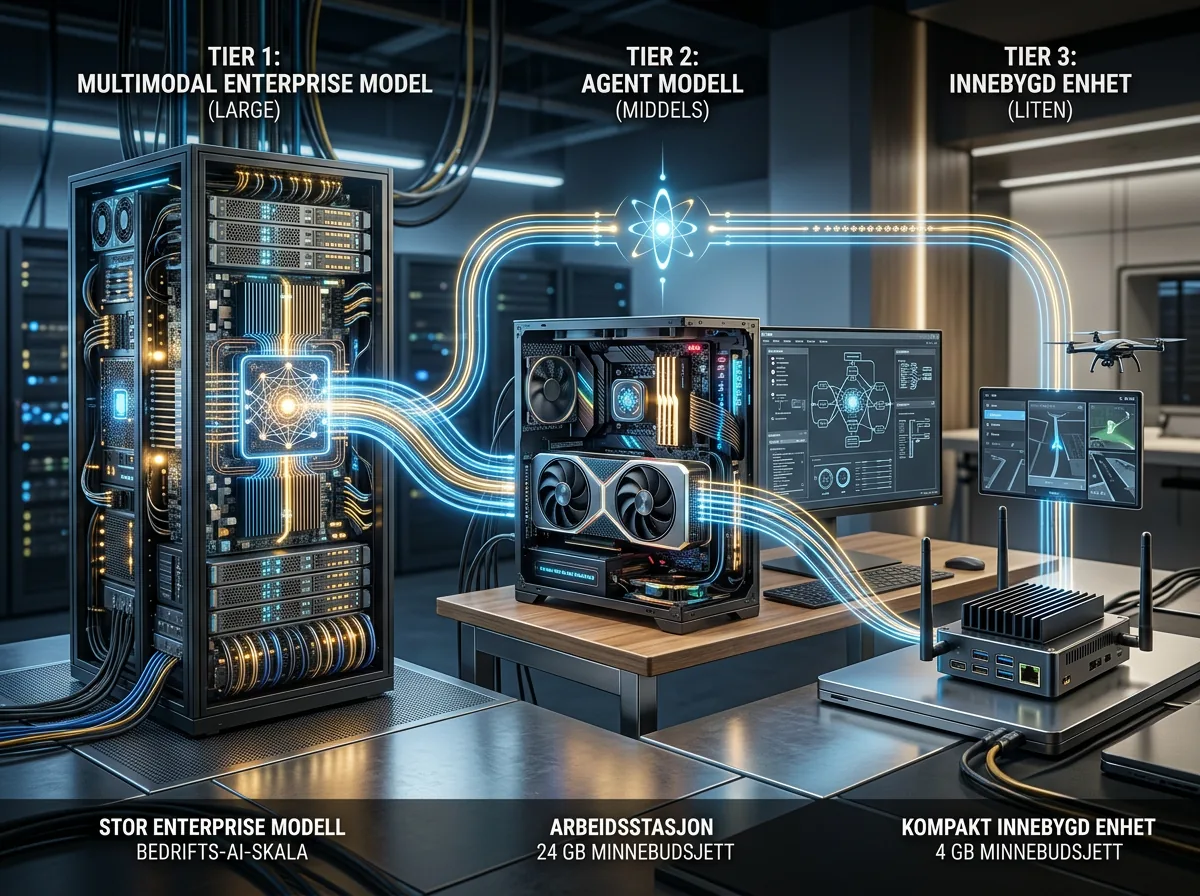
Nvidia har lansert tre åpne Nemotron 3.5-modeller for ulike nivåer av agentarbeid. Nvidias lanseringsmelding fra 15. oktober 2026 beskriver Super VL med 120 milliarder parametere, Bolt 74B-A9B med et minnebudsjett på 24 GB og Bolt E4B med et minnebudsjett på 4 GB.
Nemotron 3.5 Super VL er den store bedriftsmodellen. Den kombinerer tekst og bilde, kan lese blant annet nettsider, PDF-er, tabeller og diagrammer, og er rettet mot langvarige arbeidsflyter der en agent må følge instruksjoner og bruke verktøy over mange steg. Modellen har 120 milliarder parametere totalt, men aktiverer 12 milliarder av dem for hvert token gjennom en Mixture-of-Experts-arkitektur.
Bolt 74B-A9B er PC- og arbeidsstasjonsvarianten. Navnet betyr 74 milliarder parametere totalt og rundt 9 milliarder aktive parametere. Den er laget for lokale oppgaver som nettsøk, koding, feilsøking og arbeid gjennom et agentrammeverk. Den minste modellen, Bolt E4B, er rettet mot raske samtaleagenter, innebygde systemer og fysiske agenter på GeForce RTX, Jetson og RTX/DGX Spark.
Super VL og Bolt 74B-A9B er tilgjengelige nå. Bolt E4B skal etter planen bli tilgjengelig 23. oktober 2026. Det er derfor for tidlig å behandle 4 GB-modellen som noe utviklere allerede har rukket å prøve skikkelig.
Hvorfor er Bolt-modellen interessant for lokal AI?
Nemotron 3.5 Bolt 74B-A9B er interessant fordi Nvidia har designet den rundt en konkret grense: Modellen skal få plass innenfor 24 GB minne og fortsatt kunne kjøre ved siden av andre programmer. Den tekniske oversikten for Bolt beskriver hvordan modellen er komprimert fra Super VL, redusert fra 120B-A12B til 74B-A9B og deretter kvantisert svært hardt.
De fleste ekspertvektene er lagret med litt over 2 bits per verdi. Andre deler bruker NVFP4 eller Q8_0. Dette er ikke bare en tilfeldig GGUF-fil noen har laget etter lansering. Kvantiseringen og den videre treningen er en del av selve modellarbeidet, med mål om å hente tilbake mest mulig av kvaliteten som vanligvis forsvinner når en stor modell presses så langt ned.
Nvidia oppgir 83,99 tokens i sekundet i sin kodetest med llama.cpp og spekulativ dekoding på en Surface Laptop Ultra med RTX Spark og 128 GB samlet minne. Samme test viser at enkelte sammenlignbare modeller produserer tokens raskere, mens Nvidia hevder Bolt gir en bedre kombinasjon av fart og agentkvalitet. Det er en viktig forskjell. Rask tekst er ikke det samme som at en agent fullfører en oppgave riktig.
Testmiljøet betyr også noe. At modellfilen er laget for 24 GB, er ikke et løfte om samme fart eller problemfri kjøring på ethvert grafikkort med 24 GB VRAM. Nvidia har optimalisert den kvantiserte utgaven for RTX Spark med llama.cpp og DGX Spark med vLLM. Selskapet oppgir også støtte for GeForce RTX-PC-er, men faktisk hastighet vil avhenge av maskinen, kjøremiljøet, kontekstlengden og resten av agentstakken.
Hva kan Super VL gjøre i en bedrift?
Nemotron 3.5 Super VL er laget for spesialiserte agenter som behandler store mengder interne dokumenter og bruker bedriftens egne verktøy. Modellen kan post-trenes på egne data, kjøres på egen infrastruktur og kombinerer tekst- og bildeforståelse i samme arbeidsflyt. Det er nyttig når en agent må hente informasjon fra en PDF, tolke en tabell og deretter utføre en kontroll i et annet system.
Nvidia trekker fram eksempler innen økonomi, forsikring, sikkerhet, forskning og programvareutvikling. Selskaper som CrowdStrike, Perplexity, Ramp og Salesforce skal være blant dem som tilpasser eller integrerer modellen. Det viser at dette er mer enn en modellfil for entusiaster, men det er ikke uavhengig dokumentasjon på at alle arbeidsflytene fungerer bedre enn med lukkede modeller.
Selskapets store ytelsespåstand er at Super VL kan levere opptil fem ganger høyere gjennomstrømning enn nærmeste modell i samme klasse, samtidig som den skal ligge nær langt større modeller på bestemte agentoppgaver. Formuleringen «opptil» og utvalget av tester gjør at jeg ikke ville tatt kjøpsbeslutninger på søylediagrammet alene. Be om målinger på egne dokumenter, egne verktøy og den faktiske køen av oppgaver.
Det mest solide argumentet er kontrollen. Modellen leveres med åpne vekter, datasett og treningsoppskrifter, og Nvidia sier den ble trent på omtrent 26 billioner tokens før post-trening med rundt 3,8 millioner eksempler. En bedrift kan dermed tilpasse modellen og holde behandlingen i et miljø den selv styrer, i stedet for å være helt avhengig av funksjoner og vilkår hos én API-leverandør.
Betyr lokal kjøring at dataene er trygge?
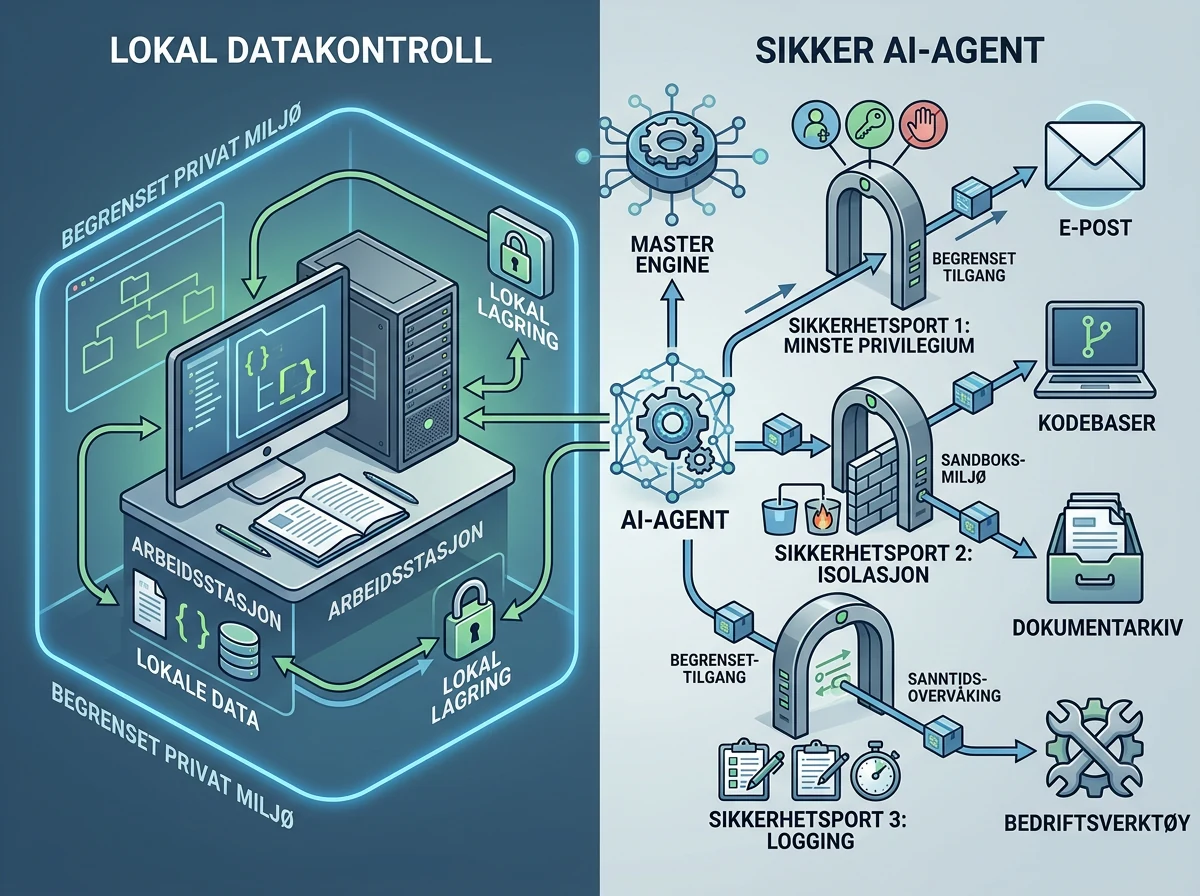
Nei. Lokal kjøring gir kontroll over hvor dataene sendes, men gjør ikke en AI-agent sikker av seg selv. En agent som kan lese e-post, åpne dokumenter, kjøre kode og bruke bedriftsverktøy, trenger stramme tillatelser, isolasjon, logging og kontroll med hvilke handlinger den får utføre.
Det gjelder spesielt for en modell som skal være «alltid på». Jo lenger agenten arbeider og jo flere systemer den når, desto større blir konsekvensen av en dårlig instruksjon, et manipulert dokument eller feil bruk av et verktøy. Modellkvalitet og systemsikkerhet er to forskjellige problemer.
Nvidia bygger derfor mer enn bare modeller. AI-Q viste tidligere hvordan Nvidia bygger åpne agentarbeidsflyter, og jeg har skrevet om hvordan Nvidia OpenShell setter tekniske grenser for AI-agenter. Det er et viktig tillegg til denne lanseringen: En åpen lokal modell gir mer kontroll over dataene, mens kjøremiljøet må begrense hva agenten faktisk får lov til å gjøre.
Bedrifter må også kontrollere lisensvilkår, modellkort og hvilke deler av treningsgrunnlaget som faktisk er åpne. «Åpen modell» brukes bredere enn tradisjonell åpen kildekode. Tilgjengelige vekter gjør modellen mulig å kjøre og tilpasse, men sier ikke automatisk at hver datakilde eller hver del av treningsprosessen kan etterprøves fullt ut.
Hva betyr lanseringen for mindre bedrifter?
For en mindre bedrift er Bolt 74B-A9B den mest relevante delen av lanseringen. Et minnebudsjett på 24 GB gjør lokal agentkjøring mulig på en helt annen type maskinvare enn Super VL. Modellen kan lastes ned fra Hugging Face og har støtte for blant annet llama.cpp, Ollama, LM Studio, Unsloth og vLLM.
Det betyr likevel ikke at lokal drift automatisk er billigst. En skyløsning kan være fornuftig for sporadisk bruk fordi leverandøren tar seg av oppdateringer, kapasitet og drift. Lokal kjøring blir mer interessant når arbeidsmengden er jevn, dataene er følsomme, responstiden må være lav eller bedriften trenger en spesialtilpasset modell som ikke bør ligge bak et eksternt API.
Den praktiske startrekkefølgen bør være enkel. Velg én avgrenset jobb med tydelig fasit, for eksempel å hente bestemte felt fra dokumenter eller kontrollere kode etter en fast sjekkliste. Mål kvalitet, tidsbruk og feilrate. Gi deretter agenten minst mulig tilgang til systemene rundt. Først når dette virker stabilt, er det fornuftig å utvide oppgaven.
Ikke velg modell ut fra total parameterstørrelse alene. Bolt bruker bare rundt 9 milliarder aktive parametere per token, er hardt kvantisert og er spesialtrent for lokale agentoppgaver. Det kan gjøre den bedre egnet til én praktisk jobb enn en større generell modell, men den kan også tape på språk, kunnskap eller krevende resonnering utenfor det Nvidia har optimalisert for.
Er dette en ny retning for Nvidia?
Nei, men retningen blir stadig tydeligere. Den store satsingen på egne open-weight-modeller viste hvor Nvidia er på vei. Selskapet vil ikke bare selge GPU-ene som andre bygger AI på, men også levere modellene, treningsverktøyene, kjøremiljøet og sikkerhetslaget rundt agentene.
Det så vi med NemoClaw og Nvidias agentplattform. Nemotron 3.5 fyller inn selve modellaget med varianter for ulike maskiner. Super VL dekker de store, spesialiserte arbeidsflytene, mens Bolt gjør lokale agenter til en realistisk arbeidslast på PC-er og arbeidsstasjoner.
Det er både praktisk og strategisk. Når en modell er optimalisert for Nvidia-maskinvare og pakket inn i Nvidia-verktøy, får kundene en enklere vei fra prøveprosjekt til drift. Samtidig vokser avhengigheten av Nvidias samlede plattform, selv om modellvektene er åpne. Det er en viktig del av AI-kampen mellom Nvidia og OpenAI: Åpne modeller gir valgfrihet, men optimal ytelse kan fortsatt trekke deg mot én maskinvareleverandør.
Min foreløpige dom er derfor positiv, men enkel: Dette er en nyttig modellrelease fordi Nvidia har laget reelle valg for ulike maskiner, ikke bare én enorm modell og et pent diagram. Bolt 74B-A9B er den jeg ville fulgt tettest. Hvis uavhengige tester bekrefter at den holder kvaliteten i faktiske agentoppgaver innenfor 24 GB, kan den bli et svært praktisk alternativ for lokal AI. Inntil da er den lovende, tilgjengelig og absolutt verdt å måle – men ikke ferdig bevist av Nvidias egne tall.
Ofte stilte spørsmål
Kan Nemotron 3.5 Bolt kjøre uten internett?
Ja, modellvektene kan lastes ned og kjøres lokalt uten at selve modellbehandlingen går gjennom en skytjeneste. Agenten kan likevel trenge internett hvis oppgaven bruker nettsøk eller eksterne verktøy. Lokal modell og helt frakoblet arbeidsflyt er derfor ikke alltid det samme.
Trenger jeg 24 GB VRAM for Nemotron 3.5 Bolt?
Den kvantiserte Bolt 74B-A9B-utgaven er laget for et minnebudsjett på 24 GB. Nvidia har testet den på RTX Spark med 128 GB samlet minne, så 24 GB-modellstørrelse alene garanterer ikke samme fart på alle GPU-er. Kontroller støtte og ytelse på maskinen du skal bruke.
Er Nemotron 3.5-modellene gratis å bruke kommersielt?
Modellfilene er åpne og kan lastes ned, men kommersiell bruk må vurderes mot lisensen for den konkrete modellen og eventuelle verktøy rundt den. Les alltid modellkortet og lisensvilkårene før modellen brukes med kundedata eller bygges inn i et produkt.
Hva er forskjellen på Super VL og Bolt?
Super VL er en 120B-A12B multimodal modell for store, spesialiserte arbeidsflyter i bedrifter. Bolt 74B-A9B er komprimert og kvantisert for lokale agentoppgaver innenfor 24 GB, mens Bolt E4B er en mindre 4 GB-modell for raske samtaleagenter og innebygde systemer.