Innhold Vis
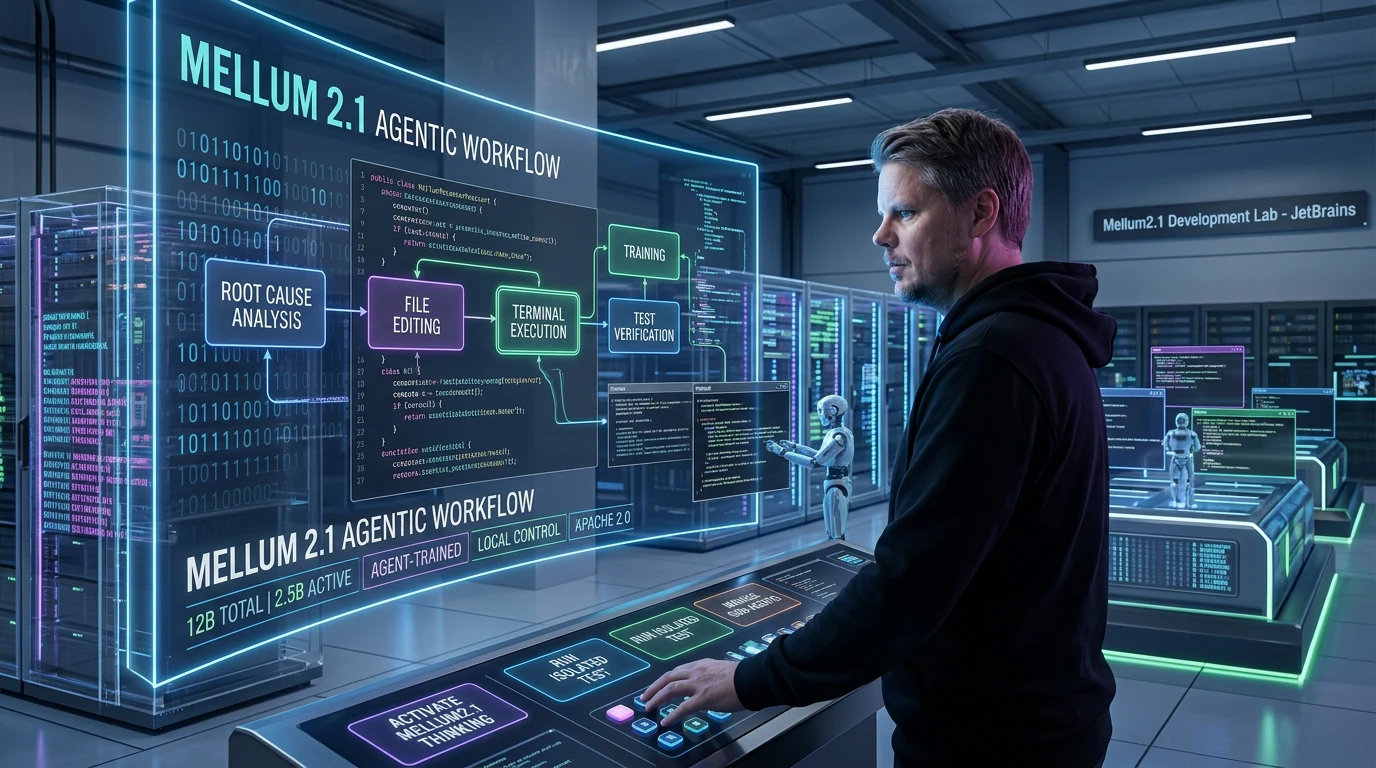
Hvis du bygger kodeagenter, er Mellum2.1 interessant av én grunn: JetBrains har trent en rask, åpen modell på faktisk arbeid i kodebaser, ikke bare pene svar om programmering. Under treningen fikk modellen bruke terminal, filverktøy og tester. Ifølge JetBrains kan den dermed lete etter årsaken til en feil, redigere filer og kontrollere sitt eget arbeid.
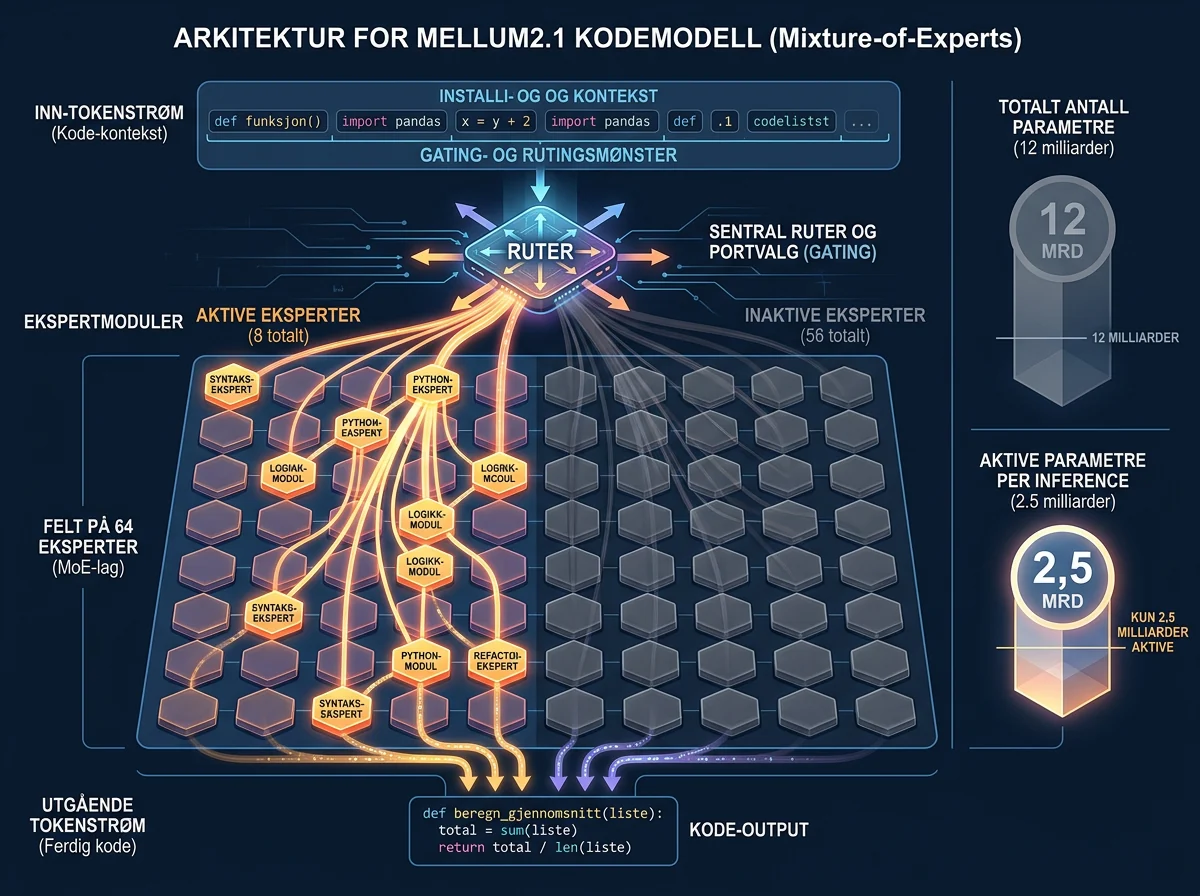
Modellen har 12 milliarder parametre totalt, men aktiverer bare 2,5 milliarder for hvert token. Den er utgitt med Apache 2.0-lisens og har 131 072 tokens kontekstvindu. Det gjør Mellum2.1 særlig aktuell som lokal underagent i et større system, der fart, kontroll over kildekoden og mange små modellkall kan være viktigere enn å sende alt til den største modellen som finnes.
Jeg liker retningen. Kodeagenter trenger ikke bare en modell som kan snakke pent om programmering. De trenger en modell som kan orientere seg i en mappe, bruke verktøy, gjøre en endring og faktisk kjøre testen etterpå. Samtidig er dette ikke en grunn til å overlate produksjonsmiljøet til Mellum2.1 på dag én. Resultatene er JetBrains’ egne, og den virkelige prøven er om modellen løser dine oppgaver uten at du må rydde opp etter den.
Hva er Mellum2.1?
Mellum2.1 er JetBrains’ åpne mixture-of-experts-modell for koding, resonnering og verktøybruk. Den består av 64 eksperter og aktiverer åtte av dem per token. Ifølge det offisielle modellkortet for Mellum2.1 Thinking har den 28 lag, 12 milliarder parametre totalt og 2,5 milliarder aktive parametre.
MoE-oppsettet betyr at hele modellen ikke regner på hvert eneste token. En ruter velger et mindre sett med eksperter som skal gjøre jobben. Det gir mer samlet kapasitet enn en tett modell med 2,5 milliarder parametre, uten at alle 12 milliardene må aktiveres for hver bit tekst modellen produserer.
JetBrains tilbyr både en Instruct- og en Thinking-variant. Thinking-modellen er den mest aktuelle for kompliserte agentoppgaver, terminalbruk og arbeid i en kodebase. Apache 2.0-lisensen åpner samtidig for kommersiell bruk, endringer og lokal utrulling, så lenge lisensvilkårene følges. Det er en viktig forskjell fra en modell som bare kan prøves gjennom et lukket API.
Hvorfor er trening i ekte kodebaser viktig?
Mellum2.1 ble ettertrent med forsterkende læring i miljøer der modellen fikk tilgang til en kodebase, et shell og verktøy for å redigere filer. Belønningen var knyttet til om testene faktisk passerte. JetBrains beskriver millioner av isolerte kjøringer fordelt på tusenvis av miljøer gjennom treningen.
Det er mer relevant for en kodeagent enn enda en bunke pene svar på isolerte programmeringsoppgaver. I en ekte kodebase ligger problemet sjelden i én funksjon som er pent limt inn i en prompt. Agenten må finne riktig fil, forstå avhengigheter, tolke en feilmelding, gjøre en begrenset endring og kontrollere at den ikke knuste noe annet.
JetBrains sier at nesten alt arbeidet med versjon 2.1 ligger i ettertreningen. Selve arkitekturen er den samme som i Mellum2. Det er kanskje den mest interessante delen av lanseringen: Selskapet har ikke løst problemet ved å gjøre modellen enorm. Det har forsøkt å lære den arbeidsformen en agent faktisk trenger.
Hvor stort er spranget fra Mellum2?
JetBrains rapporterer at Mellum2.1 løser 47 prosent av SWE-bench Verified, mot 2 prosent for Mellum2 i samme evalueringsoppsett. På Terminal-Bench 2.1 øker resultatet fra 0,6 til 17,4 prosent, mens SWE-bench Pro går fra 0 til 28 prosent. Alle disse tallene er egenrapporterte av JetBrains.
Spranget er så stort at det fortjener oppmerksomhet, men ikke blind applaus. På SWE-bench Verified ligger Qwen3.5-9B fortsatt litt foran med 50 prosent i JetBrains’ tabell. På Terminal-Bench 2.1 og SWE-bench Pro er Qwen-modellen også sterkere. Mellum2.1 vinner altså ikke alt, og én resultatliste forteller ikke hvor stabil modellen blir i ditt repository.
Testoppsettet er likevel bedre dokumentert enn et løst tall i en lanseringspost. De agentiske testene brukte samme åpne Pi-harness, shell- og filverktøy, 114 000 tokens kontekst og opptil 16 000 tokens per runde. Det gjør sammenligningen mer nyttig, men den er fortsatt en kontrollert evaluering utført av modellprodusenten. Tallene bør være inngangen til en egen test, ikke slutten på vurderingen.
Hva betyr 2,5 milliarder aktive parametre i praksis?
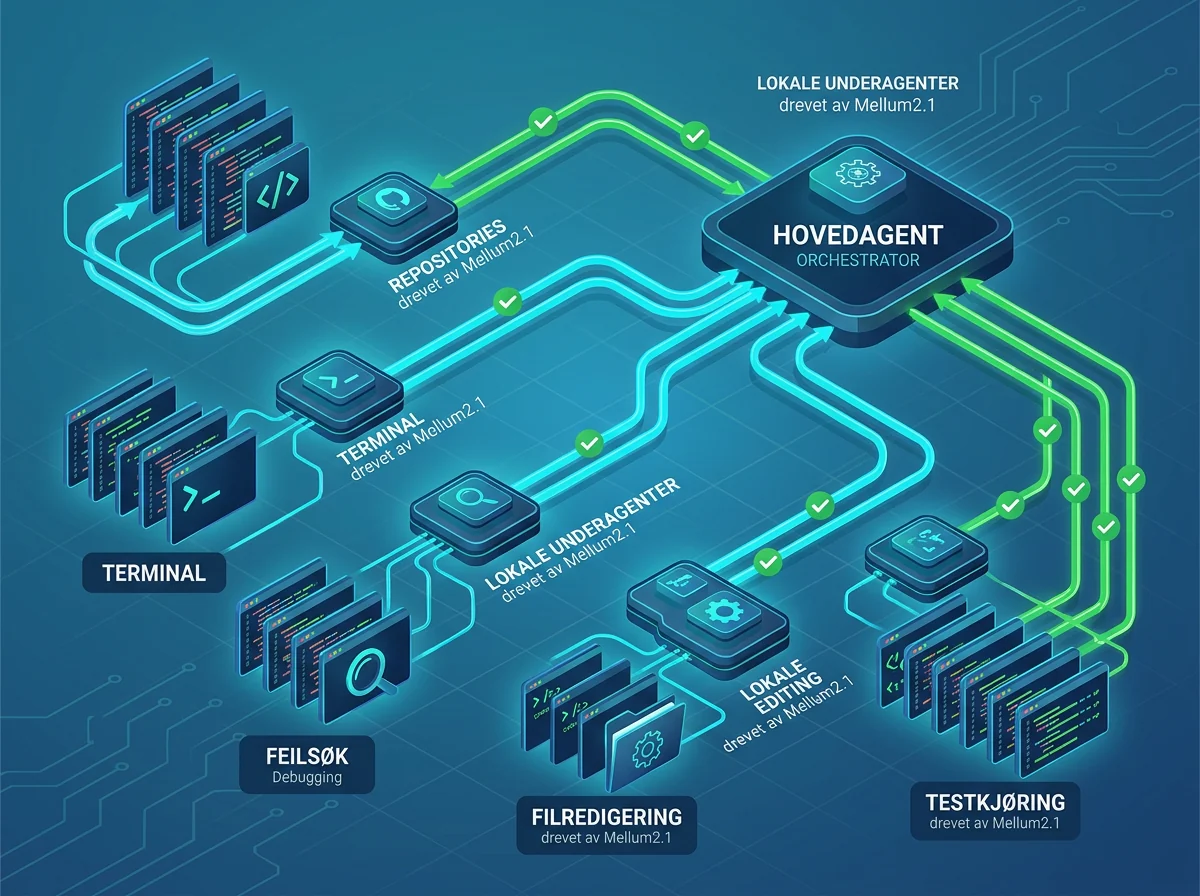
De 2,5 milliardene aktive parametrene er grunnen til at Mellum2.1 kan bli mer interessant som underagent enn som én stor altmuligmodell. Hver oppgave bruker bare en del av modellens 12 milliarder parametre. JetBrains måler nesten dobbelt så mange tokens per sekund som Qwen3.5-9B under høy belastning, og omtrent 1,6 ganger høyere fart for én forespørsel med multi-token prediction.
Det er produsentens måling på egen maskinvare og eget oppsett, så ikke les det som en garanti for din server. Poenget er heller hvilken rolle modellen er bygget for. I et agentsystem kan én hovedagent delegere søk, enkel feilanalyse, validering eller et avgrenset kodeinngrep til flere mindre arbeidere. Da blir gjennomstrømming og ventetid fort viktigere enn at hver arbeider er verdens sterkeste modell.
Det ligner argumentet bak IBM Granite 4.1 og mindre, effektive modeller: Du trenger ikke betale den høyeste beregningskostnaden for alle ledd i en arbeidsflyt. Mellum2.1 gjør denne tanken konkret for kodeagenter. En rask lokal modell kan ta de avgrensede jobbene, mens en større modell kobles inn når problemet faktisk krever det.
Kan Mellum2.1 kjøres lokalt?
Ja. Modellvektene ligger på Hugging Face, og JetBrains dokumenterer kjøring med både vLLM og SGLang. BF16-utgaven er oppført til 24,3 GB, så full presisjon krever en del videominne. Modellen har støtte for et kontekstvindu på 131 072 tokens, men maksimal kontekst øker minnebehovet betydelig.
For vLLM startes Thinking-varianten med modellnavnet JetBrains/Mellum2.1-12B-A2.5B-Thinking og --reasoning-parser qwen3. Skal den velge verktøy automatisk, legger JetBrains til --enable-auto-tool-choice og --tool-call-parser hermes. Dette er detaljene som må med. En modell kan være god på verktøybruk og likevel se fullstendig hjelpeløs ut hvis serveren tolker resonneringen eller verktøykallene feil.
JetBrains’ offisielle GGUF-repo er allerede publisert med fem utgaver. Q4_K_M-filen er 8,1 GB, mens den minste MXFP4_MOE-utgaven er 7,0 GB. Det gjør modellen langt enklere å prøve med llama.cpp, Ollama eller LM Studio, men faktisk minnebehov avhenger fortsatt av runtime, kontekst og cache. MTP-headen for spekulativ dekoding i vLLM er fremdeles varslet som kommende. Vil du forstå resten av landskapet rundt lokal kjøring, har jeg samlet grunnprinsippene i guiden om åpne AI-modeller i 2026.
Hva bør du bruke modellen til?
Mellum2.1 passer best til avgrensede agentoppgaver der lav ventetid og lokal kontroll betyr mye. Det kan være å finne årsaken til en mislykket test, foreslå en liten rettelse, sjekke en patch, velge verktøy eller hente ut relevant informasjon fra en kodebase. JetBrains framhever også matematikk, resonnering og generelle assistentoppgaver, men kodeagenter er den klare hovedsaken.
For bedrifter kan lokal kjøring være vel så viktig som resultatlistene. Kildekode, logger og interne feilbeskrivelser kan bli på egen infrastruktur. Apache 2.0 gjør det dessuten mulig å bygge kommersielle løsninger rundt modellen uten å være låst til JetBrains som API-leverandør.
Jeg ville ikke startet med å gi modellen hele repositoryet og beskjed om å ordne alt. Gi den en avgrenset oppgave, et isolert miljø og tester som avgjør om jobben er riktig utført. Mål hvor ofte den lykkes, hvor mange runder den bruker, hvor mye kontekst den spiser og hvor ofte et menneske må gripe inn. Det er de tallene som avgjør om en rask modell faktisk er billig.
Er Mellum2.1 et reelt alternativ til lukkede kodemodeller?
Mellum2.1 er et reelt alternativ for enkelte deler av agentarbeidet, men JetBrains har ikke dokumentert at den kan erstatte de sterkeste lukkede modellene som selvstendig hovedagent. Det er heller ikke nødvendig for at modellen skal være nyttig. En spesialisert arbeider som er rask, lokal og rimelig å kjøre kan skape mer verdi enn en svak kopi av en toppmodell.
Den samme modellen trenger ikke få hver eneste oppgave i et agentsystem. Åpne modeller som Mellum2.1 gjør det mulig å fordele arbeidet etter behov og beholde mer kontroll selv. Det er en sunn utvikling, særlig når kodebasen ikke bør sendes ut av huset.
Den store prøven kommer nå. Bygger du kodeagenter, bør du teste Mellum2.1 på ekte feil fra egne prosjekter og sammenligne med modellen du allerede bruker. Ikke spør bare om den produserer riktig patch. Sjekk om den finner riktig årsak, unngår unødvendige endringer, kjører de riktige testene og stopper når jobben er gjort. Hvis den klarer det stabilt, har JetBrains laget noe langt mer verdifullt enn enda en modell med et pent benchmarktall.
Ofte stilte spørsmål
Er Mellum2.1 gratis å bruke kommersielt?
Ja, Mellum2.1 er utgitt med Apache 2.0-lisens. Det åpner for kommersiell bruk, endring og distribusjon så lenge du følger lisenskravene, blant annet om merknader og attribusjon. Kontroller alltid lisensen for eventuelle finjusteringer eller kvantiserte tredjepartsutgaver separat.
Hvor mye videominne trenger Mellum2.1?
BF16-vektene er 24,3 GB, mens de offisielle GGUF-filene går ned til 8,1 GB for Q4_K_M og 7,0 GB for MXFP4_MOE. Praktisk RAM- og videominnebehov blir høyere enn selve filen og avhenger av runtime, kontekstlengde, cache og samtidige forespørsler.
Fungerer Mellum2.1 med verktøykall?
Ja. JetBrains dokumenterer automatisk valg av verktøy i vLLM med Hermes-parser, mens Thinking-modellen bruker Qwen3-parser for resonneringen. Modellen er trent i miljøer med shell og filredigering, men integrasjonen må fortsatt testes med verktøyene og agentharnessen du faktisk bruker.
Er Mellum2.1 bedre enn Qwen3.5-9B til koding?
Ikke entydig. I JetBrains’ egne agenttester ligger Qwen3.5-9B foran på SWE-bench Verified, Terminal-Bench 2.1 og SWE-bench Pro. Mellum2.1 framheves i stedet for høy gjennomstrømming, 2,5 milliarder aktive parametre og muligheten til å kjøre en åpen modell på egen infrastruktur.