Innhold Vis
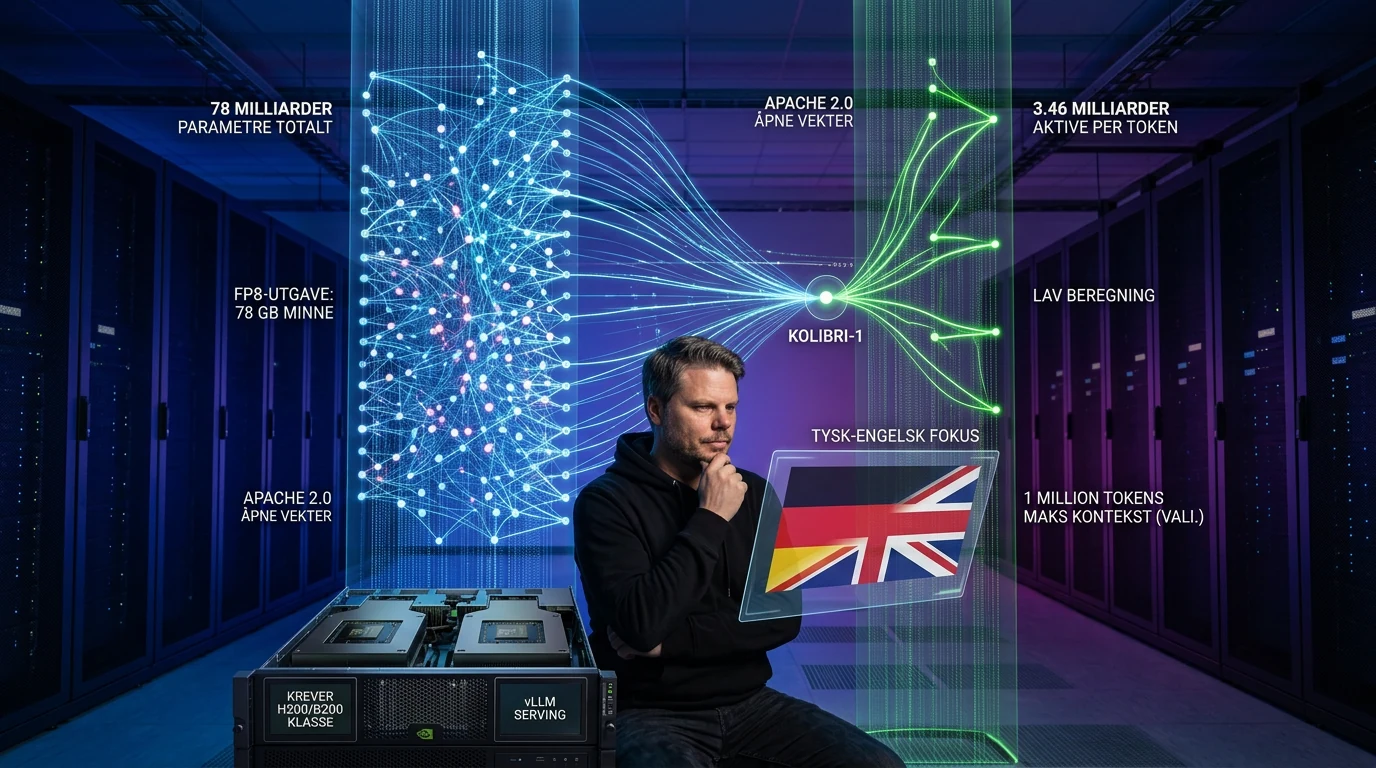
Kolibri-1 er en tysk-engelsk AI-modell med åpne vekter som rommer 78,1 milliarder parametre, men bare aktiverer 3,46 milliarder for hvert token. Det gir betydelig lavere beregning enn en tett modell i samme størrelsesklasse, uten at Aleph Alpha har måttet krympe hele kunnskapskapasiteten ned til en liten modell.
Aleph Alpha slapp modellen 3. oktober med Apache 2.0-lisens, verktøykall, valgbar reasoning og en maksimal kontekst på 1 048 576 tokens. Dette er en oppriktig spennende europeisk modellutgivelse, særlig for virksomheter som trenger tysk og engelsk, vil kjøre modellen i eget miljø og ikke ønsker å sende interne dokumenter gjennom en lukket skytjeneste.
Men «3,46 milliarder aktive» betyr ikke at Kolibri-1 oppfører seg som en liten modell med 3,46 milliarder parametre i minnet. FP8-utgaven er rundt 78 GB og krever minst én H200, B200 eller B300, eller to H100 SXM5. Dette er en effektiv servermodell med åpne vekter. Det er ikke en ny kosemodell for en vanlig laptop.
Hva er Kolibri-1?
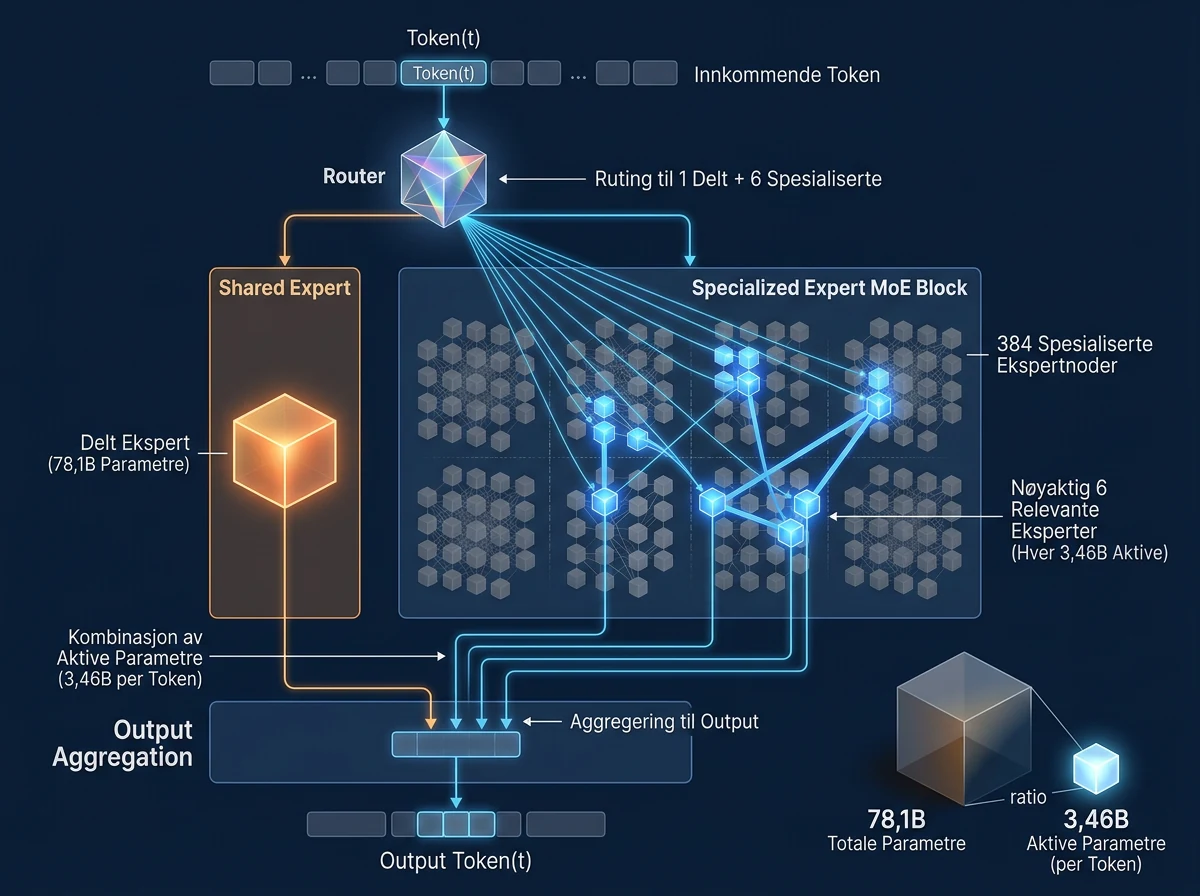
Kolibri-1 er en Mixture-of-Experts-modell fra tyske Aleph Alpha, utviklet for engelsk og tysk. Den offisielle FP8-modellen på Hugging Face oppgir nøyaktig 78 103 074 560 parametre totalt og 3 457 573 120 aktive parametre per token. Vektene er publisert under Apache 2.0.
En vanlig tett språkmodell bruker alle parametrene sine for hvert token. Kolibri-1 fordeler i stedet arbeidet mellom 384 eksperter og sender hvert token til seks av dem, i tillegg til én delt ekspert. Resultatet er at modellen kan ha mye samlet kapasitet uten å bruke hele nettverket på hvert eneste ord den leser eller skriver.
Det minner litt om å ha et stort fagmiljø tilgjengelig, men bare kalle inn de seks relevante spesialistene til hvert spørsmål. Du slipper at alle sitter i samme møte og nikker. MoE-arkitekturen reduserer beregningen, men alle ekspertene må fremdeles være lastet i minnet. Derfor er skillet mellom total og aktiv størrelse viktig.
Hvorfor er 3,46 milliarder aktive parametre viktig?
Den lave aktive parameterbruken gjør Kolibri-1 mer effektiv å servere enn parameterantallet på 78,1 milliarder skulle tilsi. Bare rundt 4,4 prosent av modellens parametre aktiveres for hvert token. Det kan gi bedre kapasitet per beregning, høyere gjennomstrømning og lavere inferenskostnad enn en tett modell med omtrent like mange totale parametre.
Aleph Alpha bygget faktisk en variant på 123 milliarder parametre under utviklingen. Ifølge selskapets tekniske lanseringsartikkel klarte den større varianten bare tre samtidige forespørsler med 256 000 tokens på to H100-kort. Kolibri-varianten på 78 milliarder klarte 18 og dekodet 28 prosent raskere. De valgte altså ikke den største modellen bare for å få et større tall på forsiden.
Dette er den delen av Kolibri-1 jeg liker best. Arkitekturen er valgt etter hva som faktisk kan serveres, ikke bare etter hva som ser voldsomt ut i en pressemelding. Aleph Alpha bruker også 40 lag med et lokalt oppmerksomhetsvindu på 512 tokens og bare ti lag som ser hele konteksten. Dermed vokser ikke minnebruken for KV-cache like raskt i alle 50 lag når konteksten blir lang.
Kan Kolibri-1 virkelig håndtere én million tokens?
Ja, Kolibri-1 er validert for opptil 1 048 576 tokens, men Aleph Alpha anbefaler maksimalt 262 144 tokens for krevende oppgaver og når fart eller kapasitet betyr mye. Modellen ble trent på 16 384 tokens, videreført på 65 536 og fikk en egen langkontekstfase på 262 144 tokens før valideringen ved én million.
Det skillet er viktig. En oppgitt maksimumsgrense forteller at modellen kan ta imot konteksten, men ikke at én million tokens alltid gir det beste svaret eller den beste økonomien. Jo mer tekst du legger inn, desto mer minne og tid går med. Relevant kontekst slår fremdeles en digital skuff full av alt du fant på serveren.
Kolibri-1 er likevel interessant for lange tyske og engelske dokumenter, RAG, intern kunnskap og dokumentbehandling. Den tysktrente tokenizeren gir ifølge Aleph Alpha 4,90 byte per token på tysk netttekst, mot 4,35 for GPT-5-tokenizeren i selskapets sammenligning. Det tilsvarer 11,2 prosent færre tokens for samme tyske tekst. For store dokumentmengder kan en sånn forskjell merkes både i kontekstplass og kjøretid.
Reasoning kan justeres for hver forespørsel
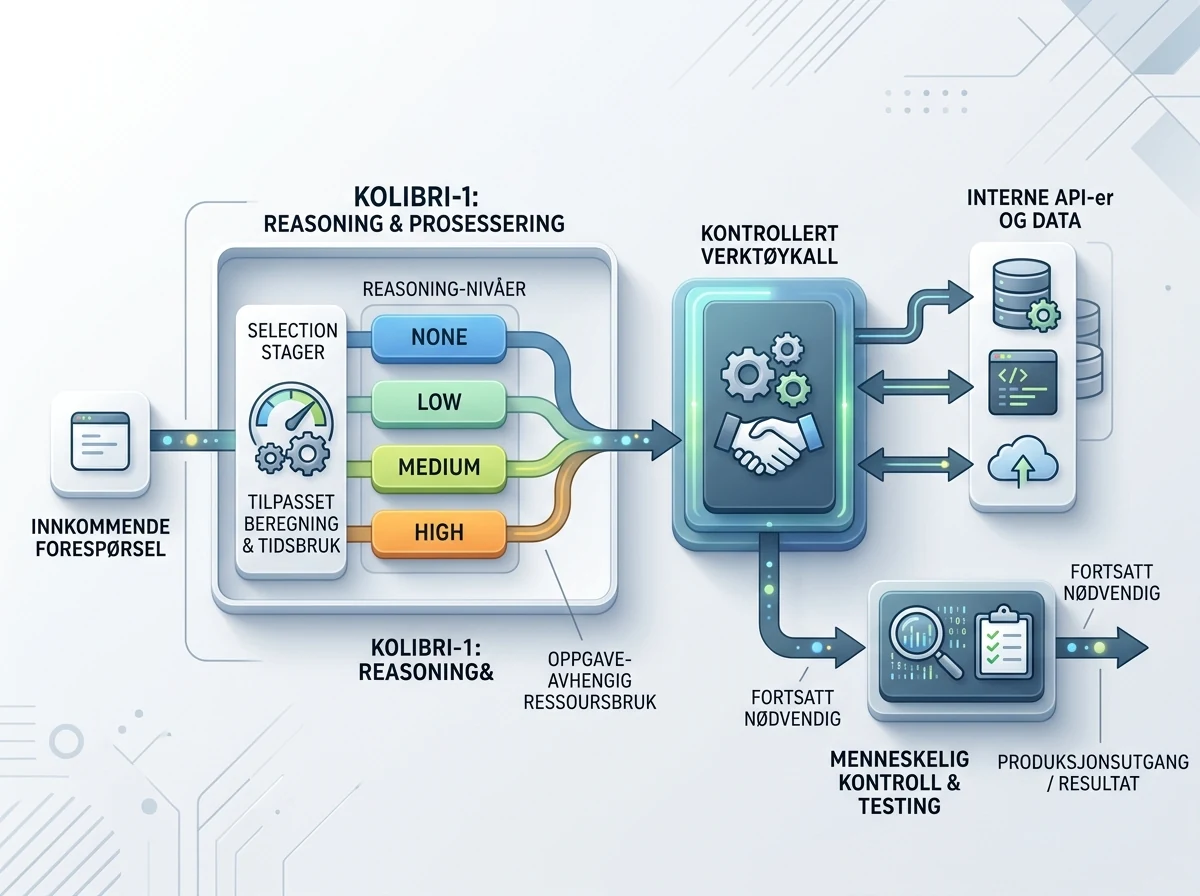
Kolibri-1 lar deg velge none, low, medium eller high som reasoning effort for hver forespørsel. Det er mer praktisk enn å tvinge alle oppgaver gjennom samme mengde intern tenking. En enkel klassifisering trenger ikke samme behandling som en vanskelig kodeoppgave eller en flertrinnsanalyse.
Innstillingen sendes gjennom chat_template_kwargs, sammen med enable_thinking. Slår du reasoning helt av, svarer modellen direkte. I en produksjonsløsning betyr dette at du kan styre tidsbruk etter oppgaven i stedet for å velge én fast modelloppførsel for alt.
Modellen støtter også strukturerte verktøykall gjennom en egen Kolibri-parser i vLLM. Det gjør den aktuell for agenter som skal søke, hente data eller kalle interne API-er. Men verktøystøtte på modellkortet er ikke det samme som en ferdig pålitelig agent. Aleph Alphas egne tall viser blant annet 61,4 på BFCL v4, mens Qwen3.5 35B-A3B fikk 70,5 i samme evalueringsoppsett. Dette må testes på de faktiske verktøyene og feilsituasjonene modellen skal møte.
Hvilken maskinvare kreves?
FP8-utgaven har et minneavtrykk på rundt 78 GB. Minimumskravet i modellkortet er to A100-kort med 80 GB, to H100 SXM5, én H200, én B200 eller én B300. Aleph Alpha anbefaler to H100 SXM5, to H200, én B200 eller én B300. BF16-utgaven dobler modellminnet til rundt 156 GB og har tilsvarende høyere krav.
Det er derfor misvisende å omtale Kolibri-1 som om den «bare» er en modell med 3,46 milliarder parametre. Aktiv parameterbruk sier noe om regnearbeidet per token. Den sier ikke at de resterende vektene kan legges igjen på Hugging Face mens modellen kjører. Hele checkpointet må være tilgjengelig, og et forbrukerkort med 24 eller 32 GB VRAM er ikke den dokumenterte veien ved lansering.
Dette gjør modellen mest aktuell for datasentre og virksomheter med eksisterende GPU-infrastruktur. De åpne vektene er likevel verdifulle. Du kan kontrollere drift, dataflyt, logging og oppdateringer selv, og Apache 2.0 gir langt friere kommersiell bruk enn mange lisenser som markedsføres som åpne. Det samme skillet er viktig for andre store modeller med åpne vekter, som GLM-5 med 744 milliarder parametre: nedlastbar betyr ikke nødvendigvis skrivebordsvennlig.
Hvordan serveres Kolibri-1?
Den dokumenterte veien går gjennom vLLM og pakken aleph-alpha-inference. Pakken installerer versjonen av vLLM som pluginen støtter. Deretter startes FP8-modellen med egne parsere for reasoning og verktøykall:
pip install 'aleph-alpha-inference>=1'


vllm serve Aleph-Alpha/Kolibri-1 --kv-cache-dtype fp8 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
Serveren eksponerer et OpenAI-kompatibelt API. Det gjør integrasjonen enklere i systemer som allerede kan snakke med et slikt endepunkt, selv om modellnavn og ekstra parametre må settes riktig. For kontekst over 262 144 tokens må serveren startes med --max-model-len 1048576 og en tilsvarende max_position_embeddings-overstyring.
Den offisielle inference-pakken på GitHub er derfor like viktig som selve vektene. Uten Kolibri-parserne mister du den dokumenterte håndteringen av reasoning og verktøykall. Det finnes heller ingen offisiell GGUF- eller Ollama-rute ved lansering. Dette er vLLM-territorium.
Hvor god er Kolibri-1?
Aleph Alphas egen evaluering plasserer Kolibri-1 sterkt blant MoE-modellene selskapet sammenligner med. Modellen får et samlet resultat på 75,5 på engelsk og 70,8 på tysk. Den gjør det også godt på kode og flere reasoning-oppgaver, men en tett Qwen3.8 27B scorer høyere samlet med 80,2 på engelsk og 79,9 på tysk.
Det betyr ikke at Kolibri-1 har mislyktes. Den tette modellen aktiverer nær åtte ganger så mange parametre per token. Hele poenget med Kolibri er å finne en bedre balanse mellom kapasitet og serveringskostnad. Samtidig bør tallene behandles som leverandørens egne målinger, selv om Aleph Alpha sier at modellene er kjørt med samme evalueringsrammeverk.
Den praktiske testen er enkel: Kjør egne tyske og engelske dokumenter, egne verktøy og egne kodeoppgaver. Mål kvalitet, tokens per sekund, tid til første token, samtidige forespørsler og faktisk GPU-minne. Modellkort er nyttig research. Det er ikke en kjøpsordre.
Jeg har tidligere skrevet om ZAYA1-8B og hvordan MoE kan gi mer kapasitet uten å aktivere hele modellen, og om Ovis2.6-80B-A3B med tre milliarder aktive parametre. Kolibri-1 følger samme hovedidé, men kombinerer den med et tydelig tysk-engelsk fokus og en mye lengre kontekst.
Hvem bør vurdere Kolibri-1?
Kolibri-1 passer best for virksomheter som arbeider mye på tysk og engelsk, har sensitiv intern dokumentasjon og allerede kan drifte kraftige GPU-servere. RAG over store dokumentarkiver, kodeassistenter, strukturert uttrekk og agenter med menneskelig kontroll er de mest nærliggende bruksområdene.
For en liten bedrift uten egen GPU-infrastruktur er dette ikke nødvendigvis den enkleste starten. Det er ingen offentlig, leverandørdrevet API-pris å sammenligne ved lansering, og drift på H200- eller B200-nivå er en helt annen øvelse enn å laste en kvantisert modell i Ollama. Åpne vekter gir kontroll, men kontroll kommer med ansvar for servering, sikkerhet, overvåking og oppgraderinger.
Likevel er retningen svært lovende. Europa trenger ikke bare flere modeller med et flagg i presentasjonen. Det trengs modeller som faktisk kan lastes ned, undersøkes, kjøres i eget miljø og brukes kommersielt på tydelige vilkår. Kolibri-1 leverer nettopp det, med et fornuftig fokus på serveringseffektivitet i stedet for ren parametergymnastikk.
Mitt råd er å teste FP8-utgaven på egne arbeidslaster hvis du allerede har riktig maskinvare eller leier den inn. Sammenlign den med en mindre MoE-modell og en tett modell, og bruk reasoning effort aktivt. Ikke velg high av gammel vane. Den beste modellen er ikke den som tenker lengst om alt, men den som løser oppgaven godt nok innenfor tiden og kapasiteten du faktisk har.
Ofte stilte spørsmål
Er Kolibri-1 open source?
Kolibri-1 har åpne modellvekter under Apache 2.0, som tillater bred kommersiell bruk og endring. Det er mest presist å kalle den en open-weight-modell, fordi åpne vekter ikke automatisk betyr at treningsdata og hele treningsprosessen er publisert.
Kan Kolibri-1 kjøres på ett skjermkort?
Ja, FP8-utgaven kan ifølge modellkortet kjøres på én H200, B200 eller B300. Den krever rundt 78 GB modellminne. Vanlige forbrukerkort med 24 eller 32 GB VRAM er derfor ikke en dokumentert én-korts løsning ved lansering.
Betyr 3,46 milliarder aktive parametre at modellen bare trenger minne som en modell med 3,46 milliarder parametre?
Nei. Tallet beskriver hvor mange parametre som brukes i beregningen for hvert token. Alle de 78,1 milliardene må fortsatt være tilgjengelige i minnet, og FP8-checkpointet bruker rundt 78 GB.
Er én million tokens den anbefalte kontekstlengden?
Nei. Kolibri-1 er validert opptil 1 048 576 tokens, men Aleph Alpha anbefaler høyst 262 144 tokens for komplekse oppgaver og når fart eller gjennomstrømning er viktig. Maksimum og anbefalt arbeidsområde er ikke det samme.