Innhold Vis
Ryktet om at Qwen 4 blir den siste åpne Qwen-serien før Alibaba går over til bare API, har fått fart igjen. Men Qwen-sjef Dayiheng Liu lovet under Apsara-konferansen 22. september at selskapet vil fortsette med open source og åpenhet.
Det er gode nyheter. Skikkelig gode nyheter, dersom Alibaba følger opp med faktiske vekter, fornuftige lisenser og modellstørrelser folk kan bruke. Qwen har blitt en viktig del av økosystemet for lokal AI, og en API-lukket fremtid ville gjort både utviklere og små bedrifter mer avhengige av én leverandør.
Samtidig er en tale ikke det samme som en modellfil. Den riktige reaksjonen er derfor både lettelse og sunn skepsis: Ta Qwen-ledelsen på ordet, og kontroller deretter hva som faktisk blir publisert når Qwen 4, Qwen 4.5 og Qwen 5 kommer.
Blir Qwen 4 en åpen modell?
I uttalelsen sa Dayiheng Liu at Qwen skal fortsette å holde fast ved open source og åpenhet. Han begrunnet det med at verdien av AI ikke bør tilhøre noen få selskaper, men være en grunnleggende kapasitet mennesker over hele verden kan få tilgang til, bruke og være med på å skape.
Uttalelsen ble løftet fram i LocalLLaMA-tråden som startet saken, der budskapet ble gjengitt som at både Qwen 4.0 og Qwen 5.0 skal fortsette å være åpne. Det er et langt tydeligere signal enn en vag formulering om å «støtte økosystemet» en gang i fremtiden.
Den bredere veikartpresentasjonen støtter retningen. 36Kr gjengir at Qwen4-27B skal prioriteres for en åpen utgivelse, og at Liu deretter slo fast at Qwen vil fortsette med open source. Det gjør det vanskelig å tolke uttalelsen som bare en høflig takk til miljøet rundt lokale modeller.
Hvorfor dette betyr mer enn enda et modellrykte
Qwen er ikke lenger en liten modellfamilie som bare interesserer en håndfull entusiaster. Ifølge tall Liu presenterte, har Qwen-serien passert 3 milliarder nedlastinger globalt. Alibaba skal ha gitt ut mer enn 460 åpne modeller, mens andre utviklere har laget over 300 000 avledede modeller.
Dette er selskapets egne økosystemtall, ikke en uavhengig revisjon. Likevel viser størrelsesordenen hvorfor ryktet om en API-lukket fremtid fikk oppmerksomhet. Når så mange verktøy, finjusteringer og lokale oppsett bygger på samme modellfamilie, blir publiseringsstrategien viktig langt utenfor Alibaba.
Jeg har tidligere skrevet en oversikt over open source AI og lokal kjøring. Hele poenget med dette økosystemet er at utvikling ikke trenger å stoppe ved døren til tre eller fire amerikanske skyløsninger. Konkurransen blir bedre når flere kan laste ned, undersøke, tilpasse og kjøre modellene på egne premisser.
Open source og åpne vekter er ikke helt det samme
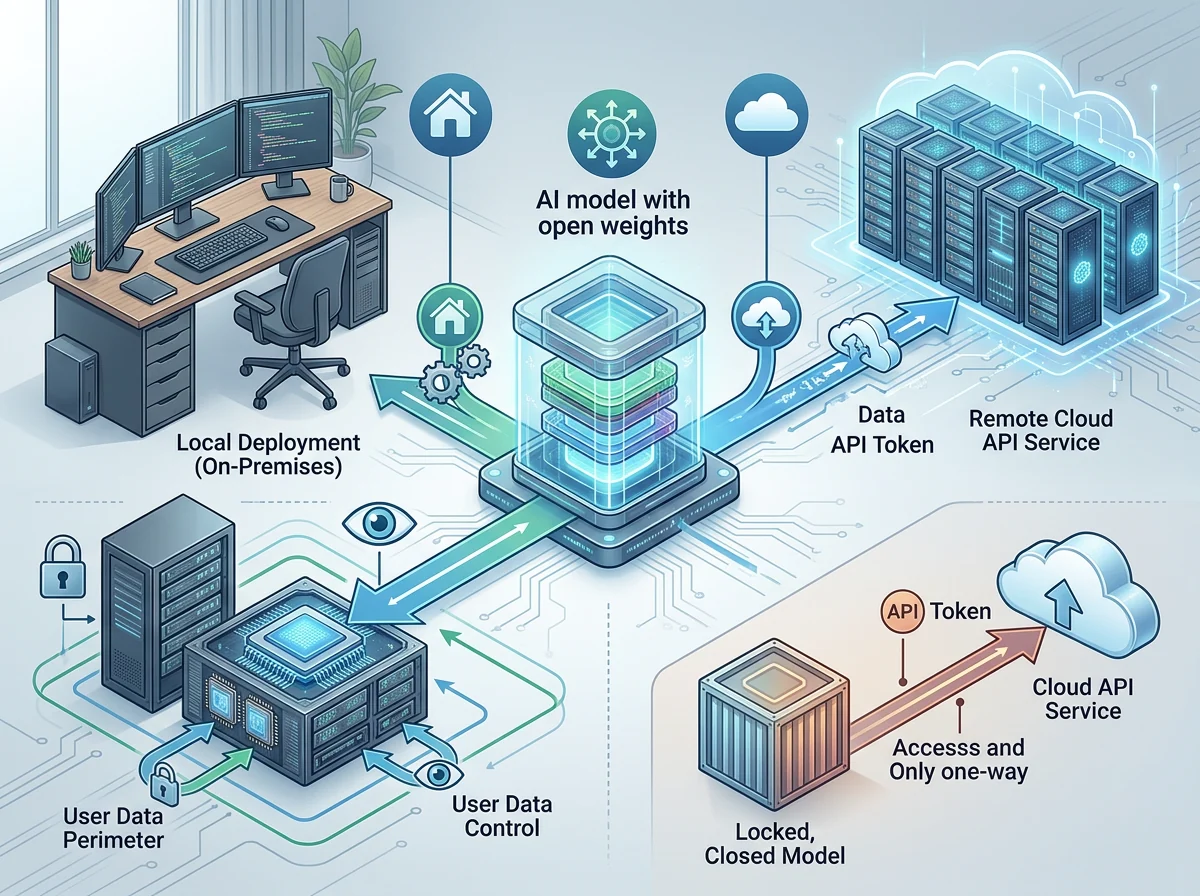
Begrepene brukes ofte om hverandre i AI-bransjen, men de beskriver ikke nødvendigvis samme grad av åpenhet. En modell med nedlastbare vekter kan kjøres lokalt, selv om treningsdataene, hele treningskoden eller oppskriften bak modellen ikke er publisert. Full open source krever mer enn en stor fil på Hugging Face.
Derfor er det for tidlig å slå fast nøyaktig hvor åpne Qwen 4 og Qwen 5 blir. Uttalelsen sier noe viktig om retningen, men den svarer ikke på hvilken lisens hver modell får, om alle størrelser publiseres, hvor lenge åpne utgivelser eventuelt kommer etter API-versjonene, eller hvor mye av treningsgrunnlaget Alibaba dokumenterer.
Det er ikke flisespikkeri. Lisensen avgjør hva en bedrift kan bygge og selge. Tilgjengelige størrelser avgjør om modellen kan kjøre på vanlig maskinvare eller bare i et datasenter. Tidspunktet avgjør om den åpne utgaven er et reelt alternativ, eller en forsinket smakebit etter at kundene allerede er låst til API-et.
Hva betyr løftet for lokal AI?
For lokal AI betyr det først og fremst at Qwen fortsatt vil være et mulig fundament, ikke bare en tjeneste man leier tilgang til. Nedlastbare vekter gir mulighet til å kjøre en modell på egen maskin eller egen server, kontrollere hvor dataene behandles og tilpasse oppsettet uten at hvert kall må gjennom leverandørens plattform.
Det er særlig relevant for utviklere og små bedrifter som trenger kostnadskontroll, privat behandling av data eller en løsning som skal fungere uten kontinuerlig nettilgang. Et API kan være både enklere og bedre for mange oppgaver, men det er noe helt annet å velge API fordi det passer best enn å være tvunget dit fordi vektene aldri ble publisert.
Valgfriheten har også en verdi over tid. En lokal løsning krever maskinvare, oppdateringer og kompetanse, mens et API flytter mye av driftsjobben til leverandøren. Med tilgang til vektene kan en bedrift sammenligne begge veier, bytte oppsett når behovene endrer seg og beholde en fungerende versjon dersom skytjenestens pris, vilkår eller modellutvalg blir endret.
Åpne modeller gir også resten av markedet noe konkret å bygge videre på. Verktøy for kvantisering, lokal inferens, finjustering og agentbruk utvikles raskere når folk faktisk får modellene i hendene. Det samme mønsteret gjorde de tidlige Llama-utgivelsene langt viktigere enn mange forsto der og da.
Qwen 4 er under trening, men detaljene er ikke ferdige
Alibabas offisielle oppsummering fra Apsara 2026 bekrefter at Qwen 4 er under trening. Selskapet presenterte også et veikart der Qwen 4.5 og Qwen 5 kan vokse til mellom 5 og 10 billioner parametere.
Det siste tallet forteller først og fremst hvor ambisiøst Alibaba tenker om de største modellene. Det sier lite om hva en vanlig utvikler vil kunne laste ned og kjøre. Her er Qwen4-27B-sporet langt mer praktisk interessant, fordi en 27-milliardersmodell i riktig kvantisering kan være innen rekkevidde for lokale oppsett på en helt annen måte enn en gigantmodell med flere billioner parametere.
Ingen av disse modellene er testet her, og det finnes heller ingen ferdig Qwen 4-utgivelse å vurdere ennå. Dette er en kildebasert nyhet om publiseringsstrategi, ikke en ytelsestest. Påstander om kvalitet, maskinvarebehov og faktisk nytte må vente til modellene og dokumentasjonen finnes.
Det er utgivelsene som teller
Qwen-ledelsen fortjener ros for å si dette så tydelig. Markedet trenger flere sterke modellfamilier med nedlastbare vekter, ikke enda en pen nettside der all kontroll ligger hos leverandøren. At en av verdens mest brukte modellfamilier lover å fortsette i åpen retning, er verdt å merke seg.
Men tillit bygges én utgivelse om gangen. Da OpenAI pensjonerte modeller og brukerne etterlyste åpne alternativer, skrev jeg om hvor sårbart det er når tilgang kan forsvinne etter en produktbeslutning. En modell du har lastet ned, forsvinner ikke fordi leverandøren rydder i menyen eller endrer abonnementet.
Det er nettopp derfor Qwen-løftet må måles i filer og lisenser. Kommer vektene? Kommer de tidsnok til å være relevante? Får utviklere bygge kommersielle produkter uten uklare begrensninger? Og kommer det størrelser som faktisk kan brukes uten et helt datasenter? Fine ord setter retningen. Leveransene avgjør om retningen er reell.
Hva bør utviklere og bedrifter følge med på?
Det første kontrollpunktet er modellkortet og lisensen for hver enkelt utgivelse. Ikke anta at hele Qwen 4-familien får samme vilkår fordi én variant blir åpen. Kontroller kommersiell bruk, krav til attribusjon, eventuelle størrelsesgrenser og om finjusterte eller avledede modeller kan distribueres.
Det andre er forholdet mellom API-lanseringen og publiseringen av vektene. En kort forsinkelse kan være praktisk nødvendig. Mange måneders venting vil derimot gjøre den åpne utgaven mindre verdifull for dem som må velge teknisk fundament mens produktet bygges.
Det tredje er hele modellutvalget. En enorm flaggskipmodell er flott for forskningsmiljøer og store aktører, men mindre modeller kan bety mer i praksis for skoler, utviklere, studenter og små bedrifter. Konkurransen fra blant annet andre åpne modellfamilier som GLM gjør det også vanskeligere å love åpenhet uten å levere.
Et løfte som er verdt å holde Alibaba fast på
Ryktet om at Qwen skulle bli API-only er ikke bekreftet. Den offentlige uttalelsen fra Qwen-ledelsen peker motsatt vei: Selskapet vil fortsette med åpne modeller, og Qwen4-27B er omtalt som en prioritert åpen utgivelse.
Det er den riktige retningen. AI blir fattigere dersom de sterkeste modellene bare kan leies gjennom lukkede endepunkter. Åpne vekter gir flere mulighet til å lære, bygge, kontrollere egne data og konkurrere med selskaper som har langt større budsjetter.
Nå gjenstår den enkle delen å si og den vanskelige delen å gjøre: Alibaba må levere. Hvis Qwen 4 og Qwen 5 kommer med reelt tilgjengelige vekter, tydelige lisenser og nyttige størrelser, kan dette bli et av de viktigste løftene for lokal AI i 2026. Inntil da er dommen positiv, men foreløpig. Jeg håper de holder ord.
Ofte stilte spørsmål
Blir Qwen 4 tilgjengelig for lokal kjøring?
Qwen-ledelsen har sagt at åpne utgivelser skal fortsette, og Qwen4-27B er omtalt som prioritert for open source. Den endelige lisensen, filstørrelsen, maskinvarekravene og publiseringsdatoen må likevel kontrolleres når modellen faktisk blir lansert.
Betyr uttalelsen at alle Qwen 5-modeller blir åpne?
Nei, ikke nødvendigvis. Uttalelsen lover fortsatt åpenhet og inkluderer Qwen 5 i retningen, men dokumenterer ikke at hver variant, størrelse og multimodale modell blir publisert med samme lisens. Hver utgivelse må vurderes separat.
Er Qwen-modellene open source eller bare open weight?
Det varierer med utgivelsen og hvordan begrepet brukes. Nedlastbare vekter er ikke automatisk full open source dersom treningsdata, komplett treningskode og metode mangler. For praktisk bruk er vektene, lisensen og retten til å distribuere avledede modeller de viktigste kontrollpunktene.
Hvorfor er åpne Qwen-modeller viktige for små bedrifter?
De kan gi små bedrifter mulighet til å kjøre AI på egen infrastruktur, kontrollere dataflyten og unngå full avhengighet av ett API. Om det lønner seg, avhenger fortsatt av modellens kvalitet, maskinvarebehov, lisens og kostnadene ved drift.